


机器人前瞻(公众号:robot_pro)
作者 | 周加琦
编辑 | 漠影
机器人前瞻10月14日报道,近日, Knowin AI、香港科技大学(广州)、香港中文大学、同济大学、清华大学、哈尔滨工业大学(深圳)、西湖大学和天津大学8家机构的39位研究者联合开展研究,发布《In-Context Learning for Robots: Methods and Applications》,系统讨论了机器人上下文学习。
机器人上下文学习(Robot In-Context Learning,Robot ICL)旨在让机器人利用少量示范与现场指导,以few-shot transfer learning的方式将已有能力迁移到新的任务与工况,实现快速部署。
研究团队将分散在策略学习、几何迁移、世界模型与机器人智能体中的路线,按“上下文怎样变成控制”组织起来,覆盖操作(Manipulation)与导航(Navigation)。
arXiv链接:https://arxiv.org/abs/2609.36012
项目主页:https://jethrojames.github.io/awesome-robots-icl/
文献库:https://github.com/JethroJames/awesome-robots-icl
一、少量教导,怎样帮助机器人适应新任务
综述用零件配套说明这一差别。机器人已经会拿取板件和轴套,新要求是先放板件、再放轴套。桌面图像提供了物体位置,操作顺序则由示范交代。
基础动作可以复用,新增的是这次任务的要求。Robot ICL及相关快速适应方法将现场信息用于决策,让机器人依据新的教导调整行为。
实现这种适应,可以直接把教导作为上下文,也可以通过测试时训练(Test-Time Training,TTT)更新快权重或轻量记忆。RoboTTT(Test-Time-Training Robot Policies)与 WAM-TTT展示了后一种方向。此前训练形成的感知、抓取等基础能力,则为这些快速适应机制提供支撑。
“板件先放”改变的是顺序;“刚才插不进去”可能意味着接触或施力需要调整。任务教导说明要做什么,交互反馈说明怎样做得成,两类信息可以在执行中配合。
二、从“看懂”到“做成”,有四条技术路线
一段示范进入系统之后,可能直接影响动作,也可能先变成运动参考、未来预测或技能程序。综述的四类方法(Taxonomy),正是沿着这些从上下文到控制的路径划分。
这些方法可以组合使用。例如,世界模型预测动作后果,智能体安排步骤,几何迁移将接触参考对齐到新对象。分析组合系统时,要看同一项要求如何从教导传到各个执行环节。
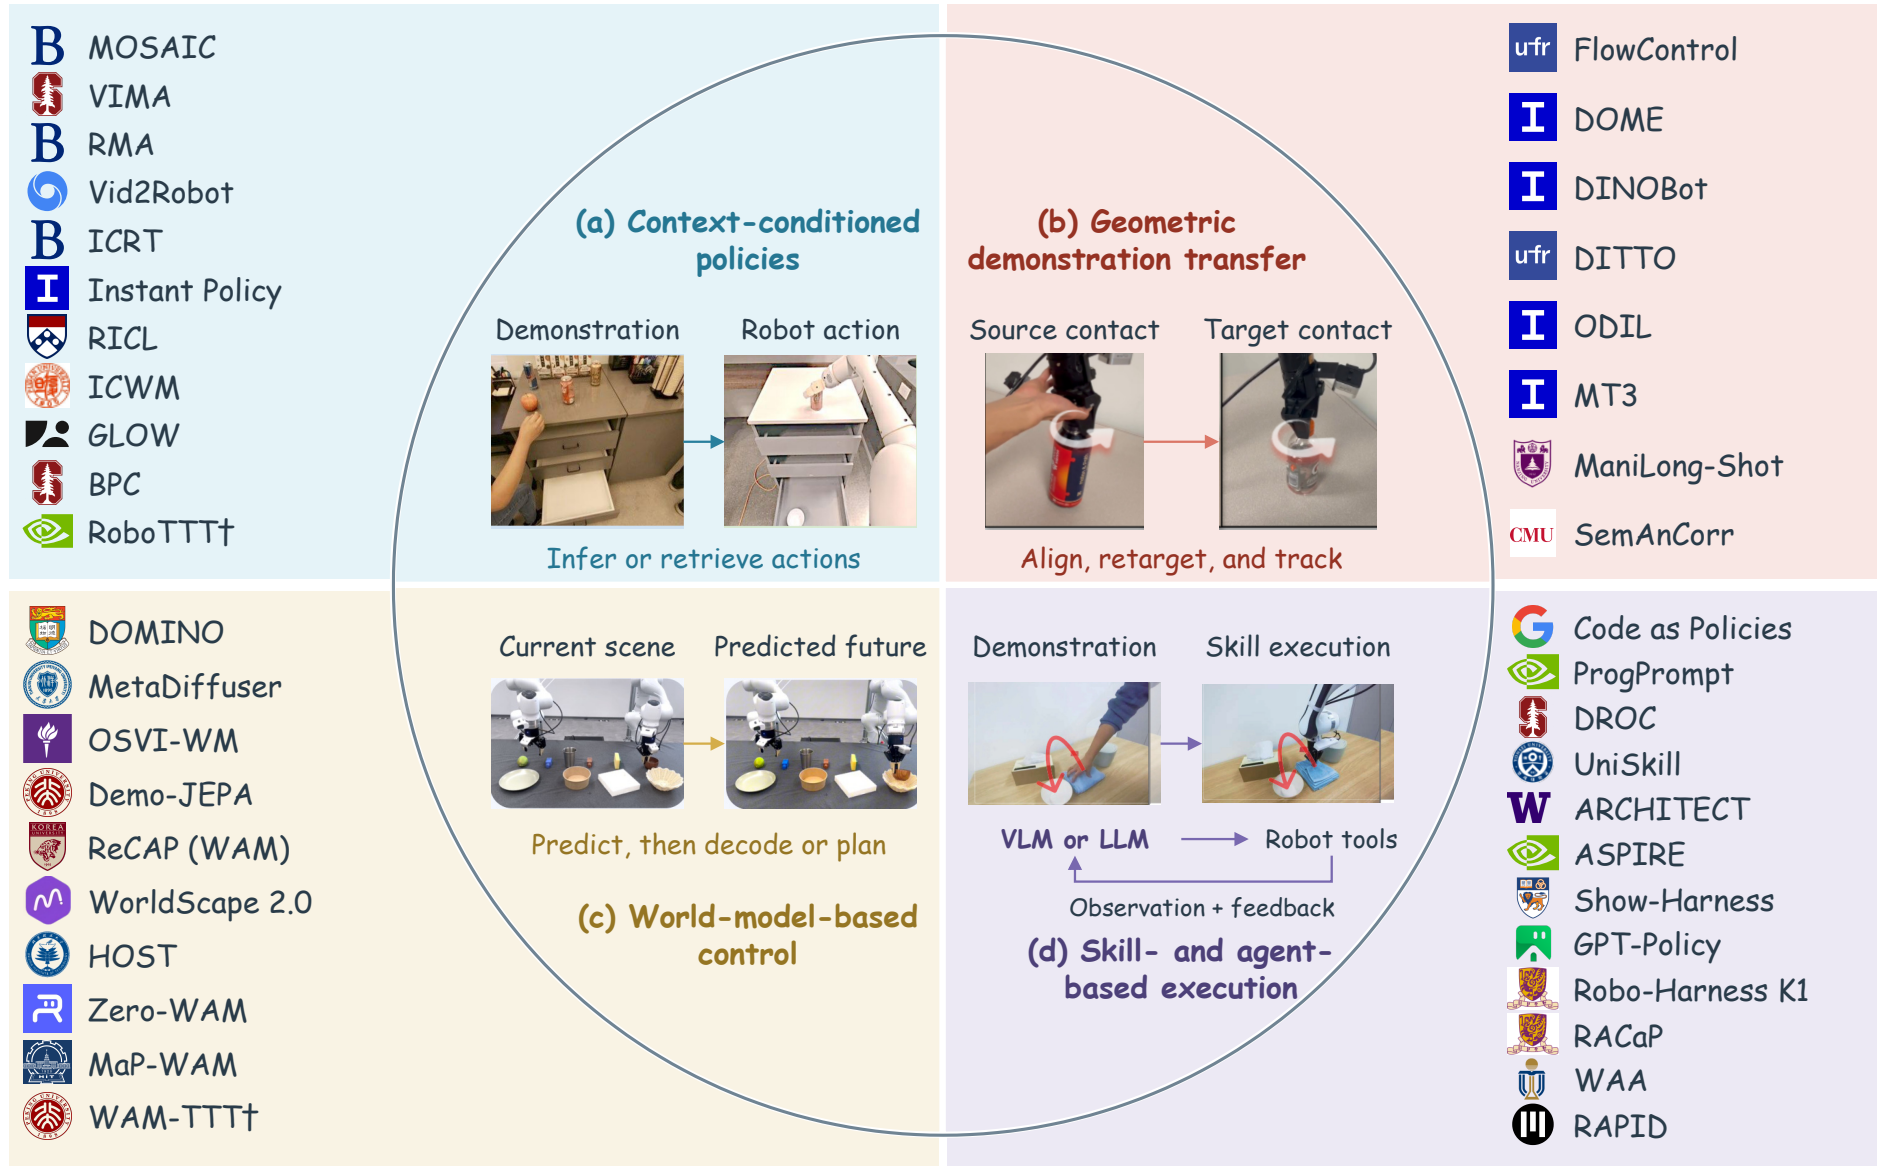
▲四类方法及代表工作:动作推断、几何迁移、未来预测、技能与智能体执行
1. 直接生成动作:上下文条件策略(Context-conditioned policies)
上下文条件策略,是让示范、指令和执行历史参与决策,结合当前场景直接生成或复用动作的方法。它延续模仿学习“看场景、出动作”的框架,但示范从训练材料变成了执行时可读取的教导。技术重点也从认出“这是什么任务”,转向弄清“示范教了哪些步骤,现在该做哪一步”。
为此,策略需要把示范与现场对应起来。Vid2Robot用交叉注意力关联人类视频和机器人画面,ICRT(In-Context Robot Transformer)将示范与执行历史组织为序列;Instant Policy则用几何图建立空间关系。示范表征由整体任务标签细化到步骤与空间对应,让教过的细节参与当前动作。
基础模型使教导与通用动作能力进一步分工。Knowin AI的GLOW(Generative Learning of World)把人类视频编码为Reusable Skill Context,再结合现场生成动作;长任务中的 RoboTTT则在推理时通过梯度更新快权重,将上下文扩展到8K时间步。一个着眼于把教导变成可复用的技能条件,一个着眼于持续保留长时序经验,推动策略从“知道要做什么”走向“按教过的要求一直做下去”。
2. 把运动对齐到新场景:几何示范迁移(Geometric demonstration transfer)
几何示范迁移,是将示范中的运动或接触参考对齐到新场景,再交给控制器执行的方法。它承接视觉伺服、动作重放和运动重定向的技术脉络:先找回成功交互依赖的空间关系,再调整运动。对齐因而聚焦于任务实际涉及的对象、部位及其相对关系。
从动作重放出发,DINOBot先检索示范、对齐腕部视角,再复用交互。要从人类视频中学习,就需要跨过人手与夹爪的差别。DITTO(Demonstration Imitation by Trajectory Transformation)改为从单段RGB-D(Red-Green-Blue-Depth)示范中提取物体相对轨迹,迁到机器人现场后再规划抓取和运动。身体可以不同,物体之间的相对运动仍可复现。
当变化延伸到物体形状,对齐就要深入到接触部位。SemAnCorr(Semantic Anchored Correspondence)通过语义表面锚点迁移接触区域和局部坐标系,让新形状上的相应部位承担原来的交互作用。长任务还要随阶段切换参照:拿取对齐零件,插入对齐孔位。从重放轨迹到保留物体关系、再到迁移功能接触,这条路线逐步把“照着动”变成“在新几何下实现同样的交互”。
3. 先推演接下来会怎样:世界模型控制(World-model-based control)
世界模型控制,是根据上下文预测未来观测、状态或变化,再依据预测规划、选择或生成动作的方法。它保留了基于模型的控制“先推演后执行”的思路,又把教导纳入推演:除了预测动作后果,还要从示范中确定这次任务应当怎样推进。
未来状态为人类示范与机器人动作提供了中间表示。Zero-WAM结合人类视频和机器人当前观测、历史,预测后续机器人画面,再通过学习到的动作分支连接控制;Demo-JEPA(Joint-Embedding Predictive Architecture)则预测潜在目标,交给Cross-Entropy Method(CEM)规划器依据学得的动力学搜索动作。一个学习预测与动作的映射,一个在线规划怎样到达目标,都让机器人用自身能力实现示范指向的变化。
这一转变把问题从“动作会产生什么结果”,扩展到“教导要求哪一种未来”。同一张桌面,示范改变了放置顺序,预测就应随之改变。Zero-WAM用上下文未来片段预测学习这种依赖,执行新任务时参数保持固定,新示范通过改变预测影响动作。预测能否保留教过的过程、又能否转成可执行的动作,共同决定了这条路线的迁移能力。
4. 调用已有技能:技能与智能体执行(Skill- and agent-based execution)
技能与智能体执行,是把教导转成带参数的技能、程序或工具调用,再交给已有执行器完成动作的方法。它从任务分解与技能组合发展而来,把新任务的安排与底层运动分开。UniSkill就从人类示范中推断技能序列,让机器人侧策略实现每项操作。
语言模型加入后,组合的对象从动作顺序扩展到完整的操作流程。Code as Policies、ProgPrompt将感知、条件判断和控制写入程序;RACaP(Reasoning, Acting, and Coding as Policies)则把操作封装为策略API(Application Programming Interface),让智能体根据记忆和现场反馈选择接口、填写参数并安排恢复。接口代码预先生成,执行时变化的是如何使用这些能力。
任务安排还要落实到物体和位置,工具因此进一步覆盖感知与执行前检查。Robo-Harness K1让智能体查询深度、空间关系、视觉锚点和抓取候选;WAA(World Action Agent)将候选位姿显示出来,结合运动学规划反馈修正,并能向Skill Agent查询示范中的步骤与完成条件。技能编排因而成为一个持续观察、调用和修订的过程,机器人根据现场结果决定怎样继续完成教导交代的任务。
三、改一个要求,为什么会牵动整项任务
让教过的要求一直影响行动,是四条路线共有的难点。训练阶段要建立示范与正确执行之间的联系,部署阶段则要处理新增要求、现场变化和记忆更新。
训练时,怎样学会根据教导选择动作
训练时,模型需要看到“怎样教”和“怎样做”之间的对应。例如,把“先板件、后轴套”的教学视频与遵循这一顺序的执行轨迹配成一组,再为相反顺序组织另一组。虽然两组都在“装好一份零件”,示范给出的顺序不同,正确动作也随之改变。这样组织数据,才为模型提供了根据教导选择动作的训练信号。
配对说明每段教导对应怎样的执行,任务多样性则决定训练中覆盖了多少种不同要求。
BPP(Behavior Prompting Policy)的绘图实验比较了后一件事:训练示范总量同为10,000 条,覆盖500个任务、每个任务20条时,平均Chamfer误差为9.5像素;覆盖2,000个任务、每个任务5条时,降至3.4像素。
这个指标越小,表示绘图结果越接近目标图形。在这项实验中,同样数量的训练数据覆盖更多任务,带来了更好的绘图表现。
这一结果提示,固定采数预算下,任务覆盖范围值得与单任务示范密度一起设计。模型既要看见足够丰富的要求,也要得到教导与执行之间清楚的对应。
部署时,怎样保留要求并适应变化
到了部署阶段,这种能力要体现为对具体要求的组合与修订。图中用零件配套示意:示范教了先放板件,新指令又指定两块板件、三个轴套。机器人需要把教过的顺序与新增数量合在一起执行。
图(b)中,操作者只说“改用托盘 B”。正确的修改范围是目的地,原先的数量和先后顺序仍然有效。图(c)留下了两个可选托盘,则要求机器人先弄清目标,再沿用已教过的步骤。
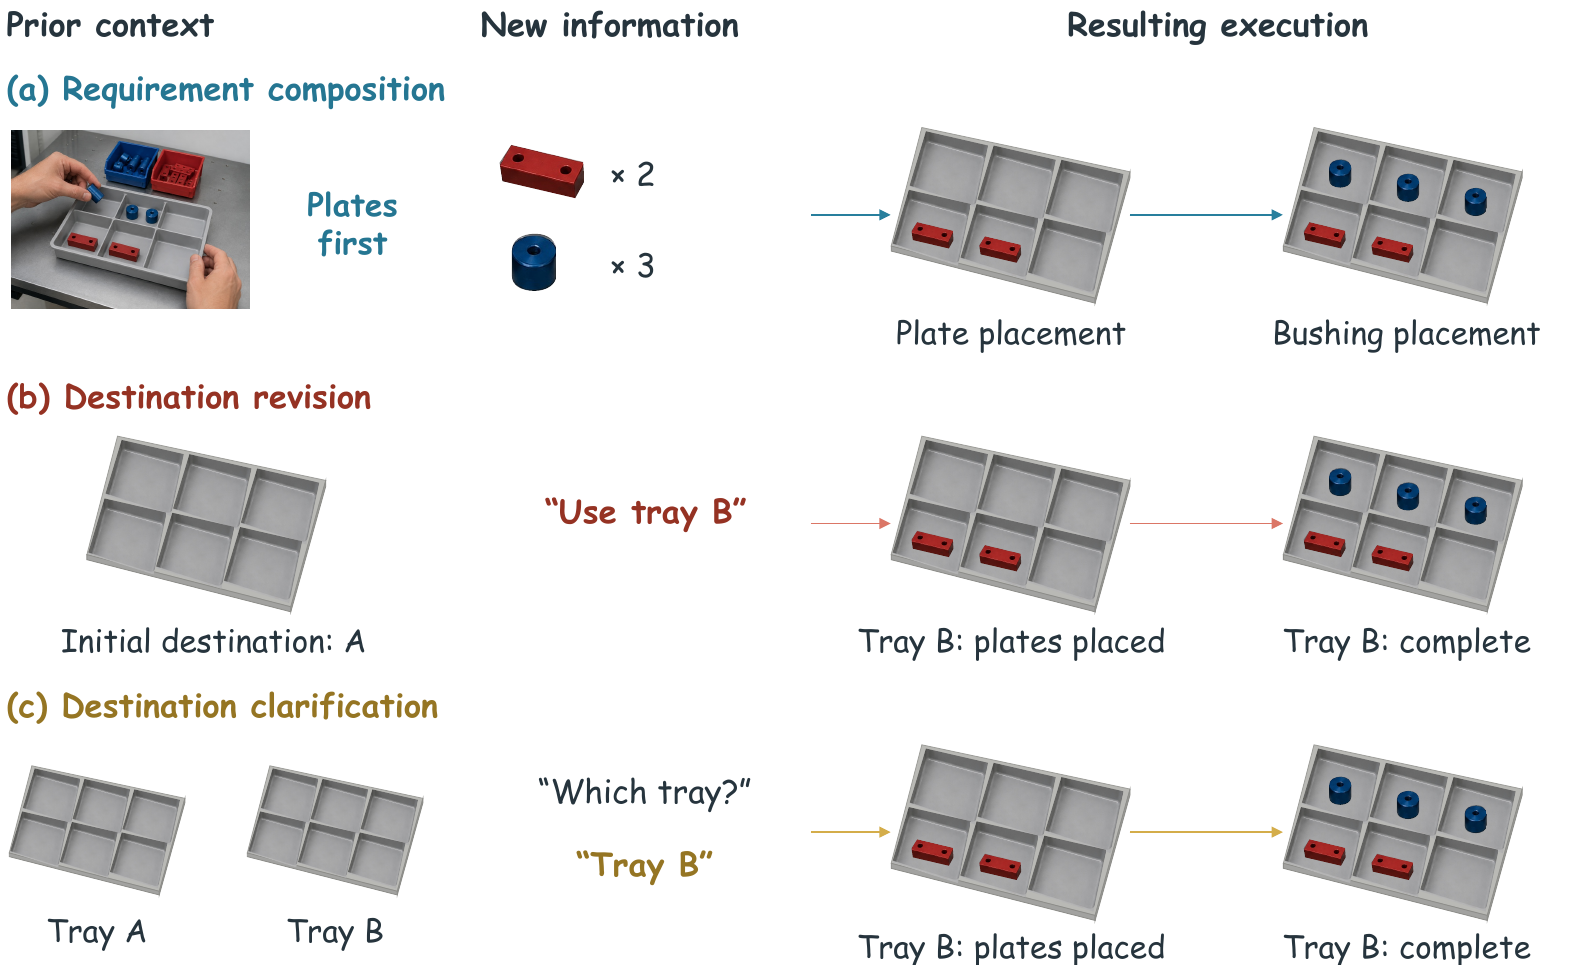
▲零件配套中的任务教导示意:组合顺序与数量、只修改目的地,以及先澄清目的地
这里的对应关系(Correspondence)负责把教导中的对象、接触和步骤映射到新场景,记忆(Memory)则保存任务要求并更新现场信息。托盘移动了,坐标随之更新;“板件先放”的工艺顺序继续保留。
更换物体和导航也遵循同样的逻辑。“把液体倒入容器”可以接受不同形状的容器,“握住把手”则要求新对象仍有可用把手。路线可以随障碍变化,但教导指定的地标仍须经过。动作随现场调整,任务要求的关系继续保留。
四、怎样判断机器人真正用上了教导
评价新教导的作用,可以分别改变教导和场景。前者检验行为是否响应新要求,后者检验原有要求能否在变化后继续成立。
保持桌面不变,只修改示范中的目标或顺序,观察动作是否随之调整,并与没有示范时的表现对照。
保持要求不变,替换物体或调整布局,观察机器人能否改变运动,同时保留数量、顺序与接触关系。
人工投入也应计入结果。成功率接近的两套系统,可能需要不同次数的示范、纠正与接管。重试和等待时间同样影响现场使用的成本。
图中将两种测试并排呈现:上排保持机器人场景不变,改变示范,观察UniSkill的未来预测如何响应;下排通过LIBERO-PRO评测基准的物体替换考察目标选择。结合实际执行成功率,可以进一步分析预测和目标选择如何影响任务完成。
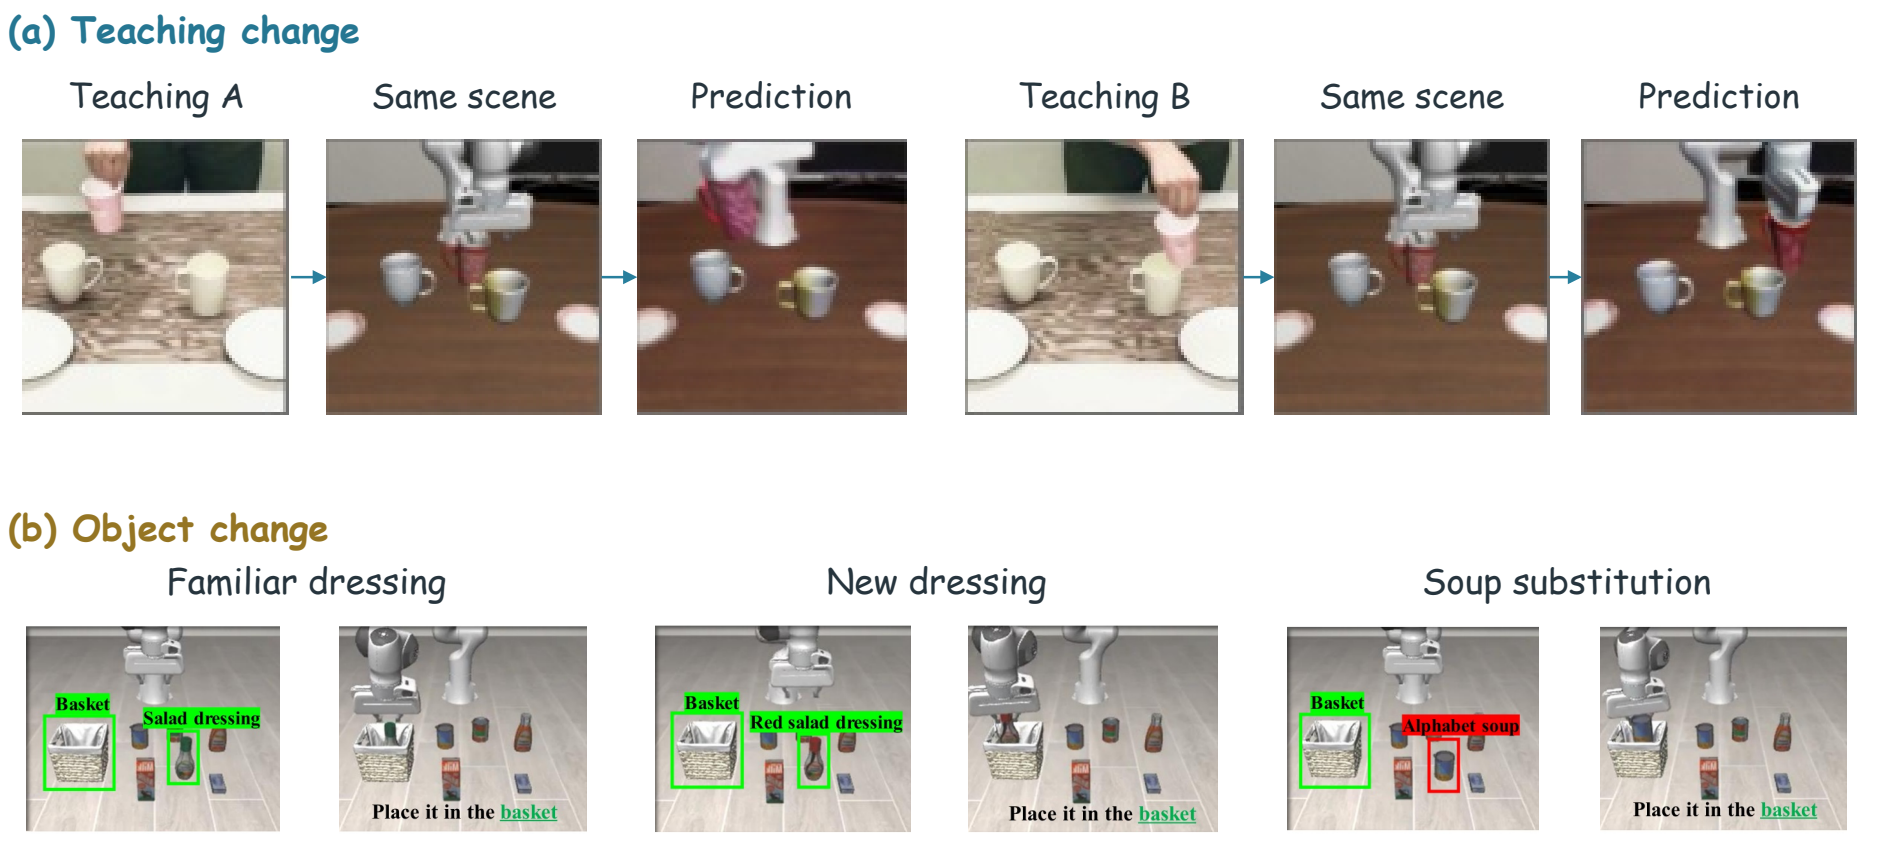
▲改变教导与替换物体,分别检查不同的迁移能力:上排结果列为未来预测、下排为目标选择测试
五、走向更复杂的任务,Robot ICL 还缺哪些突破
综述第8章的未来研究讨论,把重点放在可迁移的任务理解上。RoboCoach对应有效教导,研究怎样用示范和反馈帮助机器人理解新要求;RoboRSI对应机器人递归自我改进(Robot Recursive Self-Improvement),研究怎样从执行经验中改进后续学习。两者都依赖下图中的关系学习、步骤组合、物理迁移与纠正反馈。
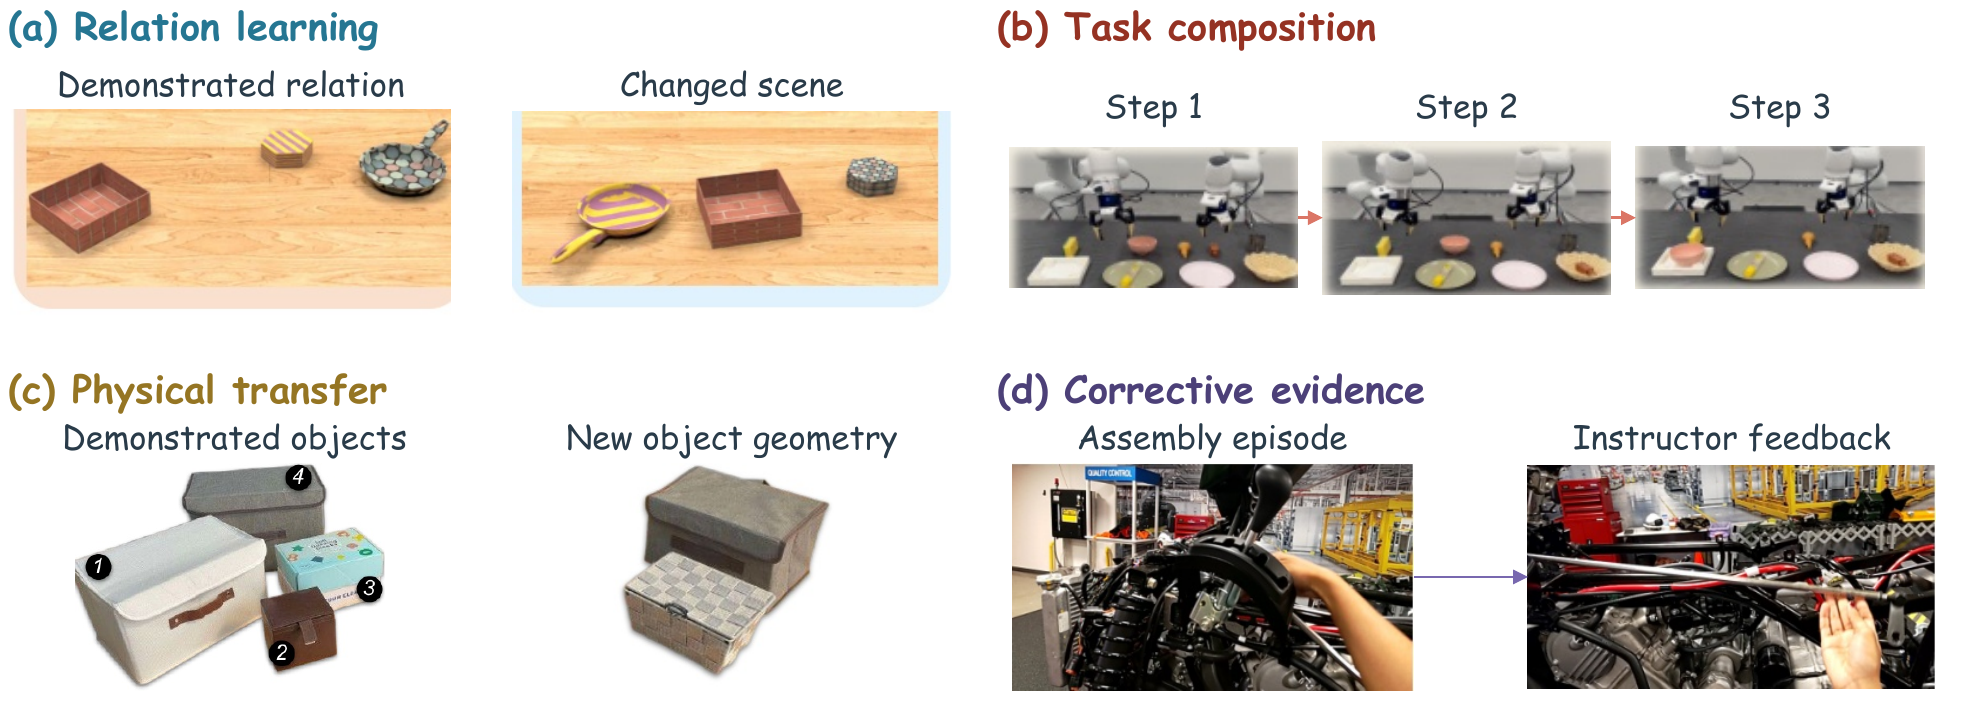
▲面向可迁移任务理解的研究方向:从示范中学习关系,组合任务步骤,跨物理变化保留功能,并通过纠正反馈改善后续执行
从识别熟悉任务,到推断新的规则
从识别熟悉任务走向新的规则推断,是Robot ICL要跨越的一步。示范既可以帮助机器人选中已知料箱,也可以交代此前未见过的尺寸与槽位关系。Rule inference(规则推断)研究怎样从几个例子中学出这种关系,再把它用于未演示的物体。
按单分拣和零件配套经常需要这种能力。新订单改变分类规则或步骤组合,拿取与放置等基本动作可以继续使用。评测时,将这些关系留到现场示范中交代,观察机器人如何根据新规则处理任务。
RoboCoach:把关键要求教清楚,让机器人少走弯路
RoboCoach将重点放在教导的质量上。一段演示里,哪些是工艺要求,哪些只是操作者的习惯,机器人需要分得清。先放板件再放轴套,既可能是规定,也可能只是当时的选择。一句“板件必须先放”或一次针对顺序的纠正,就能补上视频没有说清的要求。
机器人也应能主动询问。目标明确但顺序不清时,问清顺序就够了;不知道怎样接触物体时,请操作者补演关键动作更有用。系统需要判断当前缺少哪一类信息,把回答用于相关步骤,同时保留已经明确的要求。教学由此可以集中在新任务的差异上。
柔性装配与实验室辅助尤其依赖现场经验。熟练操作人员知道哪一步容易出错、哪处接触不能省略,教学界面要让这些知识容易表达,学习机制则要让它们能被复用。对象或步骤组合变化之后所需的补教次数,可以用来衡量这些经验帮助新任务的程度。
跨物体与跨具身迁移,保留真正重要的关系
Physical grounding(物理落地)把教导中的关系与实际交互联系起来。倒液体依赖容器的盛装功能,握把手依赖可用的接触部位,装配中的停顿则可能是在等待材料固化。机器人结合形状、功能和动作后果理解这些细节,再决定怎样在新场景中实现相同的交互。
多型号零件装配、工具使用和不同机械臂之间的技能迁移,都需要将任务关系与新的运动方式衔接起来。机器人沿用教过的要求,通过规划或学习适应新的身体和材料。评测可同时记录任务要求的保持情况、动作完成情况,以及适应过程消耗的交互和训练投入。
长期记忆,要记住教导,也要更新旧经验
Memory要分开管理规则和状态。“板件先放”可以跨批次沿用,上一批是否完成则需要重置。用户习惯可长期保存,临时要求只对当前任务生效。压缩历史时,还要留下关键事件的证据,供后来出现的纠正重新解释。
家庭服务、移动取送和中断后继续执行的操作,都需要这种记忆。物品换了位置,位置记录要更新;流程没有改动,原有约束继续使用。任务切换、布局变化和延迟纠正,要求记忆系统在更新现场信息的同时,持续保留有效的教导。
RoboRSI:把执行中的反思,变成下一次的举一反三
RoboRSI将学习延伸到执行之后。教导记录了要求,动作和结果记录了实际发生的事。两者的偏差提供了反思的依据,帮助机器人修正理解,并改进下一次学习新任务的方式。
例如,零件数量放对了,顺序却错了。对照中间步骤和教导,可以发现被忽略的先后关系。进一步的改进,是让机器人在接受新任务时主动检查步骤依赖,执行时核对关键结果。经验于是从“这次板件先放”,发展为处理新任务时也能使用的检查方法。
经验可以保存在上下文、程序或参数中,并带上适用条件和执行证据。新要求到来时,系统据此决定沿用还是修订。后续可以用未练过的任务所需的示范、纠正和试验次数衡量这种积累,并观察已有能力的保持情况。
教导给反思提供依据,反思又帮助机器人决定下次该关注什么、何时向人求助。多工位协作可以进一步研究经验共享:各工位按自己的身体与现场条件验证、调整其他工位积累的经验,减少重复摸索。对企业而言,这意味着新任务的交付有机会受益于过去已经做过的工作。
六、面向企业的机器人,能否从定制开发走向现场教会
面向企业(To Business,ToB)的部署,是Robot ICL一个直接的应用切口。企业频繁更换零件、订单和流程,机器人已有的动作能力却往往仍然可用。让这些变化通过现场教导进入执行,有望减少为每种场景开发专用版本的工作。
变的是机器人接受新任务的方式
依赖场景微调时,新需求通常要经过采数、训练和验证。现场教学则利用已有动作能力,由熟悉工艺的人示范变化、说明要求,再根据执行偏差补充纠正。任务交接更多地发生在人与机器人的交互中。
“这一面朝上”“先放板件”,以及必须保留的接触与等待,都属于现场教学要传递的工艺要求。操作人员通过示范和说明交代这些细节,机器人再结合当前几何与执行反馈安排动作。
关键上下文,才是现场教学的重点
教导最有用的部分,是新任务与已有经验之间的差异。托盘移了,需要换路径;只改数量,原有顺序仍然有效。图中,上次纠正的“板件先放”被用于新布局,机器人据此重新组织动作。一次教学能否持续减少后续指导,直接关系到重复部署的成本。
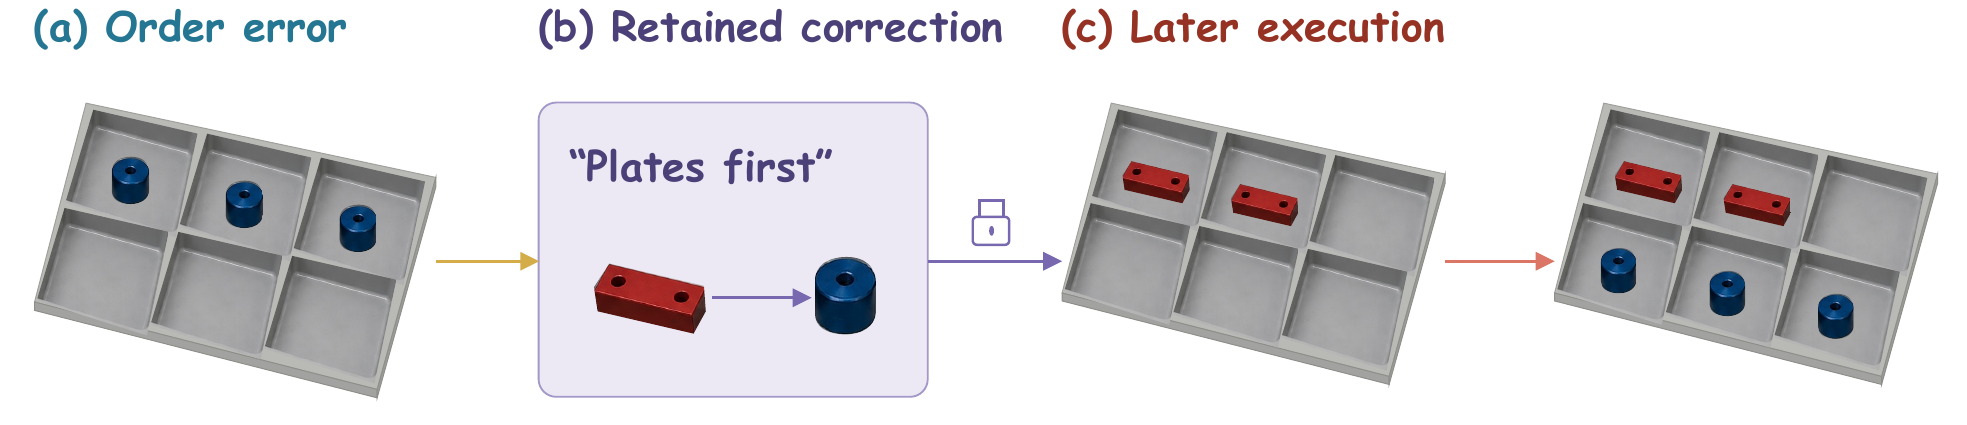
▲纠正信息复用的机制示意:固定策略保存“板件先放”的反馈,再结合新布局完成配套;中间托盘状态呈现零件的放置顺序
产品需要让这些修改容易操作。现场人员应能检查机器人理解的要求,指出出错的部分,并看到纠正后的执行结果。系统则负责保留通用工艺规则、更新本次订单和场景信息,并针对尚未明确的要求向操作者提问。
企业真正要算的,是再部署一个场景有多贵
现场教导为厂商和集成商提供了一种交付思路:在策略之外,将可复用的教学与验证流程一并交给客户。客户换单时补教变化的部分,让已经积累的工艺经验继续发挥作用。
小批量、多品种业务最容易受到重复开发成本的影响。评估这类部署,需要从提出新要求算到连续合格执行,把教学、试验、人工接管和返工一起计入。
基础训练提供感知、控制和理解教导的能力,现场指导交代本次任务。业务扩展到超出现有能力的新材料、工具或动作时,再通过相应数据与训练掌握新增能力。这种分工让已有经验持续复用,新增工作集中在真正变化的地方。
下一张订单到来时,现场人员可以把变化教清楚,验证后继续生产,这是Robot ICL希望带来的部署方式。机器人越能从已有指导和经验中受益,企业就越少需要为相似任务反复开发。
结语:让机器人具备持续学习新任务的能力
这项综述系统梳理了机器人上下文学习的主要技术路线,也为机器人如何进一步提升任务适应能力提供了研究参考。
随着机器人基础模型能力不断提升,机器人需要掌握的将不再只是训练阶段学到的固定技能,而是能够在实际使用过程中不断理解新要求、积累新经验,并将已有能力应用到更多任务中。
某种程度上,机器人不仅要成为熟练的“执行者”,还要成为一个能听懂教导、举一反三、不断进步的“好学生”。Robot ICL为这一方向提供了新的技术路径,也让机器人的学习能力成为值得关注的竞争维度。
未来,随着相关技术不断成熟,机器人有望以更灵活的方式应对不同任务需求,进一步拓宽在工业制造、商业服务等场景中的应用空间。
