


机器人前瞻(公众号:robot_pro)
作者 | 许丽思
编辑 | 漠影
机器人前瞻10月16日报道,这两天,两家机器人公司接连展示了AI Agent在机器人领域的新进展。
一边,MicroFactory利用Opus、Astra等通用大模型,让两台机械臂连续1.5小时自主装配电子产品,全程零错误,甚至完成了团队原本认为无法全部自动化的操作。
另一边,Poke & Wiggle让Claude做起了具身研究的活,自主阅读论文、编写算法、训练模型,再调用真实机器人开展测试。其团队累计完成超过6000次真机测试,尝试复现10篇机器人研究论文的核心结论。
这两项进展,其实也是通用大模型影响机器人领域的两条重要路径:一是直接参与机器人的任务决策与执行,二是成为具身研究员,参与机器人控制方法的研发、验证与改进。
通用大模型,正在显露出改变具身智能行业的研发与迭代节奏的迹象。
过去,机器人行业一直在想办法造出更聪明的AI大脑,现在,一个新的可能性正在出现:推动下一代机器人大脑进化的,或许正是通用大模型自己。
一、弃用VLA、全量改用LLM,机器人1.5小时零错误装配
MicroFactory是美国一家开发模块化机器人制造单元的公司,主要面向电子产品组装等多品种、小批量制造场景。
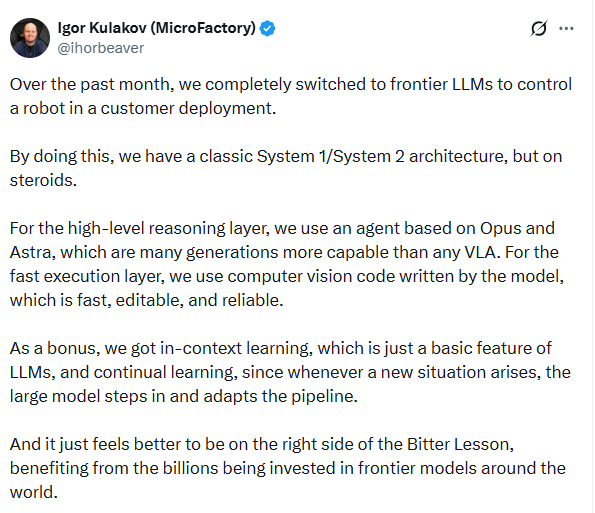
今天,MicroFactory创始人Igor Kulakov透露,过去一个月,该公司在一项客户部署中,已经弃用VLA,全面转向使用通用大语言模型控制机器人。
在公开的视频中,两台机械臂在一个封闭式工作单元内协同作业,抓取不同零件,并将它们组装成客户的电子产品。
Kulakov称,机器人在测试中连续自主运行1.5小时,并且没有出错。
更令团队意外的是,最初他们预计只能自动化其中90%的操作,但最终实现了全部操作的自动化,而且没有更换原有的灵巧夹爪。

不过,Kulakov也提到,如果使用吸盘,部分操作可能更加快速、简单。
1、打造一个增强版的System 1/System 2架构
这背后的关键,是通用大模型与传统机器人控制程序的分工,Kulakov将这套方案形容为一个增强版的System 1/System 2架构。
其中,高层推理主要由基于Opus和Astra的AI Agent负责,承担任务理解、算法选择和代码开发等工作;针对快速执行层,则可以交给模型编写的计算机视觉程序,这些程序运行速度快、易于修改、可靠性高。
此外,这套架构还带来了两项额外能力:
一是上下文学习(In-context Learning),这是大模型本身具备的一项基础能力,使系统能够利用当前上下文中的信息适应任务。
二是持续学习(Continual Learning),每当遇到新的情况时,大模型便会介入,根据新情况调整和优化整个处理流程,使系统能够持续适应新的任务需求。
2、驱动机器人完成整理零件、高精度插装等任务
在演示中,MicroFactory展示了这项电子产品组装设计的几项具体的机器人操作。
首先,是从随机堆放的零件中取出目标物体,并调整到正确朝向。对于这类任务,机器人不仅需要识别目标,还要解决零件朝向不一致的问题。
MicroFactory采用的方法,是在工作区域增加一个辅助平台。机器人先从零件堆中抓取物体,将其放到平台上,必要时翻转零件,再以正确的朝向重新抓取。

针对高精度插装,在装配过程中,机械臂抓取零件后,还需要精确调整位置,才能将其插入对应部位。
MicroFactory让大模型编写代码,收集一个小数据集,再利用这些数据训练一个线性回归模型。该模型根据视觉反馈修正零件的位置,使机械臂在插装前完成更精确的对齐。
这意味着,通用大模型不仅能够生成控制代码,还能够组织简单的数据采集和模型训练,为特定操作建立辅助算法。

针对螺丝抓取的操作,Kulakov表示,机器人原本也可以采用类似零件翻转的方法抓取螺丝,但考虑实际效率,团队最终选择使用一台价格仅300美元的自动螺丝供料器。

不过,Kulakov也承认,当前基于代码的控制方式更适合受约束环境中的重复性任务,尚不适用于家庭清洁等非重复性、非结构化的工作。
对于需要根据环境变化不断重新决策的任务,直接调用大模型控制机器人仍然存在速度等方面的限制。
所以,MicroFactory此次展示的进展,并不是通用大模型已经具备全场景机器人控制能力,而是通过代码生成、简单模型训练与现有硬件结合,开始承担一些机器人系统集成和任务开发工作。
二、Claude开始搞机器人科研,6000多次真机实验验证10篇论文
除了实际控制机器人,通用大模型还开始像一个研究员一样,承担机器人科研工作。
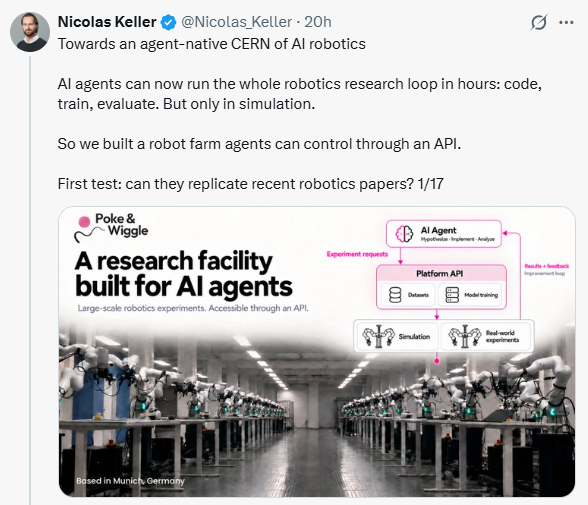
10月14日,机器人公司Poke & Wiggle公布最新成果:该公司利用Claude Opus 5.5,让AI Agent尝试复现10篇近期机器人研究论文的核心结论,累计完成超过6000次真实机器人测试。
根据公司联合创始人Nicolas Keller披露的结果,部分论文的核心结论成功复现,部分方法的实际效果低于原论文报告,还有一些方法未能在其机器人平台上复现。
1、从读论文到真机实验,AI接手完整的机器人科研流程
为了让AI自主开展研究,Poke & Wiggle在德国慕尼黑建设了一座机器人实验场,并通过自研Poker平台,将数据采集、模型训练和真机评测等功能封装为标准化API。

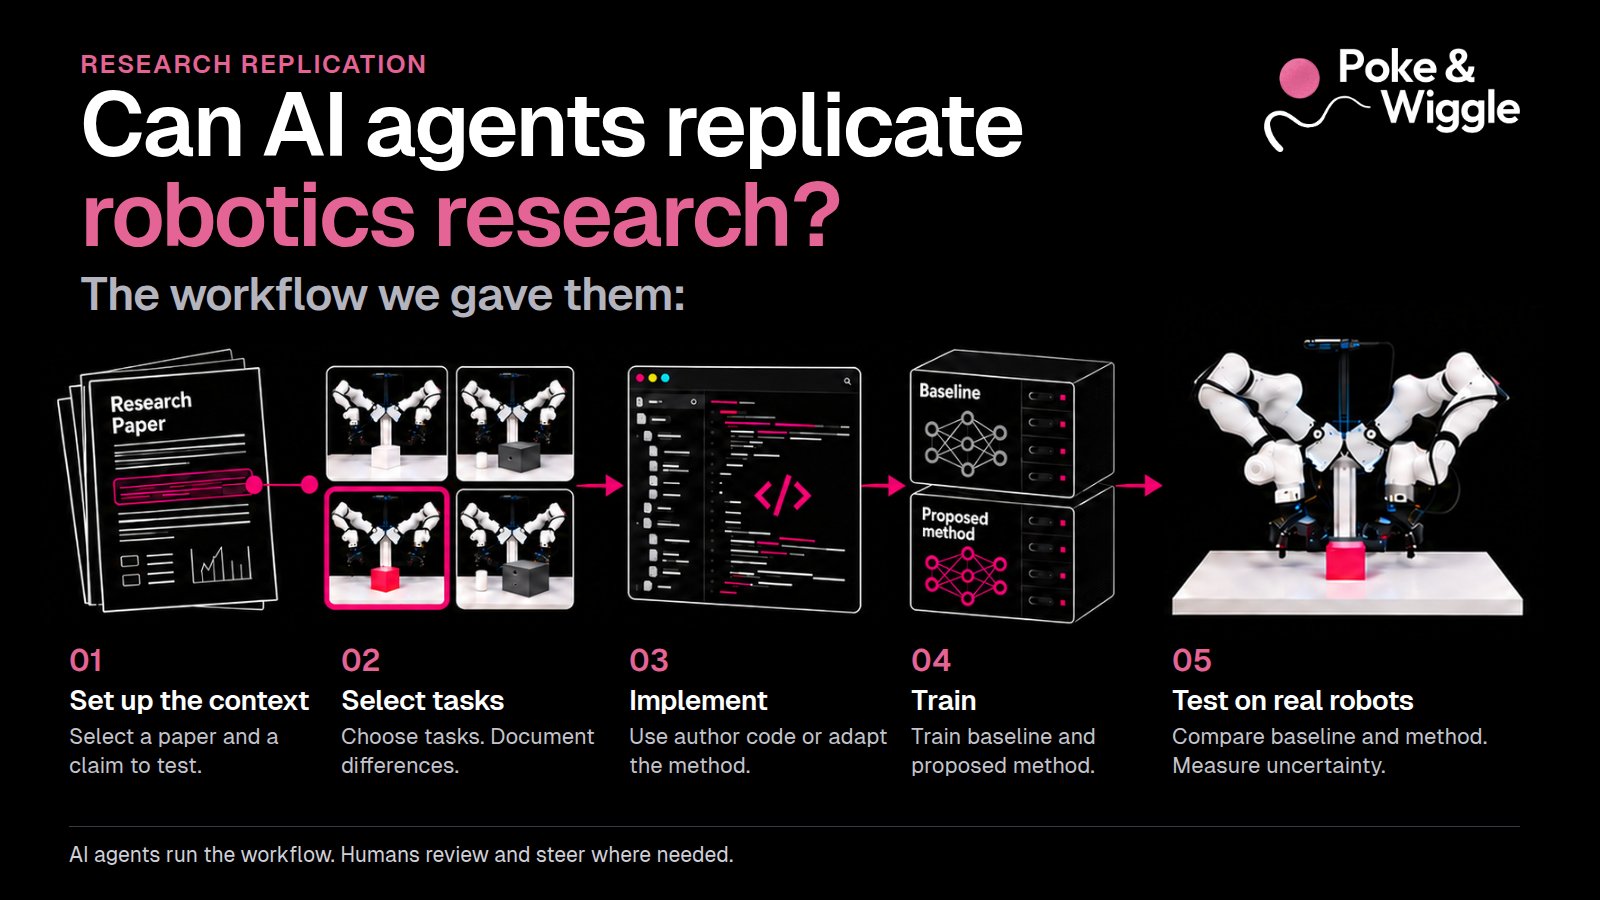
在这套系统中,研究团队只需提供论文及需要验证的结论,AI Agent便可自主阅读论文、选择实验任务、编写算法代码,并调用GPU训练模型。
训练完成后,Agent还能申请真实机器人测试,将新方法与基线模型进行比较,分析任务成功率及完成进度。
整个流程主要由Claude Opus 5.5驱动,实验人员则负责场景准备、环境复位及质量检查,研究人员在必要时介入审核。
为保证实验的可比性,平台还会控制物体初始摆放,使不同模型在相同场景下接受测试。
2、复现10篇论文,部分方法效果得到验证
此次复现的10篇论文,涉及机器人动作表示、视觉特征、策略学习和数据筛选等多个方向。
其中,Patch Policy和DSD的部分核心结论得到成功复现。
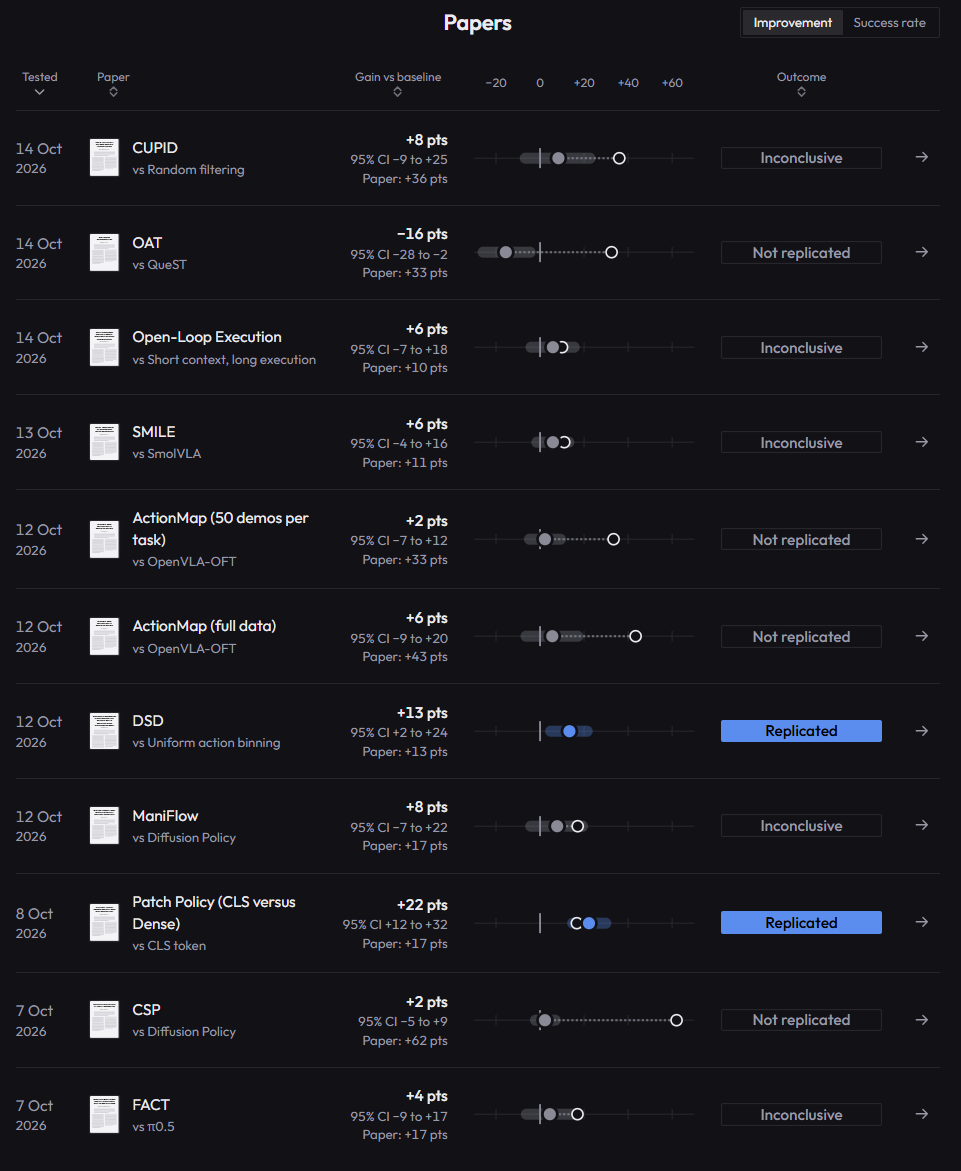
Patch Policy提出利用密集视觉特征改善机器人控制。在Poke & Wiggle的实验中,相比使用单个CLS Token,密集视觉特征使任务成功率提高22个百分点。

DSD(Direction-Scale Decomposition)是一种动作表示法,通过将机器人动作拆分为方向和幅度进行编码,提高动作学习效果。

在这项实验中,Claude首次连续自主运行约25小时,却得出了DSD没有明显改善成功率的结论。
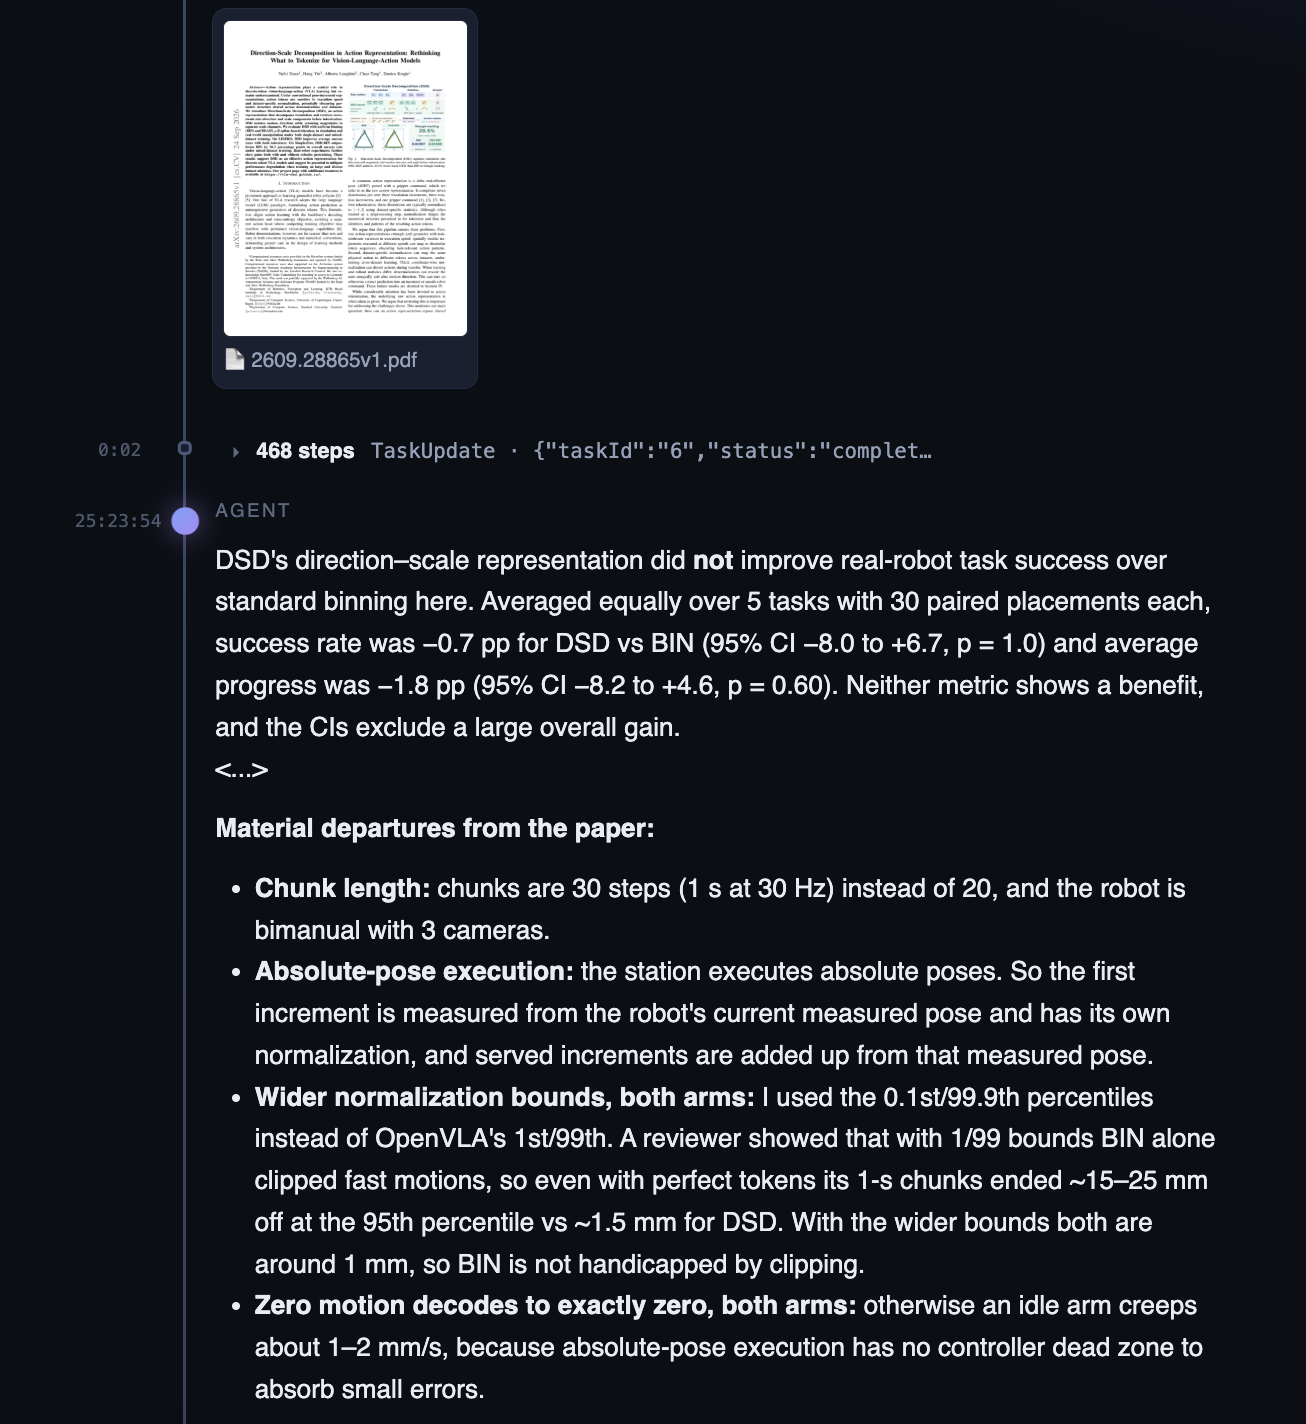
研究人员检查后发现,Agent擅自修改了原论文规定的基线归一化参数,影响了实验结果。
经过人工纠正并重新训练后,DSD的平均成功率从传统方法的32.0%提高至45.3%,提升13.3个百分点。
除了论文复现,Poke & Wiggle还展示了AI Agent自主调试的能力。
一次实验中,Agent发现机器人连续10次测试的成功率均为0%,便主动下载运行日志,定位到自己修改的推理代码存在问题,随后回滚代码、更新部署镜像并重启实验。
从发现异常到修复后的实验开始运行,耗时不到35分钟。
团队还让Agent自主接入微软新发布的VLA模型Rho,并在次日完成模型集成、训练及真机测试,在倒螺丝任务上取得87%的成功率。
不过,Poke & Wiggle也提到,AI Agent仍会误解论文或忽略代码审查中发现的问题,关键科研判断依然需要人工介入。
结语:站在 Bitter Lesson正确的一边
AI研究者Richard Sutton曾在《The Bitter Lesson》中指出,从长期来看,能够充分利用计算规模增长的通用方法,往往比依赖人类经验设计的专门方法更具潜力。
MicroFactory创始人也坦言,采用前沿通用大模型,意味着站在了“The Bitter Lesson”正确的一边,能够直接受益于全球投入数十亿美元研发的前沿模型,而不必独自承担基础模型的研发成本。
Poke & Wiggle的探索则进一步表明,通用大模型带来的价值不只体现在机器人执行任务上,还可能延伸到机器人控制方法的研发与改进,让AI参与过去需要研究人员反复完成的编程、训练和实验工作。
这也意味着,未来机器人行业的竞争,或许不仅在于谁能造出更聪明的机器人大脑,还在于谁能更快地将通用AI的进步,转化为机器人在真实世界中的新能力。
