



智东西(公众号:zhidxcom)
作者 | 黄菲
编辑 | 江宇
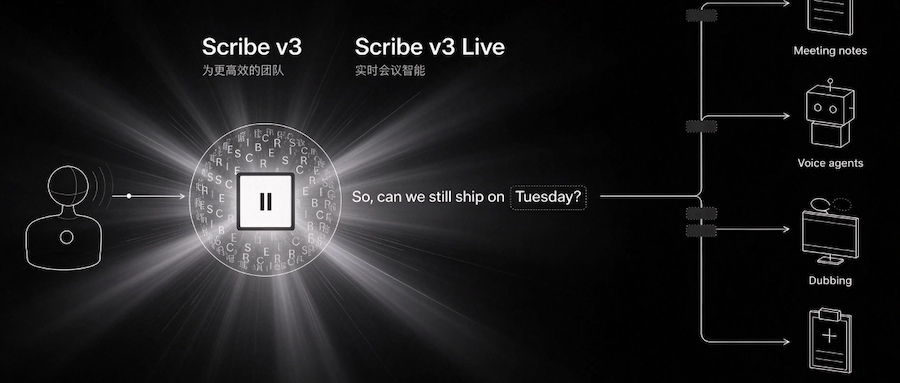
智东西11月11日报道,今日,英国AI语音独角兽ElevenLabs推出其迄今最精准的语音转文本模型Scribe v3和Scribe v3 Live,分别面向录音转写和实时语音两大场景。这两款模型针对真实环境中的复杂音频进行优化,实时版能够更好地应对强背景噪声、说话人中途停顿和多人交谈等情况。

除此以外,Scribe v3与Scribe v3 Live两款模型均提升了多人对话中的说话人区分能力,其中前者进一步降低了说话人标注错误率,后者则首次支持实时说话人区分,并改进了对话轮次检测。
除了识别准确率提升,新模型还增加了语言识别提示、专业术语控制和文本格式调整等功能。ElevenLabs希望通过这些升级,让语音转写不仅能够准确识别说话内容,还能更好地适应会议记录、客服通话和语音Agent等实际应用场景。
ElevenLabs开发者团队账号随后披露了两款模型的最新测试成绩。其中,Scribe v3在102种语言测试中的词错误率较今年1月9日发布的Scribe v2降低27%。实时版Scribe v3 Live相比2025年11月推出的Scribe v2 Realtime,语义词错误率降低43%,词错误率降低31%。
模型发布后,不少网友也分享了自己的看法。有网友认为,新模型将让会议记录变得更加轻松。
还有网友谈道,背景噪声和多人同时交谈一直是语音转写工具的难点,转写结果往往难以分辨不同发言者,也难以还原每个人作出的承诺。如果Scribe能在嘈杂环境中准确区分发言者,就能减少会后整理会议记录的时间。
此外,也有网友关注数字识别能力,认为新模型或许能解决语音转写中的数字识别问题。
目前,这套对话轮次检测能力此前已经应用于ElevenAgents,此次也被引入ElevenAPI。
一、Scribe v3专业术语基本识别,实时版多人对话反应迅速
体验Scribe v3和Scribe v3 Live,需要先注册ElevenLabs账号。用户可通过ElevenLabs API调用两款模型,也可在ElevenLabs应用中直接体验。其中,Scribe v3支持上传本地音频文件,也支持通过URL导入音频进行转写。
体验网址:https://elevenlabs.io/app/sign-up
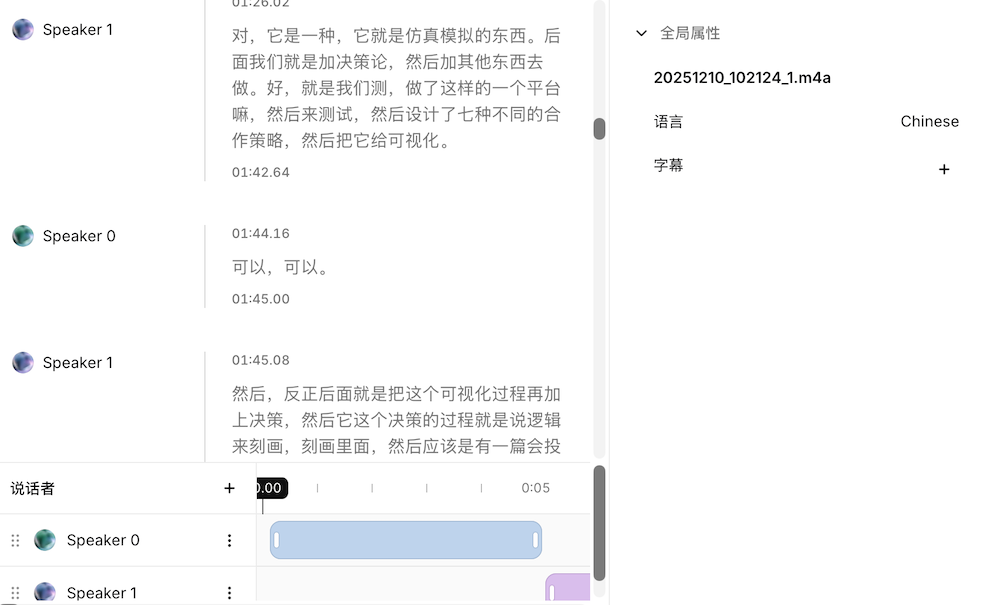
为了进一步了解Scribe v3在真实对话中的表现,智东西选取了一段中文多人交流录音进行测试。本次测试通过上传本地音频文件完成,录音内容涉及科研项目讨论、逻辑学课程和专业术语。
从转写结果来看,模型能够识别出对话中的两位说话人,并通过Speaker 0和Speaker 1区分不同发言者。对于“一阶逻辑”“模态逻辑”“决策论”等专业术语,以及德语词汇“Entscheidung”,模型也能够进行识别。
不过,转写结果仍存在一些不足。部分语句出现了“[无法理解]”标记,个别句子的表达也不够连贯,说明模型在多人交谈、口语表达和复杂语境下仍可能出现漏转或识别偏差。此外,模型为转写内容标注了时间戳和说话人信息,便于后续整理会议记录。
可以看到,这次测试展示了Scribe v3处理中文多人对话和专业词汇的能力,但也能看到其在完整还原口语内容方面仍有改进空间。
在实时语音测试中,我们让3个人轮流进行对话。
Scribe v3 Live能够在对话过程中识别不同说话人,并将发言分别标记为说话人1、说话人2和说话人3。测试过程中,模型响应较快,界面显示的延迟为117毫秒,能够较快输出识别结果。
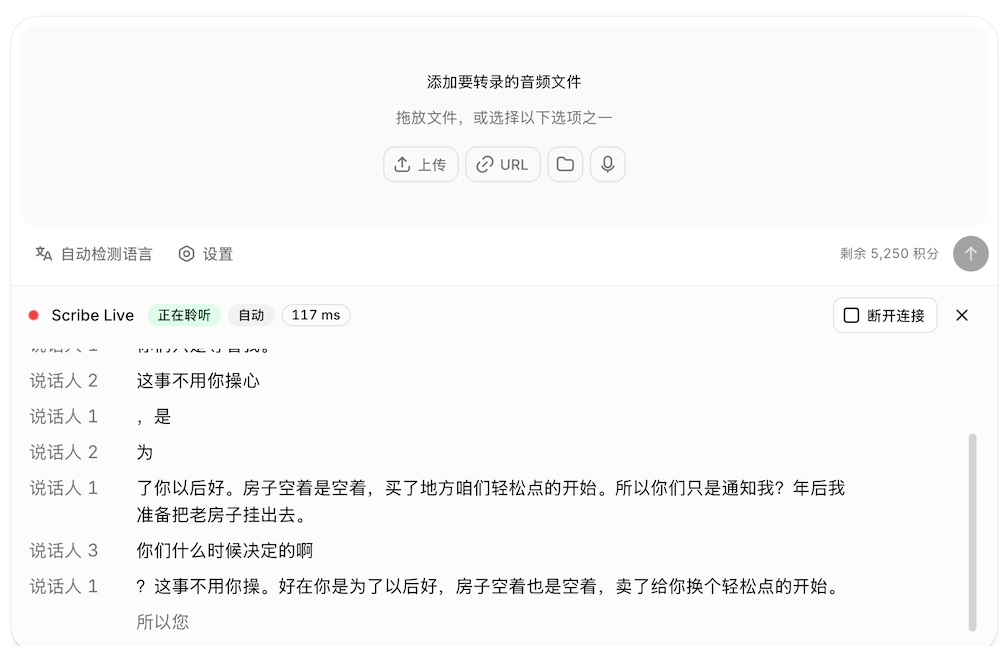
整体来看,Scribe v3 Live在多人实时对话中的说话人区分和响应速度表现较为突出,而录音转写部分仍有进一步提升空间。
二、词错误率最高降低43%,102种语言转录错误率全面下降
Scribe v3主要面向已录制完成的音频进行转写,ElevenLabs采用词错误率(WER)评估测试模型的转写准确性。
测试结果显示,Scribe v3相比Scribe v2,在所有受测语言中的词错误率均有所下降,整体降低27%。与其他非流式语音转写模型比较,在双方共同支持的语言范围内,Scribe v3的词错误率均低于参评竞品Gemini 3.5 Transcribe、GPT Transcribe等。
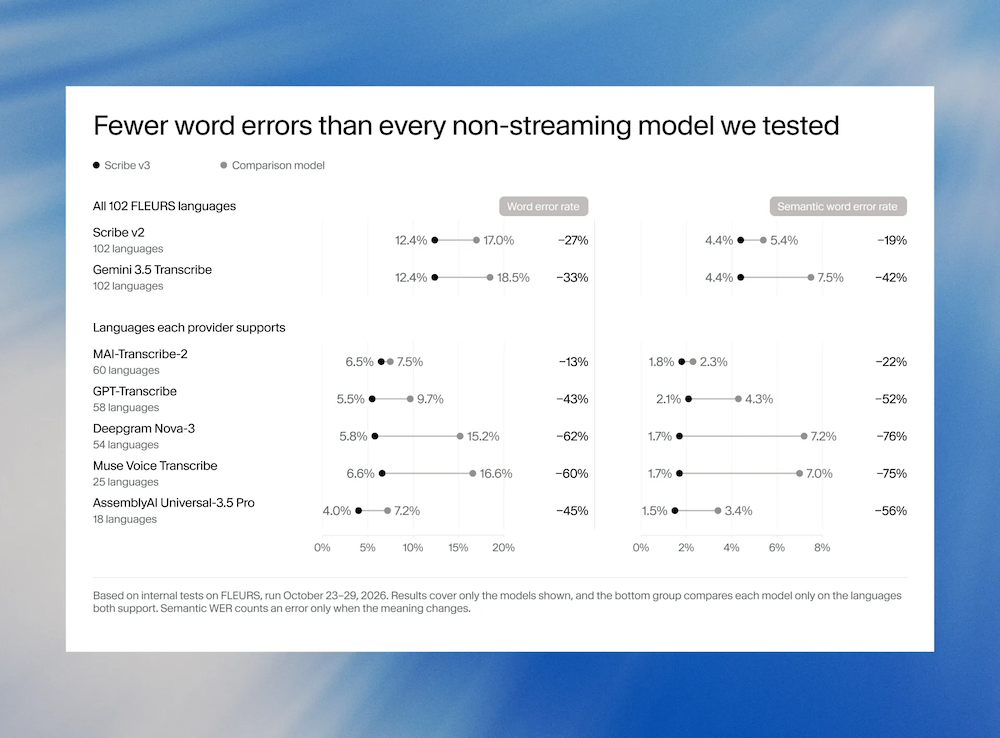
▲ElevenLabs Scribe v3词错误率优于所有参评非流式竞品。来源:ElevenLabs
在多语言识别方面,ElevenLabs使用内部版本的FLEURS基准测试,该基准为简短清晰的朗读音频构成,对模型在102种语言中的表现进行评估,再计算平均值,确保每种语言在最终结果中占据相同权重。
相比起Scribe v2,Scribe v3在多语种测试中的转录错误率也全面下降。
在常用语种中,德语词错误率降低42%,西班牙语降低35%,英语降低23%。在识别难度相对较高的语言中,斯瓦希里语降低34%,泰米尔语降低29%,泰语降低28%。

▲ElevenLabs Scribe v3对比Scribe v2在常用语种与高难度语种的转录错误。来源:ElevenLabs
除了减少识别错误,Scribe v3还改善了对多人对话的识别能力。
在包含3名及以上说话人的录音中,Scribe v3的说话人区分错误率相比Scribe v2降低17%。在整体说话人区分测试中,其错误率也比Scribe v2降低12%,为ElevenLabs测试过的模型中最低。
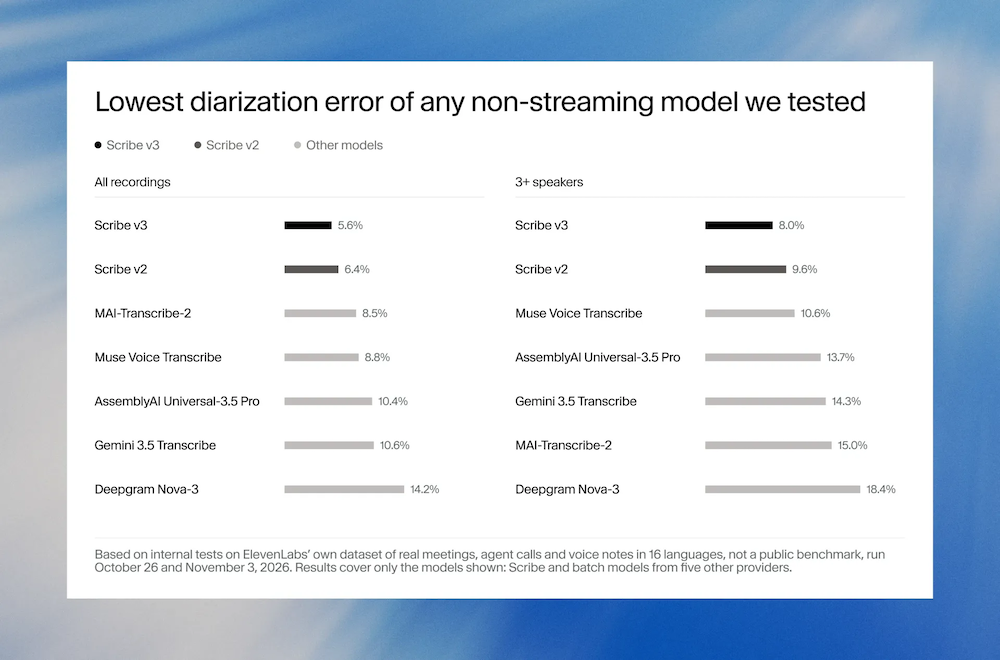
▲Scribe v3在所有参评非流式模型中说话人区分错误率最低。来源:ElevenLabs
三、实时版首次支持说话人区分,减少对话中途打断
实时版Scribe v3 Live针对实时语音转写进行了优化,结果同样取得了提升。
由于实时转写模型需要在说话人讲完一句话之前生成转写结果,ElevenLabs主要采用语义词错误率(Semantic WER)评估转写内容是否保留原意
在102种语言的测试中,Scribe v3 Live相比Scribe v2 Realtime,语义词错误率降低43%,词错误率降低31%,并在所有受测语言中实现改善。
其中,希腊语的语义词错误率降低77%,丹麦语降低54%,克罗地亚语降低45%,印地语降低36%。

▲ElevenLabs Scribe v3 Live对比Scribe v2 Realtime,多语种语义转录错误显著降低。来源:ElevenLabs
除了识别准确率,Scribe v3 Live还重点升级了实时对话中的说话人区分和轮次检测能力。在同系列模型中,该模型首次将说话人区分功能引入实时转写。
在对比测试中,ElevenLabs还将各模型的转写文本与参考文本进行对齐,以单独评估模型是否将内容分配给了正确的说话人,避免漏词等转写错误影响说话人区分结果。
在ElevenLabs自建的真实场景数据集中,Scribe v3 Live在覆盖16种语言真实音频中表现优秀,其说话人区分错误率比受测实时模型中的第二名低39%。
在英语测试中,Scribe v3 Live的说话人区分错误率为3.1%,低于Grok Voice Transcribe 2.0的5.9%、AssemblyAI Universal-3.6 Pro Realtime的6.1%和Deepgram Nova-3的7.3%。
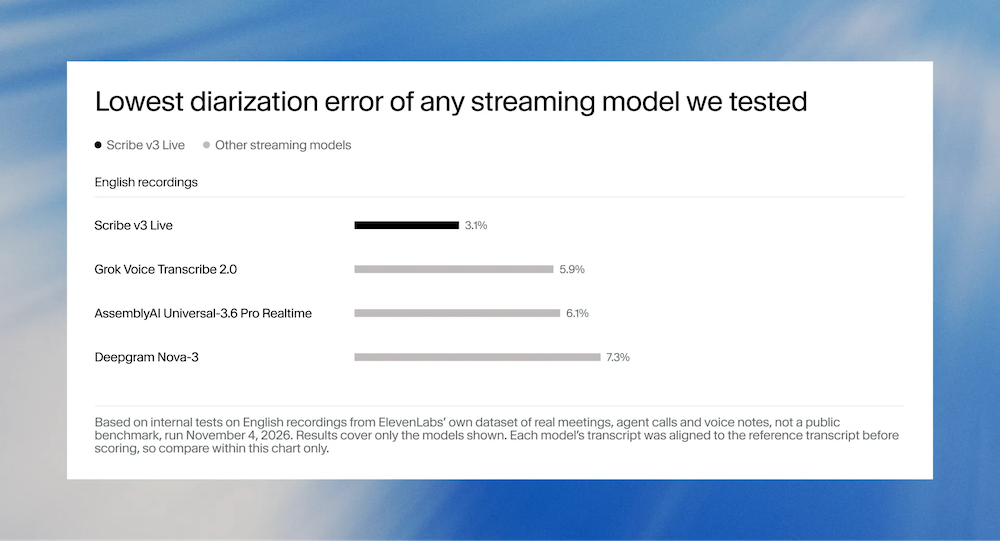
▲ElevenLabs Scribe v3 Live在所有参评流式模型中说话人区分错误率最低。来源:ElevenLabs
在对话轮次检测方面,Scribe v3 Live也进行了改进。
传统语音Agent通常根据静音时长判断用户是否已经说完。如果静音时间设置得太短,用户在说话中途停顿就可能被打断;如果设置得太长,又会让Agent的响应显得迟缓。
Scribe v3 Live则结合对话上下文和音频信息判断说话人是否结束发言。例如,用户在报读一串数字时短暂停顿,模型能够结合上下文判断用户是否仍在继续,而不是直接认定对话结束。
四、Scribe v3输入术语达1000个,实时版关键词库提效率
在语言和文本处理方面,Scribe v3增加了多项可控功能。模型能够推断录音中可能出现的语言,并允许用户选择将数字以阿拉伯数字或文字形式输出。
针对品牌名称、缩写和专业术语等容易出现识别偏差的内容,Scribe v3支持关键词提示,最多可以输入1000个指定术语。
用户还可以通过自然语言设置文本格式规则,例如要求模型将所有日期统一输出为YYYY-MM-DD格式。
实时版Scribe v3 Live则增加了多语言混合识别模式,能够处理说话人在同一句话中切换语言的情况。该模型还支持关键词库,关键词库能够容纳数千个可能出现的词汇,模型会在听到疑似匹配内容时调用相关词汇进行识别。
此外,荷兰能源供应商Eneco提前测试了Scribe v3 Live,并将其用于语音Agent。根据ElevenLabs披露的测试结果,在真实客户通话中,语音Agent首次正确识别荷兰邮政编码的比例提高了40%,首次正确识别门牌号码的比例提高了15%。
目前,Scribe v3和Scribe v3 Live默认在美国运行,也为有数据驻留要求的企业客户提供欧盟、印度和新加坡的独立运行环境。两款模型均支持零数据保留模式,请求完成后即可删除音频和文本数据。
ElevenLabs称,两款模型纳入SOC 2、ISO 27001和PCI DSS Level 1相关合规项目,并在签署业务伙伴协议(BAA)后具备HIPAA适用资格,同时支持私有化部署。
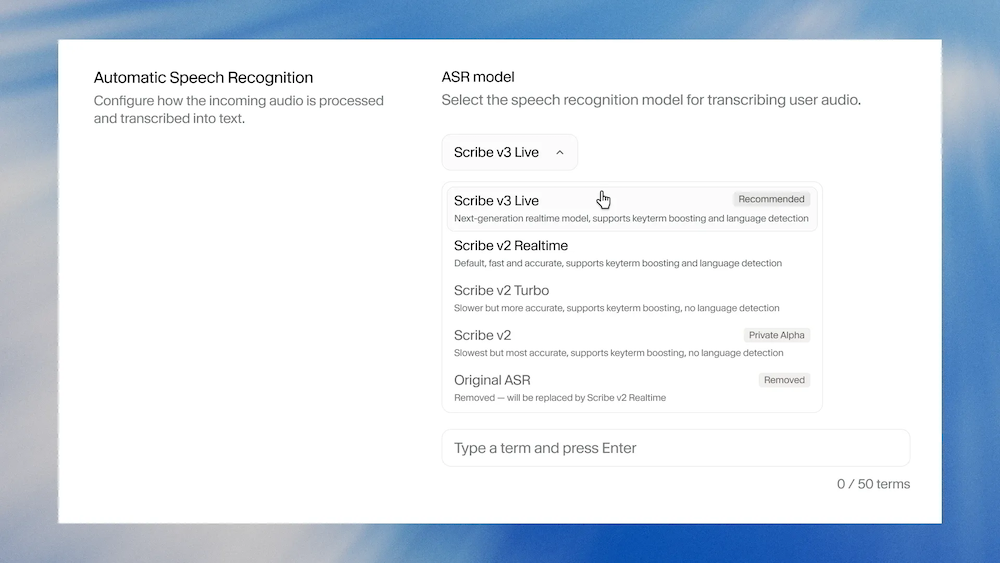
▲ElevenLabs后台ASR模型选择界面,Scribe v3 Live标记为推荐模型。来源:ElevenLabs
结语:语音AI竞争,从识别准确率走向真实交互
从ElevenLabs此次发布新模型来看,语音模型之间的竞争正越来越激烈。Scribe v3让会议记录更准确,Scribe v3 Live让语音Agent交互更连贯。
过去,语音识别更多承担将声音转换为文字的任务。如今,随着语音AI逐渐走近真实生活场景,模型能否准确作出语音识别将成为影响语音Agent实际体验的重要因素。
未来,语音模型的竞争不再局限于转写错误率,谁能更好地兼顾准确率与实时交互体验,谁就更有机会推动语音Agent走向应用蓝海。
来源:ElevenLabs
