


芯东西(公众号:aichip001)
编译 | 程茜
编辑 | Panken
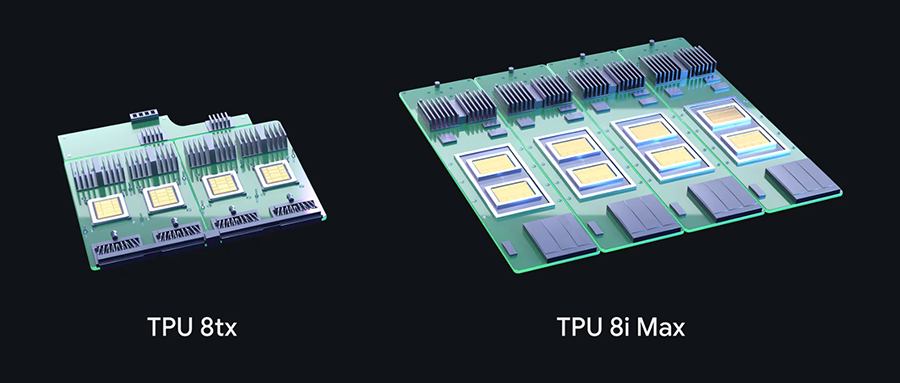
芯东西11月9日消息,刚刚,谷歌发布两款TPU,分别是面向超大上下文窗口设计、主打单机柜最高算力密度的TPU 8i Max,以及支持安全与机密推理的TPU 8tx。
谷歌称,相比TPU 8t,TPU 8tx最高可将延迟降低一半,性能损耗几乎可以忽略不计;TPU 8i Max的算力、SRAM以及HBM带宽均为TPU 8i的2倍。
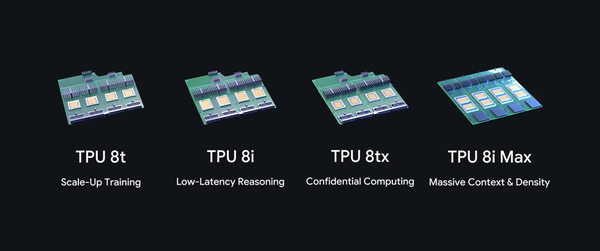
这是谷歌首次在一年内推出4款TPU。今年4月,谷歌曾推出两款新型专用TPU,分别为用于大规模训练的8t,和用于实时推理的8i。
至此,谷歌第八代TPU的4款TPU可覆盖智能体全生命周期。
除了推出最新的TPU,谷歌还为开发者升级了统一的开源软件栈。
一、针对机密计算和内存墙,谷歌甩出2款TPU
谷歌此前一直与谷歌DeepMind合作设计TPU,但随着计算范式从面向人类交互,转向面向智能体的任务,企业需要能够在超大上下文窗口内完成推理的加速器。部分强监管行业客户还要求为专属业务负载提供专用加密能力。
这就是谷歌此次推出两款新TPU的原因,其目标是让每位开发者和云客户都能便捷使用TPU。
谷歌第八代TPU产品组合针对的是AI生命周期的不同环节:
今年4月发布的TPU 8t被设计为大型基础模型的训练核心,旨在实现最高的“有效吞吐量”,即每瓦电能所输出的有效智能能力;TPU 8i是一款推理引擎,旨在打破内存墙,将芯片间通信延迟最高降低一半。
此次新推出的TPU 8tx和TPU 8i Max针对的是机密计算和内存墙。
TPU 8tx是谷歌第八代TPU中的第三款,针对安全与机密推理进行了优化,也适用于小规模训练。它为受监管的企业和政府机构打造,这些机构可在处理敏感数据的同时,运行前沿模型及智能体。
通常情况下,数据在存储或网络传输时会加密,但在计算机处理过程中,必须在内存中解密。TPU 8tx采用的是与TPU 8t相同的芯片,搭配第五代AMD EPYC CPU主机,将安全能力直接内置至硬件层,即便敏感数据与模型权重正处于运算使用状态,也能持续受到保护、实现隔离。
同时,TPU 8tx沿用谷歌为实时推理打造的低延迟Boardfly网络,能保障多步骤智能体任务流畅运行。谷歌声称,相比TPU 8t,TPU 8tx最高可将延迟降低一半,且性能损耗几乎可以忽略不计。
将训练级算力与高速推理网络相结合,也意味着企业可以在同一套系统上同时运行并定制模型。依托TPU 8tx,研发团队能够使用私有数据微调模型、把大模型蒸馏为小模型,还能通过强化学习训练智能体,这些过程无需在多个独立集群之间迁移敏感数据。

TPU 8i Max解决的是内存墙问题。
当数十个智能体同时在整个软件代码库或数小时的视频内容上协同工作时,内存带宽的瓶颈会凸显。因此,谷歌将两块低延迟的TPU 8i芯片封装到了同一个封装基板内。
谷歌称,TPU 8i Max能实现算力与内存同步扩容,算力、SRAM以及HBM带宽均为TPU 8i的两倍。
此外,TPU 8i Max在原有机柜空间内集成了2倍的芯片面积,因此数据中心可以在同等占地、同等功耗下部署更多算力。

二、谷歌要把TPU开放给所有开发者,软件栈统一升级
谷歌还宣布,为了向所有开发者开放TPU,其还将围绕下面几点进行投入:
首先,谷歌将向所有PyTorch开发者开放TPU开发能力,无需其重写代码。
上个月,谷歌开源了面向TPU的原生PyTorch框架TorchTPU。如今PyTorch代码与Hugging Face上的模型可在TPU上原生运行,同时vLLM、SGLang等主流开源推理引擎也提供开箱即用的TPU后端。
此外,为降低硬件优化门槛,谷歌开源TPU智能体工具套件可直接接入Claude Code、Cursor、Google Antigravity等编程工具,几分钟内能完成TPU环境接入、自动定位性能瓶颈,并支持用自然语言对自定义算子做自动调优。目前该工具套件仍是预览版。
面向生产部署场景,谷歌开源了XLA Serving Engine工作流,支持用Python完成模型训练,之后直接在低延迟C++运行时中部署上线,可跨TPU、GPU、CPU异构硬件提供服务。
其次,谷歌称,其TPU已经在InferenceX、AgentX基准测试上实现业界领先的生产级性能。
行业标准评测集InferenceX与AgentX针对的是真实智能体代码生成、长上下文任务。根据谷歌公布的测试结果,其依托TPU上原生的vLLM-TorchTPU软件栈,取得了当前顶尖的性价比表现。这一优势可以覆盖多款前沿开源模型以及各类开源服务栈,同时保证模型精度不受影响。
第三,谷歌将进一步消除自主智能体的算力空耗问题。
AI智能体属于有状态程序,在等待数据库查询结果、外部工具返回信息或是人工反馈时,经常会暂停数秒甚至数小时。为了让加速器在这类等待时段更省电,谷歌推出的Agent Compute Engine软件可以自动挂起闲置的智能体会话,并在毫秒级时间内将工作内存迁出芯片。
第四,谷歌将借助TPU Sync突破内存墙。
谷歌将开源面向TPU集群的模型状态层TPU Sync。TPU Sync把芯片HBM、主机DRAM、共享存储以及数据中心网络融合成一套协同设计的统一内存层级;它可以在毫秒级把KV缓存自动下沉到芯片外部,在解耦的预填充节点与解码节点之间流式传输上下文,同步强化学习权重,最终将KV传输延迟与首token生成时间降低90%以上。
第五,谷歌将通过单一控制器在多块TPU上横向扩展分布式任务。
谷歌自研的大规模分布式机器学习运行系统Cloud Pathways已在谷歌Kubernetes引擎(GKE)正式可用,它把谷歌DeepMind运行时开放给所有谷歌云客户。
依托单控制器架构与路径工具,开发者可以对跨多个TPU切片的大规模TPU集群进行编排。谷歌称,无论是预训练、强化学习还是多主机推理,开发者使用起来就像操作一台本地机器。
此外,Cloud Pathways借助同置Python边车、分钟级以内的TPU切片热切换与弹性分片重排能力,能让长时间运行的任务在硬件出现故障时持续推进。
最后,谷歌将依托GKE动态切片能力按需拼接自定义TPU拓扑。
GKE动态切片功能已正式可用。它借助光电路交换(OCS)技术,将物理硬件资源供给与逻辑切片组建解耦。该功能可实时把TPU立方体动态组合成更大的拓扑(超切片),或是拆分为更小、相互隔离的负载(子切片)。
谷歌称,这种拓扑灵活能力最高可将任务启动时间缩短至原来的1/5,故障恢复速度最高提升4.5倍,最大化整池TPU的资源利用率与任务有效吞吐。
结语:智能体时代,加速器要走向场景化定制?
谷歌称,如今越来越多企业借助AI来构思、打造下一代AI基础设施,谷歌同样如此。无论是利用谷歌DeepMind的AlphaChip强化学习系统,还是依靠Gemini在数小时内完成芯片版图设计,谷歌都在用基于TPU的AI服务加速下一代TPU硬件研发。
如今,面向智能体场景的算力需求爆发,算力厂商正在从通用加速器,转向按训练、推理、保密、长上下文等场景做细分优化。谷歌通过芯片、模型、系统相互助推形成闭环,打造出了这套围绕智能体生命周期定制的加速器方案,正是面向上述趋势的新探索。
来源:谷歌
