


智东西(公众号:zhidxcom)
作者 | 王涵
编辑 | 漠影
2026年,Agent的火爆程度空前。
9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年全球活跃Agent约7940万个,到2030年将达22.16亿个。
而同期Token消耗量的增长更为惊人:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数量增长约28倍,Token消耗却增长数百万倍。
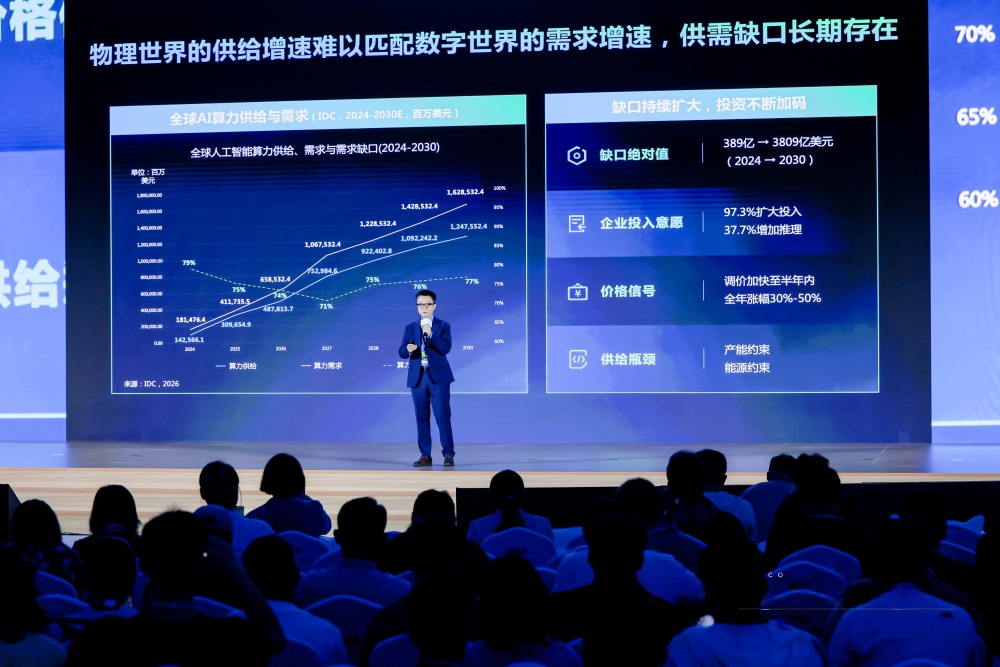
需求侧增长如此之快,算力供给能接住吗?
今年有两个案例十分典型:
一是Kimi K3。这个总参数量2.8万亿的模型,权重文件达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方推荐至少64卡甚至更大规模才能运行。
它指向的是“向上”的困境:当Agent需要更强推理、更长上下文和更多智能体协同,能力上限越高,部署门槛越从单机走向集群。
二是DeepSeek。2026年上半年,它曾将V4-Pro的API价格下调75%,并称调整长期有效;但8月又预告整体提价,理由直指“算力不足”。
它指向的是“向广”的困境:当Agent大规模调用便宜模型,性价比算力的需求被迅速放大,容量不够,低价供给就难以持续。
这两个问题怎么破?
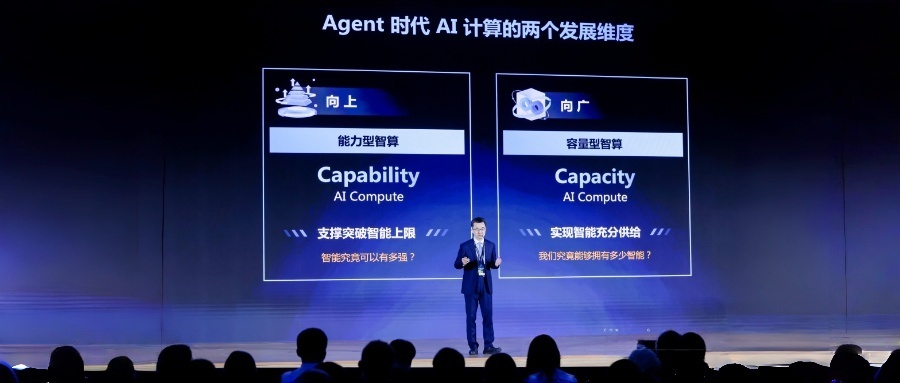
在AICC 2026大会上,浪潮信息给出了自己的回答:向上,Capability AI Compute;向广,Capacity AI Compute。
会上,浪潮信息正式发布元脑SD200 Ultra超节点AI服务器和元脑HC2000多元算力机组。“向上向广”两个方向齐头并进,通过系统协同,浪潮信息从提供算力走向生产智能。
一、向上,超节点突破智能上限
要理解向上的瓶颈从何而来,我们要先看清AI的需求端发生了什么变化。
过去,人们对AI的需求是回答问题,算力调用是单次且临时的。而在Agent时代,一次用户意图背后,可能是几十次、几百次甚至更多次推理,是多个Agent连续几小时甚至几天的协同工作。应用形态的变化,直接提高了对算力系统的要求。
与此同时,前沿模型的Scaling up也在这一时期进入加速期。
以Kimi K3为例,其参数量已经达到2.8万亿,权重文件约1.56TB,普通服务器显存连权重都装不下,更不用说百万Token上下文。官方推荐扩展到64卡甚至更大规模,才能让模型真正运行。更不用说未来可能会扩展到十万亿参数量级的更加前沿的模型。
现如今,芯片之间需要高效通信,内存需要统一寻址,数据搬运需要尽可能减少。简单地把更多服务器堆在一起,行不通了。
超节点的意义,就在于突破传统单机的计算边界,把更多芯片和内存纳入一个高效协同的计算域,为前沿智能提供更大的“有效计算空间”。
浪潮信息发布的元脑SD200 Ultra超节点AI服务器,正是围绕这一目标设计。
元脑SD200 Ultra以开放系统设计紧耦合128芯本土AI芯片,实现统一内存寻址超低延迟通信,并以对称直连、算子优化等创新技术减少模型运行中的数据搬移与等待。
基于这套系统,SD200 Ultra可以单机运行2.8万亿参数的Kimi K3,Token生成时延首次突破5.85毫秒。
同时随着模型参数规模不断提升,还支持10万亿参数规模的前沿模型,为模型规模和上下文长度的持续扩展提供支撑。
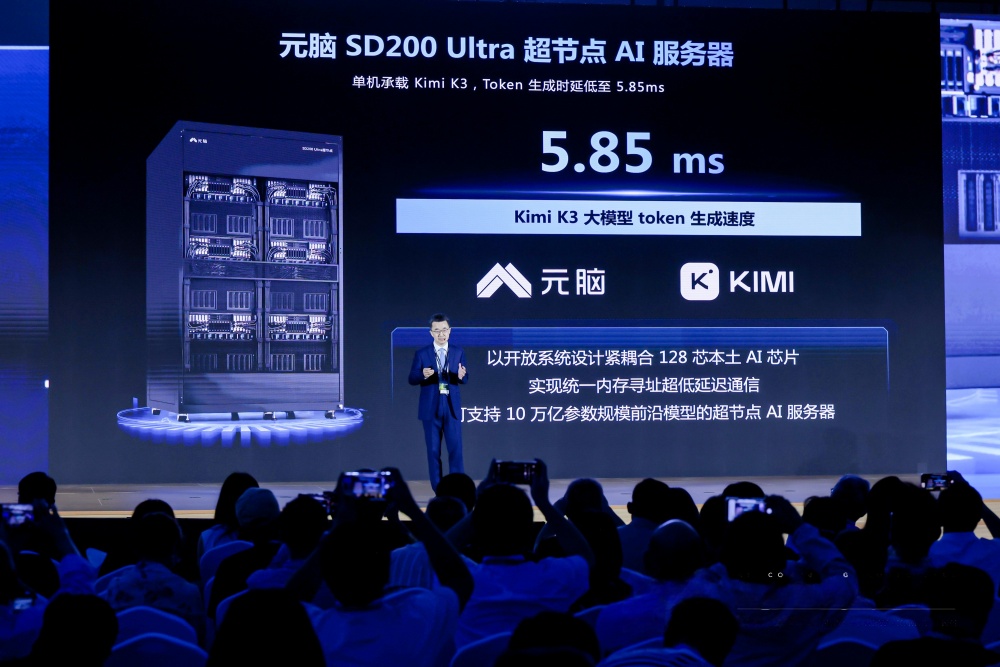
从技术实现看,SD200 Ultra基于128芯本土AI芯片,采用3D HyperMesh架构,提供8TB带宽和64TB内存,让前沿模型能够充分利用多颗芯片的计算与存储资源。
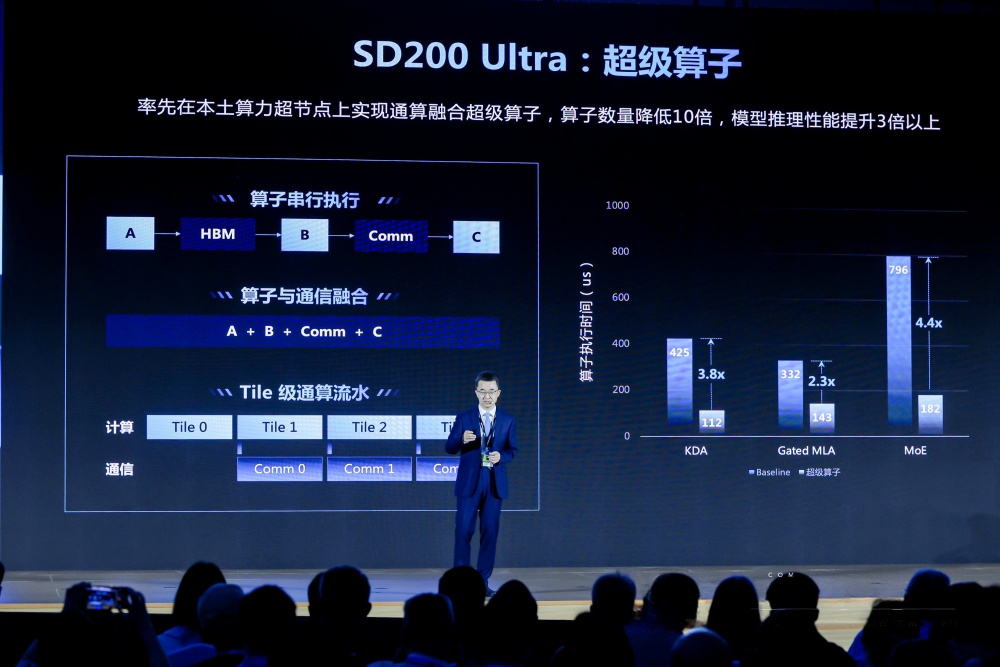
通信方面,原生内存语义通信把跨芯片通信时延降低到0.69微秒;在推理优化上,浪潮信息构建超级算子库体系,将KDA、Gated MLA、MoE中的众多基础算子融合为计算+通信的大算子,算子数量降低为原先的1/11,大幅减少了Kernel Launch次数,HBM访问开销,并隐藏了通信延迟,提升GPU整体执行效率。
今天,AI已经能够解决困扰学术界几十年的NS方程。能力型智算要做的,就是让这些前沿能力不只是实验室里的演示,而是可落地、可复制的生产力。
二、向广,让智能供给“供得上、供得便宜”
如果说Capability解决的是“智能可以有多强”,那么Capacity解决的是“我们究竟能够拥有多少智能”。
随着Agent数量和使用深度增加,Token需求还会继续快速增长。提高单位计算资源的Token产出,成为规模化供给的关键。
然而,提高Token产出并不容易。
推理不是一种单一计算模式。Prefill和Decode的计算特征不同,Attention和MoE对计算与访存的要求不同。多模态、MTP等模型架构的发展,还会带来更多类型的计算负载。
简单堆更多服务器,不仅不能带来线性能力增长,还可能因为资源浪费、失衡和任务排队,使部分算力长期闲置,另一部分资源持续紧张。
这意味着,容量型智算需要换一种思路:让不同的算力承担最适合自己的负载,再通过统一的软件栈把它们组织起来。
浪潮信息的答案,是元脑HC2000多元算力机组。
它面向持续、大规模推理需求,基于DirectCom 2.0极速架构,以原生液冷高密整机柜为载体,按负载组织计算资源,实现多元算力协同。
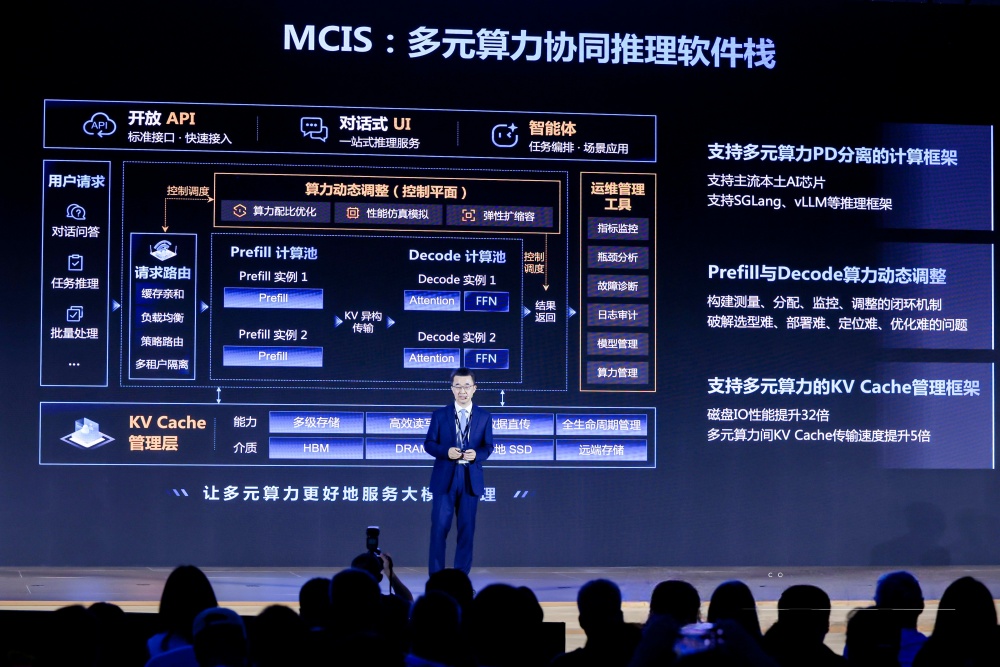
其核心软件栈MCIS建立了一套面向多元算力的协同机制:持续测量不同算力资源的能力与负载,根据任务需求动态分配算力,并在运行过程中实时调整资源配置,让不同类型、不同规模的算力承担更适合的推理任务。
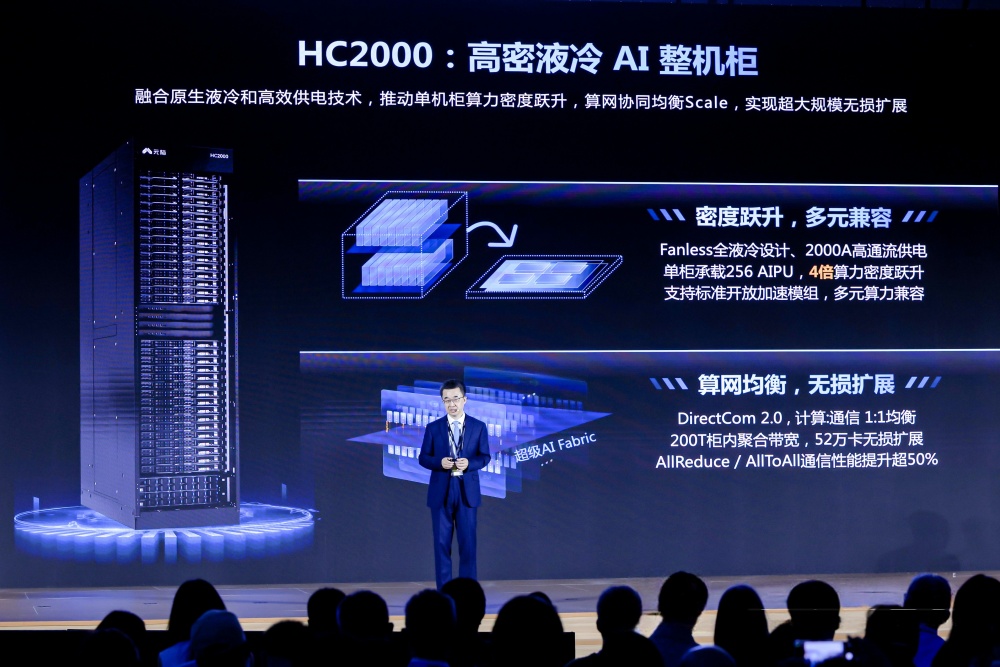
在硬件层面,HC2000采用全液冷设计和高通流供电,单柜供电能力达到300千瓦以上,最大承载256张AI卡,算力密度实现4倍跃升。
更重要的是其算力与计算特征的精准匹配。通过不同组合,多元芯片各司其职,再通过软件栈组织起来,共同完成推理协同,提升整个算力系统的Token产出效率。
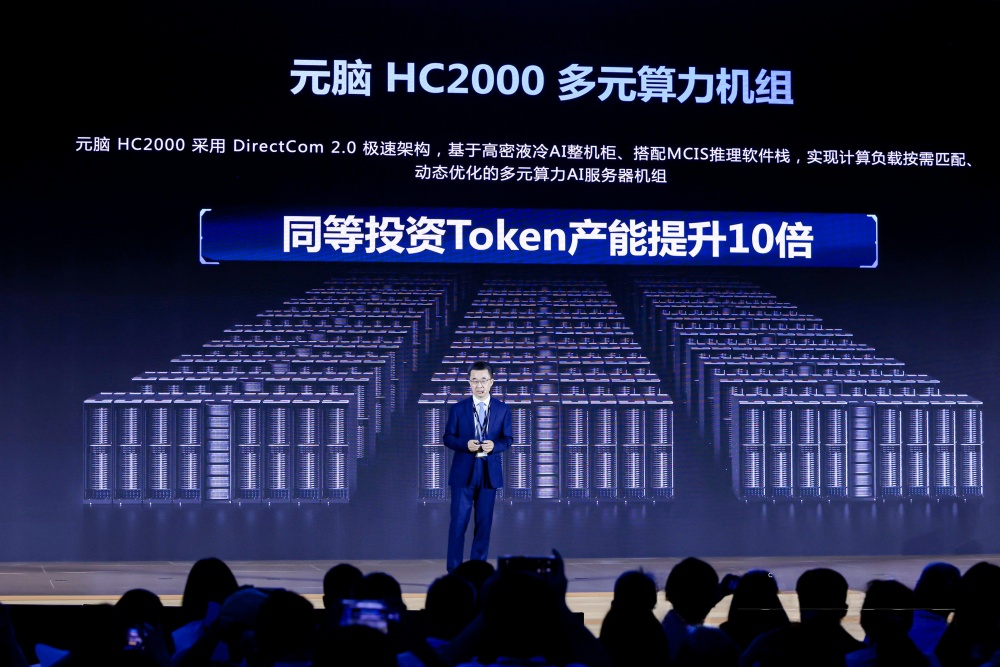
在国产算力基础上,通过MCIS和某模型适配,在典型Agent任务场景中,同等SLO约束下,相比单一算力构建的推理系统,实现了同等投资10倍Token产能提升。
浪潮信息首席AI战略官刘军曾说:“智能的价值不仅取决于最高点有多高,更取决于有多少人能够获得它。”
向广的逻辑,是要将先进推理能力通过效率提升和成本下降,快速走向更广泛的用户,让智能从稀缺资源,逐步成为整个社会都能获得的基础能力。
三、从Capability到Capacity,为什么需要系统协同?
SD200 Ultra和HC2000,一个向上,一个向广。看似在做不同的事情,但它们底层是同一个判断:当智能开始被“生产”,算力产业的竞争就不再是单点竞争,而是系统竞争。
刘军将这种思路概括为“贯穿式创新”。
第一个层面,是从芯片、服务器系统到模型的贯穿。
过去做创新,是产业链每一层做好自己的事——芯片、系统、框架、算法、算子,然后纵向对齐;但在Agent AI时代,面向特定模型需要做定制化或专用化优化。
第二个层面,是从单机到系统的贯穿。
Capacity需要从前到后的创新,把链条上每一环节拿出来看,根据不同计算负载的特征匹配最适合的计算资源。
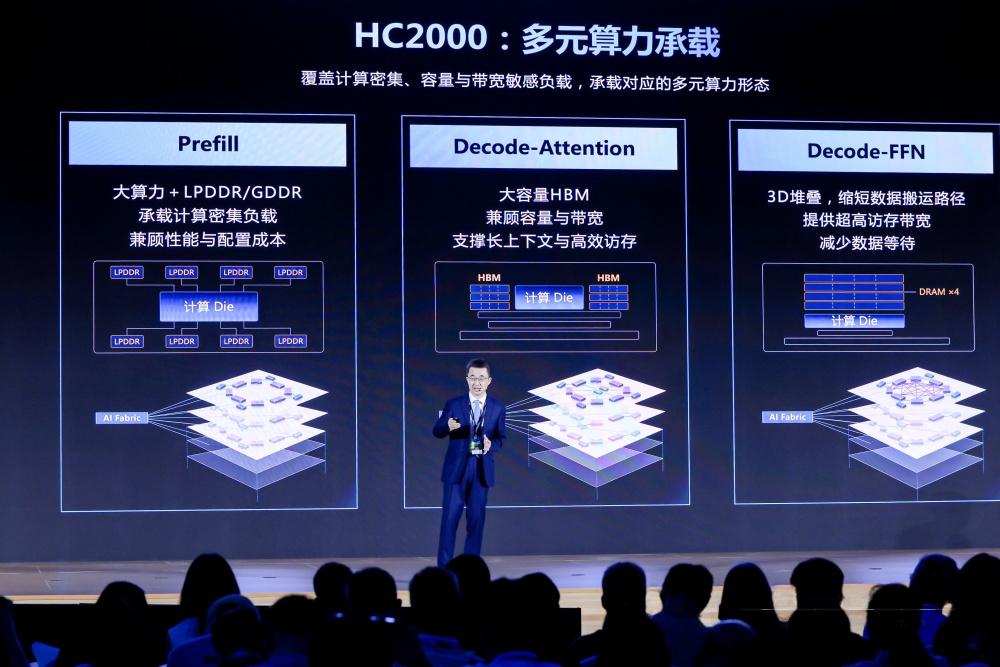
Prefill可以用大算力芯片搭配供应和成本更优的LPDDR颗粒;对于Decode阶段,可以选择具有大容量HBM,兼顾显存容量和带宽的AI芯片。
在此基础上,在FFN计算环节,可以选择3D DRAM堆叠芯片,进一步缩短数据搬运路径。放弃用同一种通用巨无霸芯片干所有事的策略,转而构建多元芯片、多元算力系统。
第三个层面,是从技术到生态的贯穿。
以前理解“多元算力”,就是服务器厂支持不同家的AI芯片;但今天出现了新的协同方式:在同一个业务里面有多元芯片,Prefill用A家芯片,Decode用B家芯片,构成一个算力系统。产业协作从“你赢我输”的零和博弈,转向开放共赢。
从更长周期看,Capability和Capacity并不是两条平行线,而是一个循环。
每一次新的智能能力出现时,往往首先是昂贵而稀缺的。随着算法进步、系统优化和工程成熟,这些能力会逐渐以更低成本进入更多模型、应用和用户。
Capability负责创造新的可能,Capacity负责让新的可能被更多人获得。
同时,更大规模的智能普及,又会带来新的应用、新的数据、新的需求,推动下一轮Capability突破。
系统协同,正是让这个循环持续运转的底层机制。
结尾:Agent时代,计算产业从提供算力走向生产智能
进入Agent时代,Token工厂不能只问拥有多少GPU、CPU,还应该问:这些算力能够支撑多强的智能?能够以多低的成本生产多少智能?
浪潮信息用SD200 Ultra向上突破智能上限,用HC2000向广推动智能规模化供给,一个负责让AI更强大,一个负责让AI更普及。连接两者的,是系统级的协同创新与开放生态。
今天的Capability,正是明天Capacity需要规模化供给的能力。Agent时代,计算产业的使命,也因此变得比以往任何时候都更宽广。
