


芯东西(公众号:aichip001)
编辑 | GACS 2026
9月20-21日,由智一科技旗下智猩猩联合芯东西举办的2026全球AI芯片峰会(GACS 2026)在上海举行,在开幕式上,后摩智能联合创始人、产品副总裁信晓旭以《存算一体、Agent时代的“芯”基建》为主题发表演讲分享。
后摩智能联合创始人、产品副总裁信晓旭谈道,2026年是Agent元年,模型快速压缩叠加端边芯片性能提升,共同打开了端边AI的商业化奇点。端边AI与云端AI协同共生,Token交互入口将成为行业争夺的焦点。
面对当前AI芯片算力、访存两大核心技术难题,后摩智能布局2D、3D CIM存算一体双技术体系。该公司将于10月生态合作伙伴大会,对外透露基于3D CIM架构的全新产品A20。同时,旗舰芯片M50商业化落地提速,量产未满一年已斩获超150个产品定点。
信晓旭认为,存算一体的新架构正逐渐被大家认可,也将逐渐为AI产业赋能。
以下为信晓旭的演讲实录:
大家好,我是来自后摩智能的信晓旭,我们公司在创立的第一年也参加了智东西举办的峰会,上次峰会在深圳南山万丽酒店。我记得我是在场所有嘉宾唯一一个讲存算一体这个话题的。我当时讲完,我看底下观众一片漠然,我猜大家可能没听懂我讲什么。
但是很幸运是,经过这几年的发展,我们看到存算一体技术路径已经得到了产业界的认可,而且有越来越多的资源和友商涌入到这个赛道里。我们公司成立6年,在这6年当中,我们一直致力于把先进的计算架构存算一体带入到产业界,在AI时代为产业赋能。
我很高兴有机会在这里和大家分享,作为一家技术创新的初创公司,在过去6年当中,我们经历的一些事情、思考。
一、AI模型与芯片的共同演进,打开端边AI商业化奇点
我在公司负责产品的工作,除了低头做事之外,也需抬头看路。所以我一直在观察几个商业化要素。
第一点是端边AI商业化需要的两个核心技术要素。
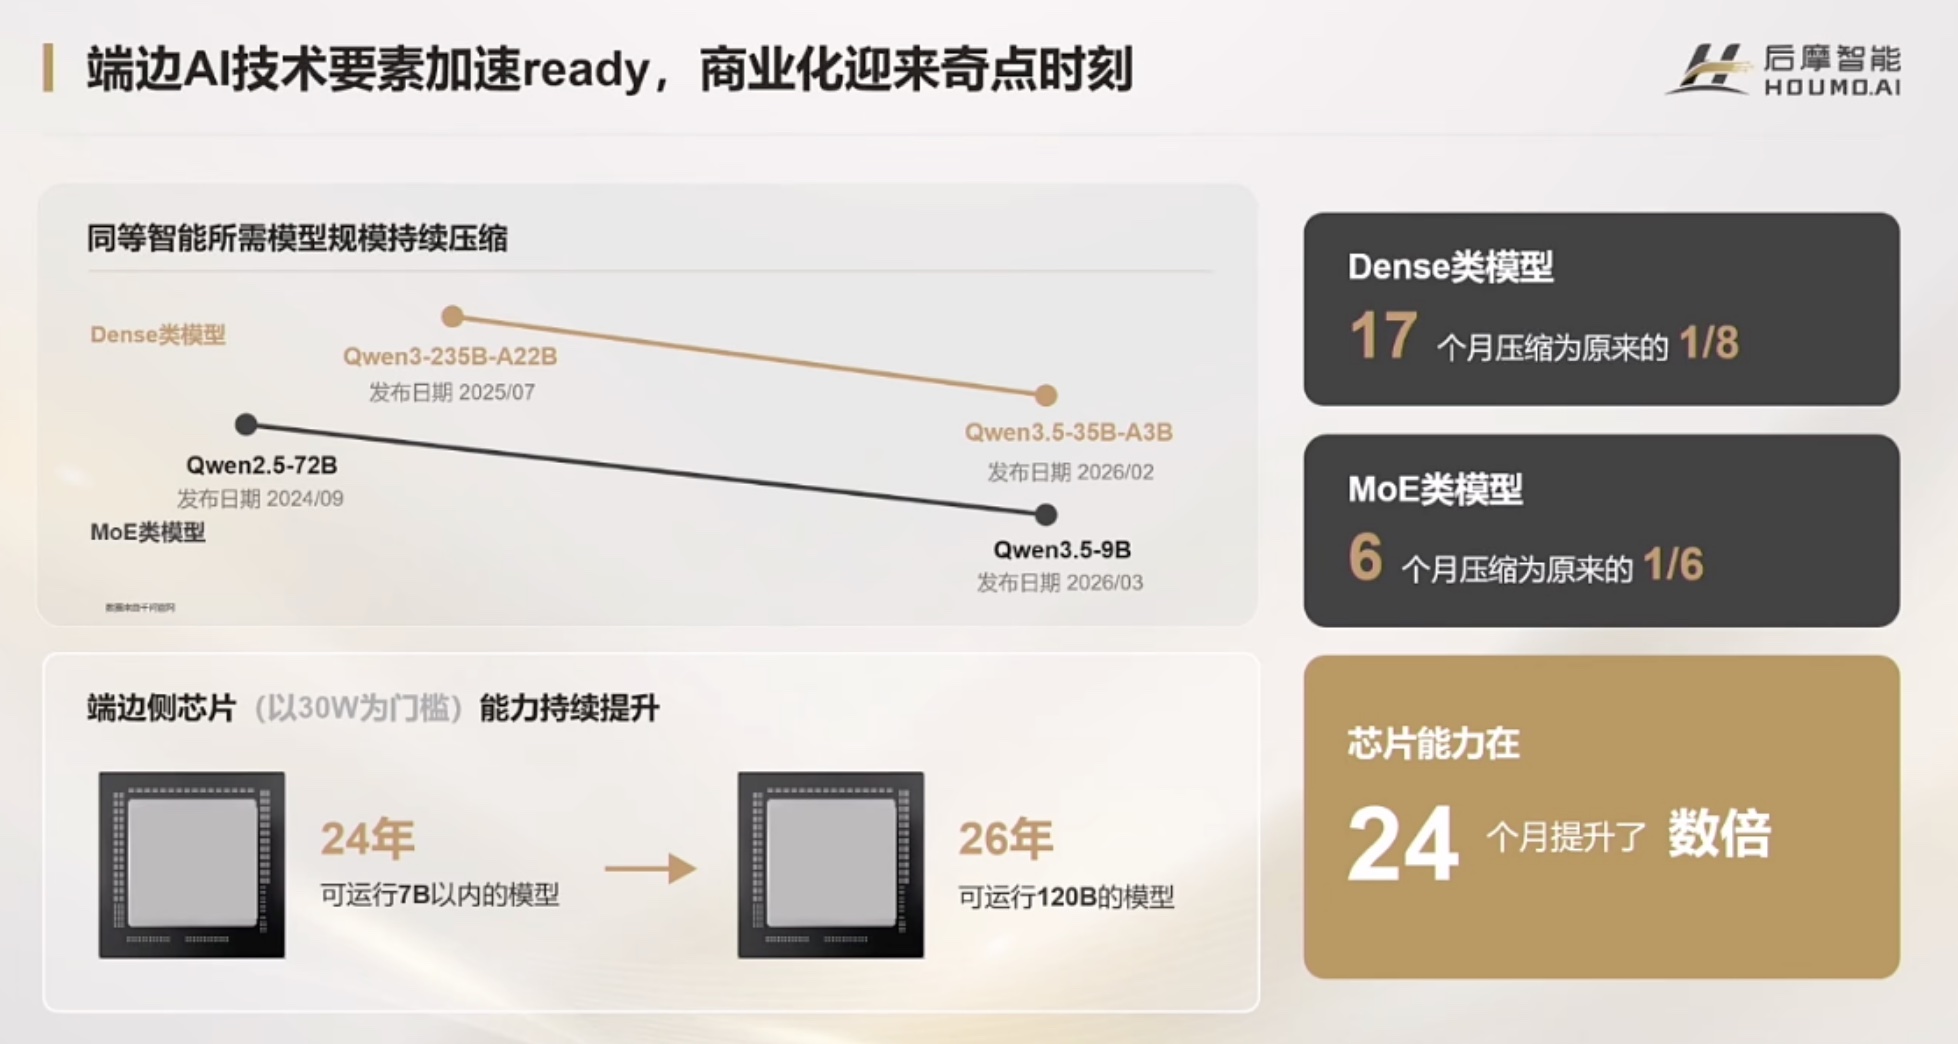
先来看当前模型的演进情况,我将Qwen的两个模型,MoE类和Dense类模型的数据拉出。在Dense模型,过去的17个月里,相同的智能,它的尺寸压缩到了原来的1/8,而MoE进展更快,6个月压缩为原来的1/6,整个模型的进展,演进速度是非常快的。
再来看底层芯片的进展,在2024年,端边芯片能跑的模型规模大概是7B,性能大概是10个token略多一点。但是到了今天,(端边芯片)已经能够跑120B的模型,而且性能远不止10个token的水平。
这两个核心技术的进步,已经打开了整个端边AI商业化的奇点。
第二点是AI应用情况。今年可谓是Agent元年,从年初的OpenClaw爆火到最近多款现象级的Agent平台的出现,例如Workbuddy、豆包,以及DeepSeek Harness等。Agent平台的出现会大大地加快AI应用的创新,因为大家不需要重复造轮子,会大大降低整个应用开发者的开发成本以及分发成本。
前两天有一个消息,英伟达可能要限制对Claude的使用。核心逻辑是大家不愿意把最核心的业务交给一个相对不可控的供应商。随着Agent的发展,尤其是当下时刻,随着AI Agent深度融入大众工作与生活,用户对智能体的安全性、可靠性与可信度提出了更高要求,普遍期待身边的智能应用能够安全可控、忠实可信。所以我的判断是未来的Agent,当大家越来越依赖于它的时候,数据隐私就会变得越来越重要。
二、端云AI协同共生,Token交互入口将成为AI产业竞争的关键阵地
怎么看待端边AI与云端的AI的关系?我个人的观点是,二者不是一个非此即彼的零和游戏,而是一个相互补充、相互协同的共生关系。
端边AI能做的事情已经越来越多了。未来AI的分层架构,已经非常明确。端侧与边缘AI适合处理敏感数据,承载各类高频应用;这类场景对极致智能能力要求不高,但能够有效降低整体部署成本。而云端AI可以处理复杂的业务,在数据隐私没这么敏感的时候,云端AI实际上是一个非常好的解决方案。
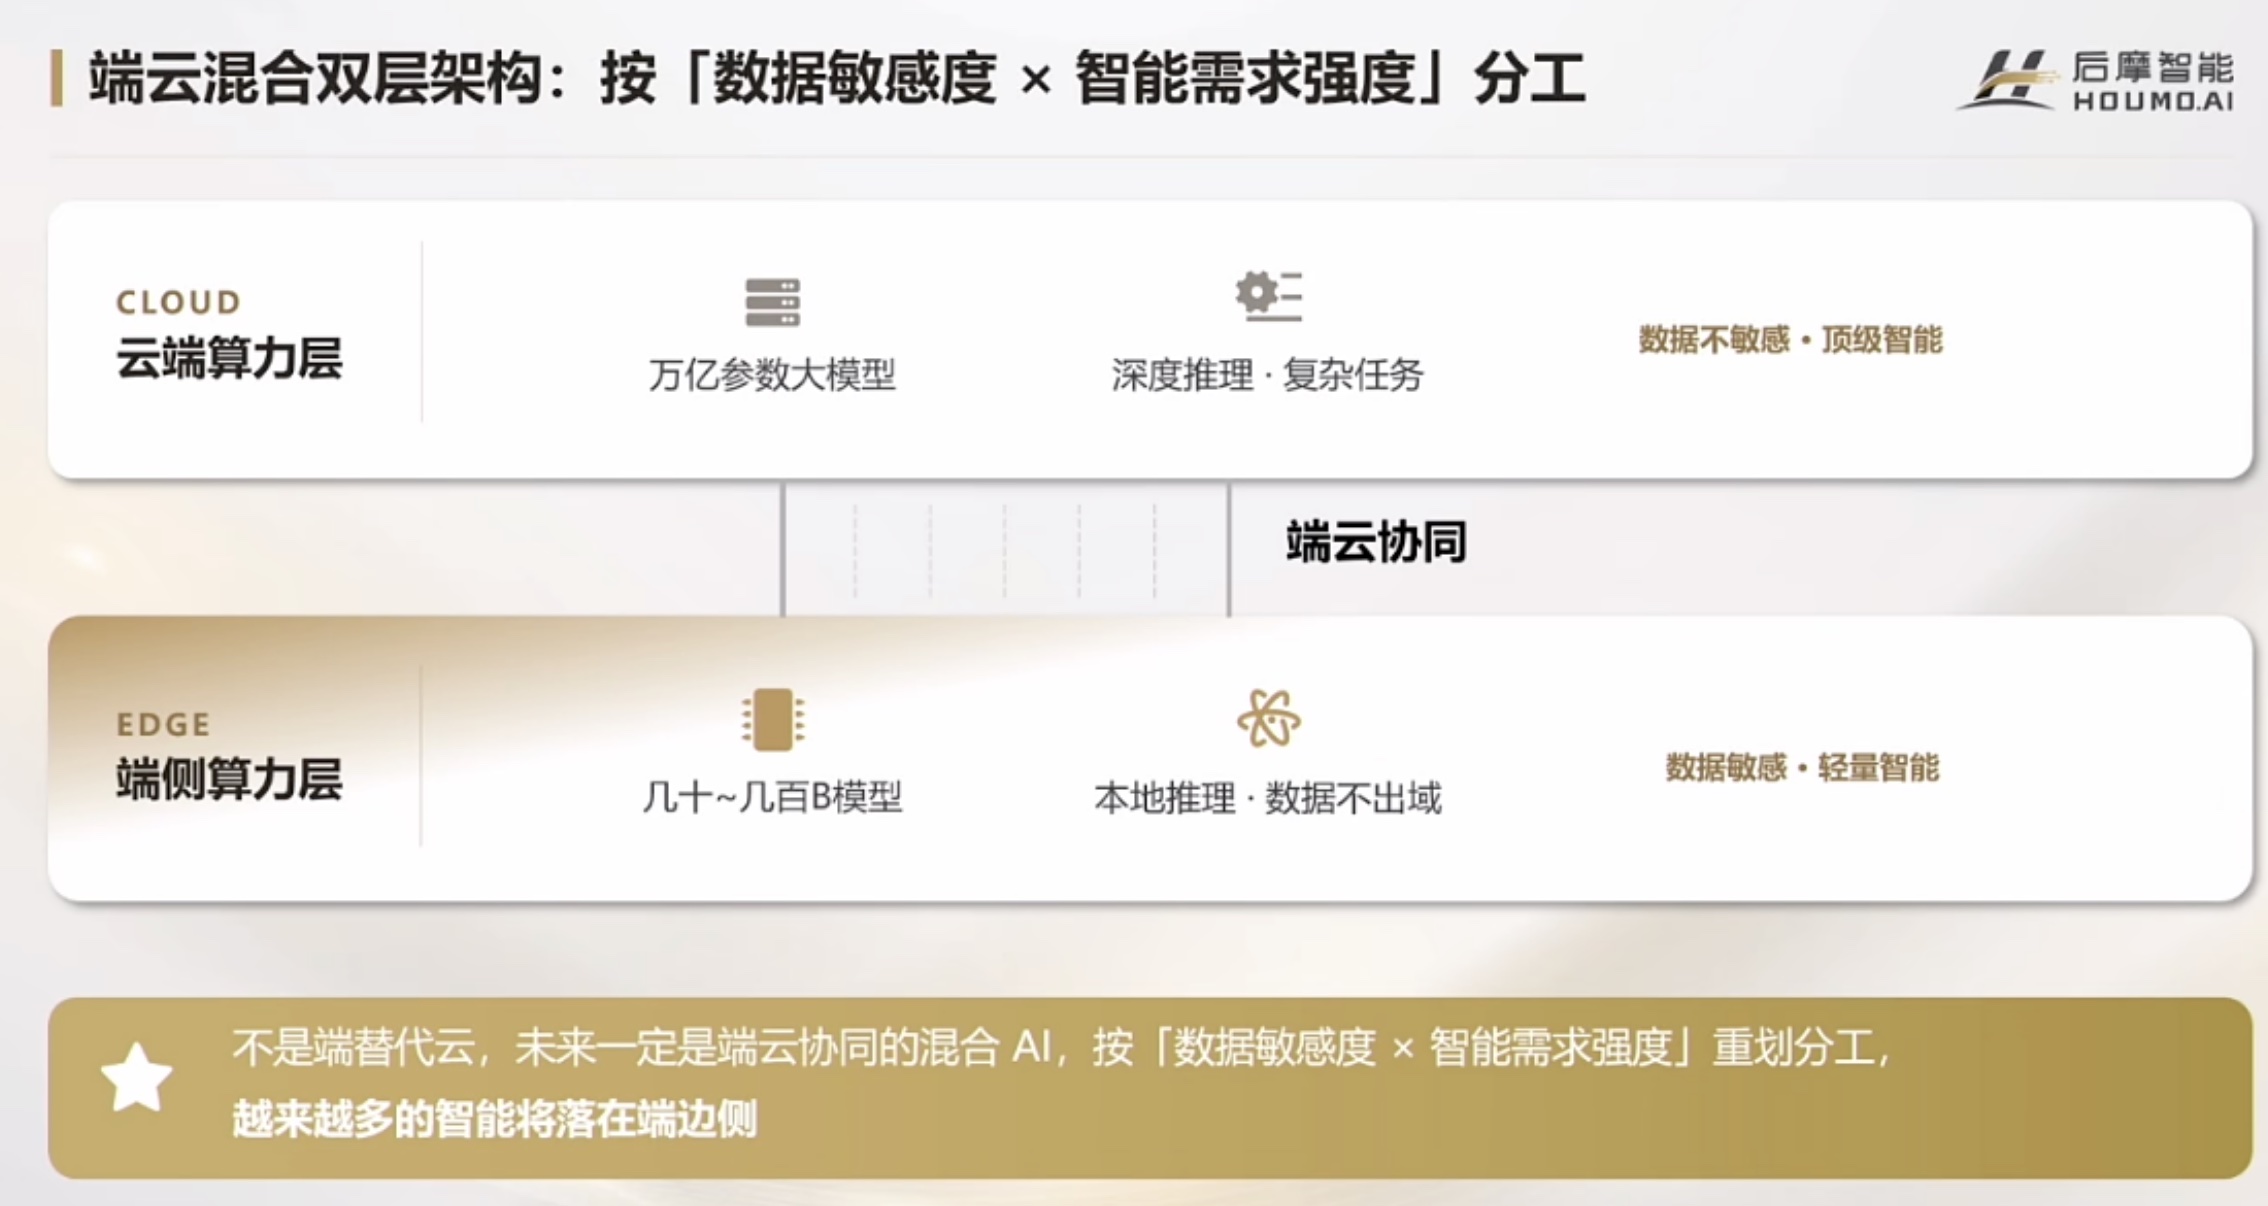
今年给我感受最强的两个buzzword(热词),第一个是Agent,另外一个是Token Factory。随着端边云协同架构逐步落地,Token交互入口将成AI产业竞争的关键阵地。在此背景下,端、边缘硬件平台类入口产品,有望成为行业下一阶段争夺焦点。
三、双路线技术迭代:2D/3D CIM体系破解算力、功耗、访存难题
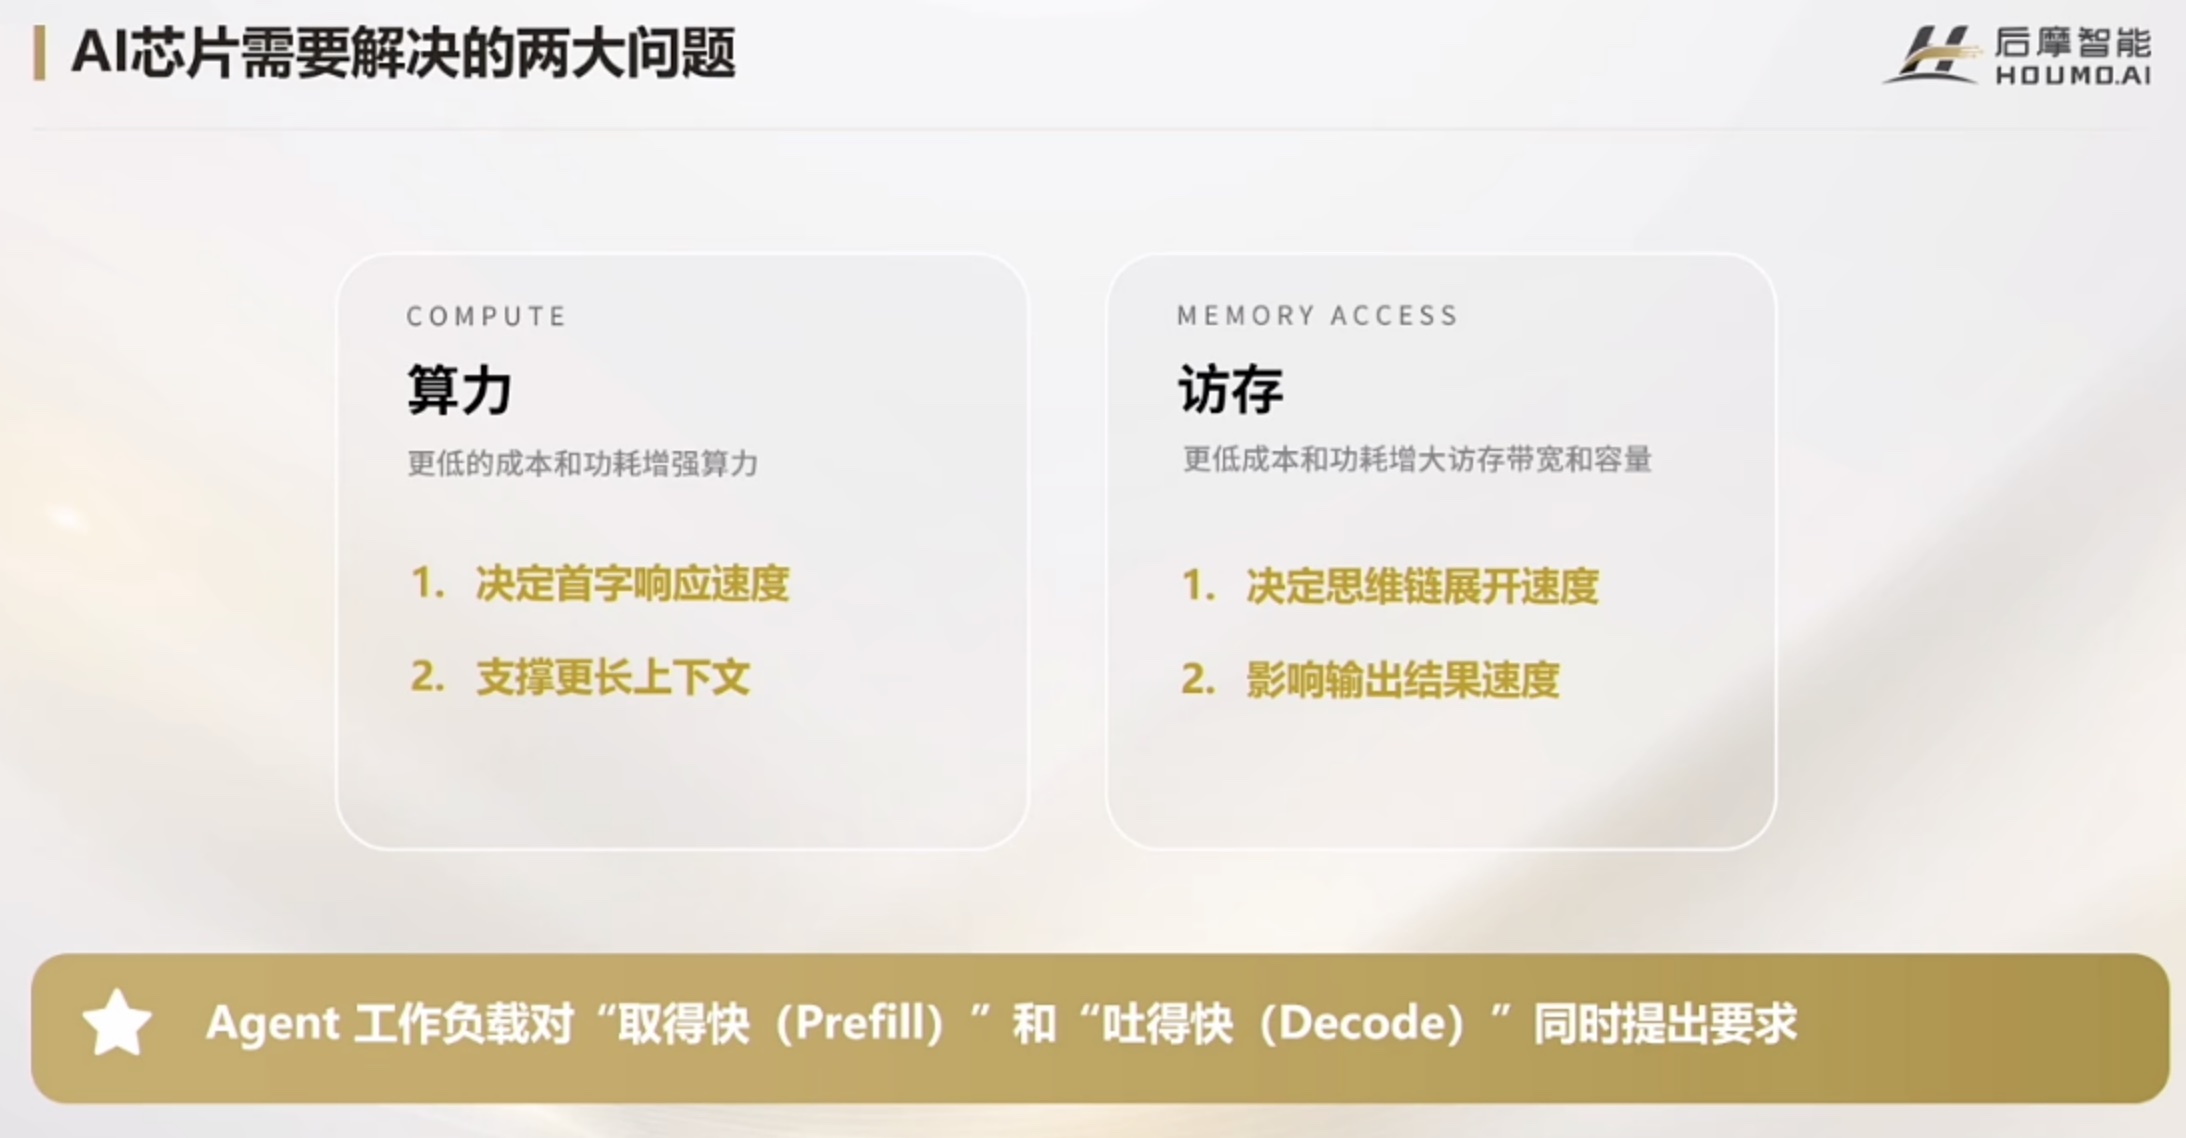
AI的应用是非常广泛的,但把它抽象到最底层,最核心就回答两个问题:怎么以更低的成本和功耗把算力做强做好?怎么以更低的成本和功耗把访存的带宽以及容量做上来?这两个技术路径也是推动我们内部整个技术路线演进的两个核心要素。
经过五六年工程迭代,我们持续深耕基于SRAM的CIM存内计算。从第二代产品PPA数据来看,采用SRAM存内计算方案,AI核面积可压缩至原有的2/5,功耗降至原来的1/5,能够有效解决算力瓶颈。

随着模型规模持续增大,行业也在探索用先进封装技术改善访存问题。近两年产业链多家企业研究基于DRAM的3D堆叠方案,借助Hybrid Bonding混合键合工艺,将DRAM存储层与底层计算层打孔互连,以此提升访存带宽。
DRAM 3D堆叠先进封装是极具潜力的技术路线,许多企业也投入资源开展相关研究,但该方案仍存在两大难点。
第一是算力受面积约束。该方案需要与存储厂商合作,存储芯片的裸片面积为标准化固定规格,无法按需定制。固定面积限制了底层计算逻辑层的设计空间;多层堆叠需要大量打孔互连,会产生类似建筑“公摊”的面积开销,进一步压缩可用于算力计算的有效面积,如何在有限面积内提升算力成为一大难题。
第二是散热压力。传统芯片为平面结构,而多层堆叠架构中底层计算层发热量大,多层叠放后热量难以导出,散热是另一项关键挑战。
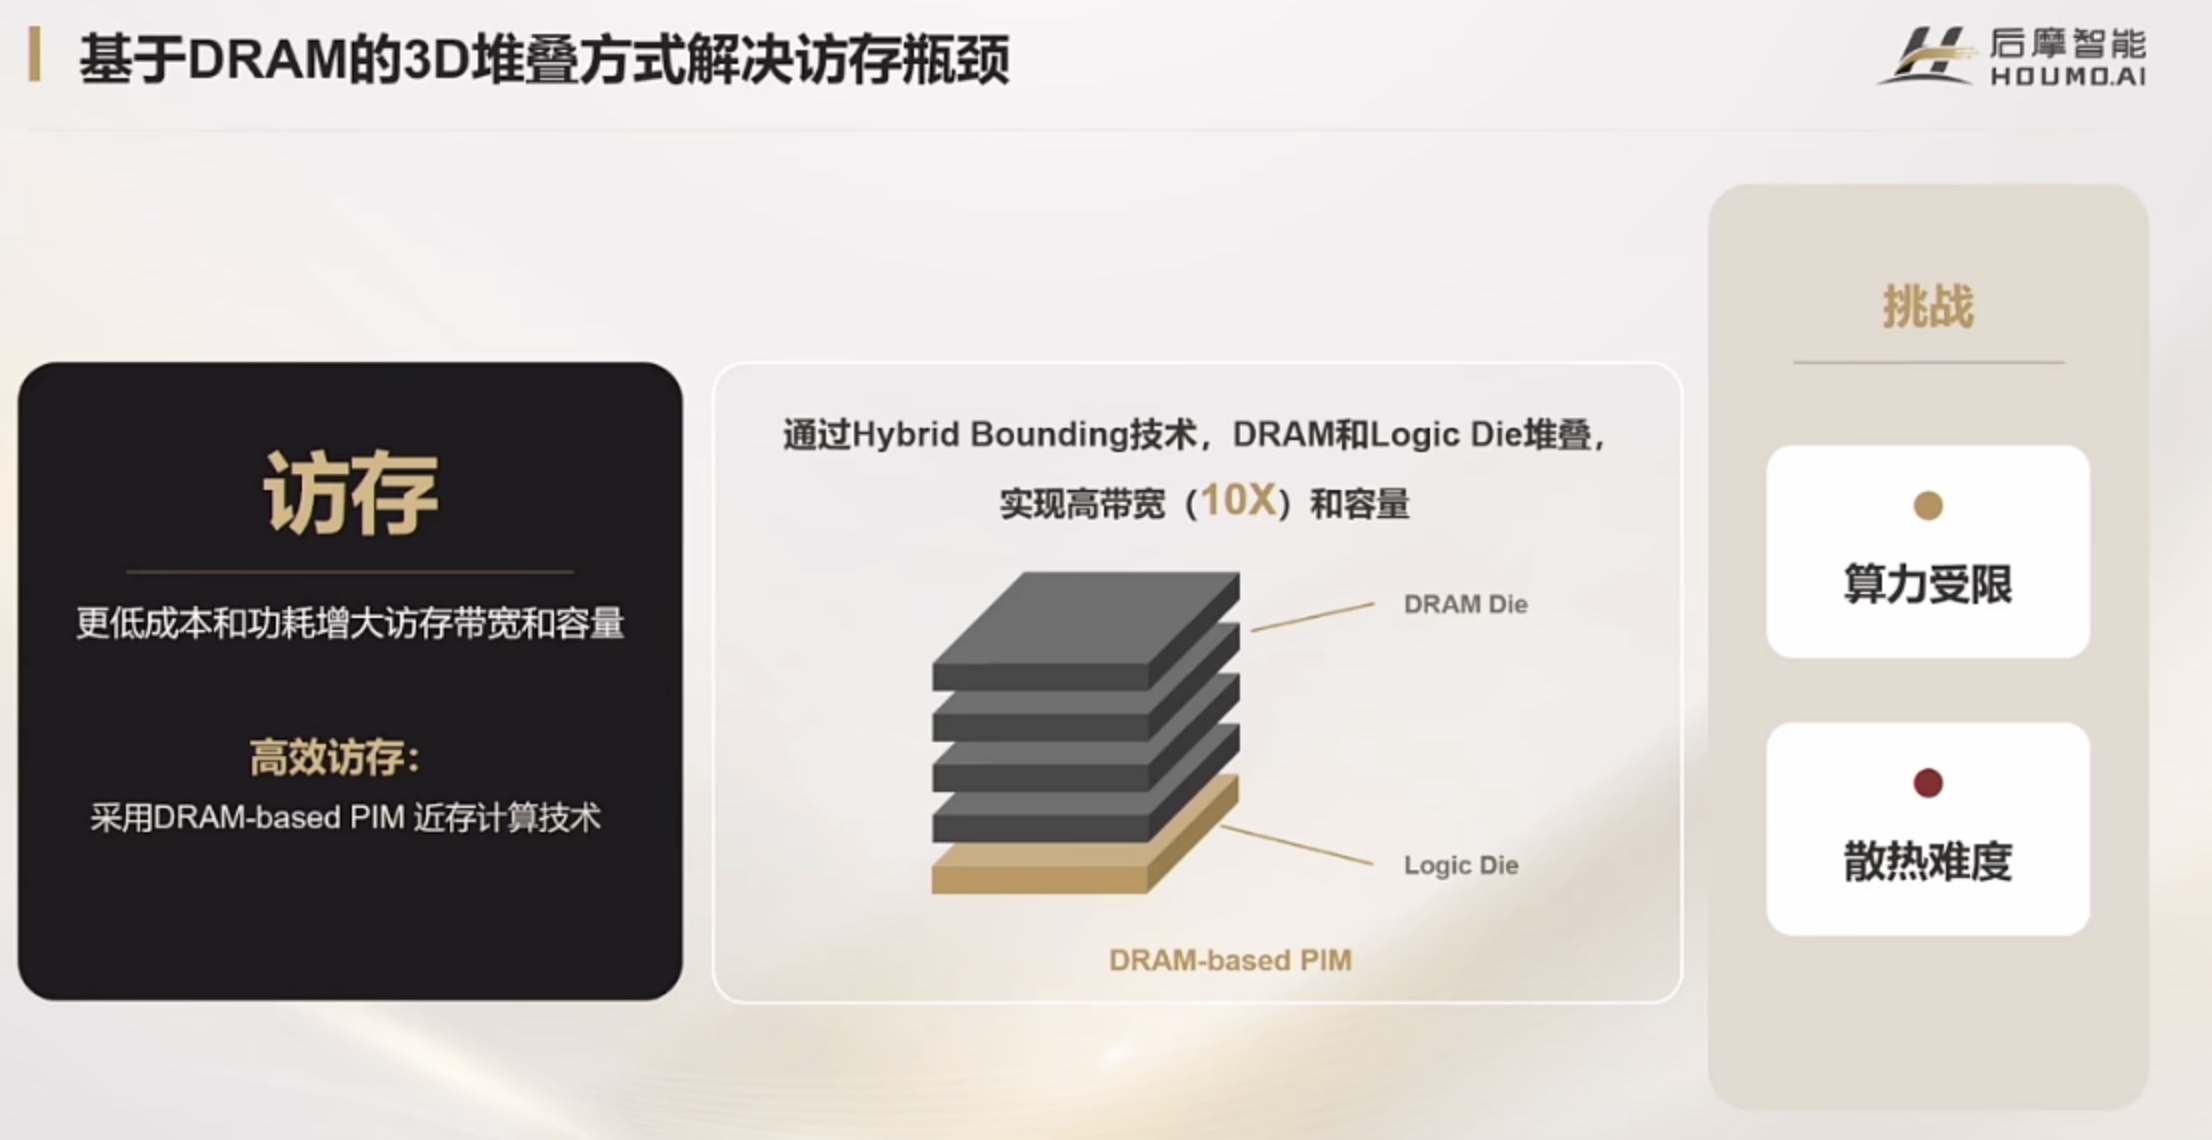
在探索DRAM 3D堆叠方案的过程中,我们团队架构师提出新思路:底层逻辑层采用自研2D SRAM基CIM存内计算架构进行堆叠,可缓解前述两大难题。在同等芯片面积下,该方案算力实现翻倍,功耗显著降低,改善原有路线算力受限、散热压力大的痛点。
这种方案看似效果理想,但落地仍需要大量研发投入。我们历时约两年研发,推出新一代3D CIM架构。该架构适配算力、访存需求相对均衡的场景,支撑开发更具市场竞争力的芯片产品。
我们将在10月后摩智能生态合作伙伴大会,透露基于3D CIM架构的全新产品A20相关信息。目前我们公司已形成2D CIM+3D CIM双技术体系,可针对端边多样化场景灵活搭配产品方案。
过往五年,公司已基于存算一体技术完成两代产品量产,包括M30与当前旗舰M50,并将持续迭代推出A20等新品。公司整体产品策略聚焦端边本地化大模型部署,解决行业普遍存在的Token压力与数据隐私焦虑。
旗舰芯片M50具备极致端边性能:指甲盖尺寸、功耗10瓦,可提供160TOPS算力,单芯片可流畅运行122B大模型。同时支持自研私有多片互联技术,可横向扩展算力、支撑更大模型与更高并发吞吐。产品持续优化成本与易用性,现已实现主流端边模型Day0首发适配能力。
结语:从实验室走向产业,存算一体正逐步获得认可
作为存算一体领域先行者,我们在技术探索中历经试错,所幸这条技术路线得到验证,成功将存算一体技术从实验室推向产业化。第二代产品M50量产至今不足一年,已收获超150个产品定点;相比数字本身,更重要的是该芯片打开了多个全新应用领域。
有客户基于M50开发出手机大小、可随身搭载的Personal AI设备,能够承载用户个人核心数据与偏好信息。客户表示,自大模型兴起便计划研发这类产品,寻觅方案长达两年,直到在后摩智能去年WAIC大会上看到M50才找到合适载体,我们便很快合作。
让我印象深刻的是客户的一句话:业界不缺AI芯片,缺的是能够真正解决客户实际问题的芯片。
过去一年,我们团队在推进商业化落地的同时持续拓展生态合作。目前产品已完成X86、Arm、RISC-V各类CPU的商业化适配落地,并联合众多IDH、ODM伙伴开发多形态硬件设备;操作系统层面也基本兼容市面主流系统。团队希望为客户提供易用、稳定可靠的AI基础设施,加速AI产品推向市场。
回顾IT产业发展,每一轮产业繁荣都依托底层架构支撑。PC时代成就英特尔,移动互联网时代让Arm成为主流。当前AI时代正在到来,行业同样需要全新底层架构。我认为,存算一体架构正逐步获得行业认可,持续赋能产业链各类合作伙伴。
以上是信晓旭演讲内容的完整整理。
