



机器人前瞻(公众号:robot_pro)
作者 | 刘俐杉
编辑 | 许丽思
机器人前瞻10月10日报道,10月8日,MIT韩松团队联合英伟达、香港大学和加州大学圣地亚哥分校发布了世界动作模型Long-WAM。
这套模型与系统协同框架,试图让机器人在满足实时控制要求的同时,扩展因果世界动作模型的上下文长度,利用其来辅助动作决策。
简单来说,Long-WAM能让机器人记住刚才发生了什么、预测接下来会发生什么,再决定怎么动,让机器人执行连续、复杂的操作任务时,学会利用过去的视觉信息,及时做出正确的动作。
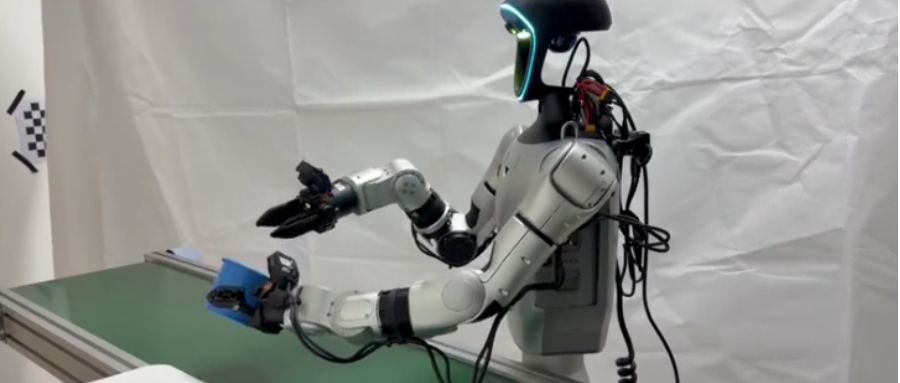
例如,机器人在叠杯子时,它不仅需要看清当前杯子的位置,还需要结合之前的动作,判断杯子是否已经放稳、下一步应该抓哪个杯子,以及怎样继续操作。
这些任务都需要机器人利用过去的视觉信息。但让模型处理更长的历史上下文信息,也会增加计算开销,拖慢动作响应。

▲机器人叠杯子
而Long-WAM关注的正是这个问题,延长视觉上下文长度,能否帮助机器人做出更好的动作决策?模型又该如何利用这些信息,同时保持实时响应?
在上下文长度延长了19秒的对比实验中,结果显示,模型任务成功率从63.3% 提升至78.7%。
仿真测试上,在LIBERO-Long、RoboTwin 2.0和DOMINO的测试中,Long-WAM的表现均优于其他对比方法。
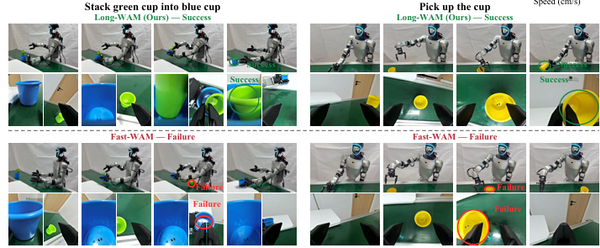
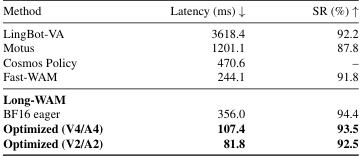
目前,Long-WAM已在Unitree G1和YAM机器人上实现实时部署,能够执行动态操作任务和长时程操作任务。例如,在动态堆叠杯子的任务中,其成功率达到95%;而π0.5和Fast-WAM在各自的20 次试验中均未取得成功。
一、先学预测未来,再学生成动作
机器人要及时做出动作,就得知道周围环境正在发生什么变化。单张图像可以显示物体的位置,却未必能说明物体如何运动,以及交互任务进行到哪一步。
世界动作模型(World-Action Models,WAM)将视频预测引入闭环控制 ,使视觉历史信息成为生成动作的重要依据。然而,处理更多历史信息也可能拖慢响应速度,反而影响控制效果。
那么,随着视觉上下文长度的增加,WAM的控制性能会发生怎样的变化?又该如何保证在实时响应的同时,发挥这些上下文的价值?
此前的WAM通过因果缓存、持久化记忆或筛选后的记忆来保留历史信息。但能够访问历史信息,并不等于模型已经学会根据历史信息进行预测。
而研究团队此次提出的Long-WAM,是一套模型与系统协同框架,该模型旨在满足实时控制要求的同时,扩展上下文长度。
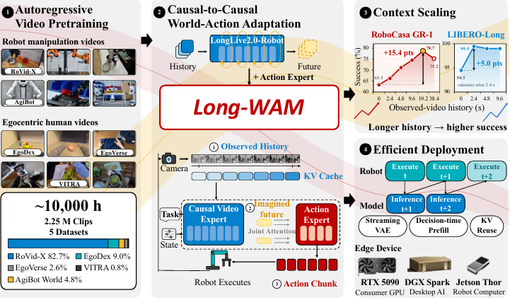
▲Long-WAM
团队发现,延长上下文能够带来多大收益,主要取决于视频基础模型采用了怎样的预训练方式。
因此,Long-WAM 采用分阶段的技术路线。首先,团队训练视频基础模型LongLive2.0-Robot。该模型在LongLive-2.0的自回归(Autoregressive,AR)视频模型基础上继续训练,使用了约1万小时的窗口等效视频数据,涵盖RoVid-X、AgiBot World、EgoDex、EgoVerse和VITRA等数据集。
这些数据包含不带动作标签的机器人视频和第一人称视角视频,模型通过预测后续视频内容,学习机器人如何运动,以及物体在交互过程中会发生怎样的变化。
随后,团队再训练模型生成机器人动作,同时保留此前学到的预测能力。也就是说,模型先学习场景和物体如何变化,再学习如何根据这些信息控制机器人。
完成视频预训练后,研究团队再将模型适配为世界动作模型,并保留原有的因果预测结构。
那么,延长历史信息又能带来多大的收益,在下文的基准测试中也得到了答案,团队延长了上下文长度将其进行对比实验。
二、在四个基准测试中,Long-WAM任务成功率均领先
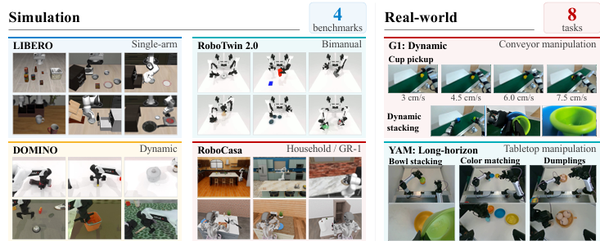
在评测方面,团队在LIBERO、RoboTwin 2.0、DOMINO和RoboCasa GR-1四个基准测试,以及在宇树 G1人形机器人、YAM双臂操作机器人上开展的8种真实任务配置中评估模型性能。
结果显示,在RoboCasa的GR-1任务中,团队将上下文长度从0秒延长至19.2秒后,模型任务成功率从63.3%提升至78.7%。

▲RoboCasa GR-1评测
而相比之下,采用双向预训练模型初始化的方案并未取得整体收益。进一步使用机器人领域数据进行自回归预训练后,模型在GR-1和LIBERO-Long上的最高任务成功率也得到提升。
在LIBERO-Long、RoboTwin 2.0和DOMINO的测试中,Long-WAM的表现均优于其他对比方法。
其中,在LIBERO-Long测试中,该模型任务成功率达到99.5%,其成功率分别比LingBot-VA和Fast-WAM高出1.0和4.3个百分点。
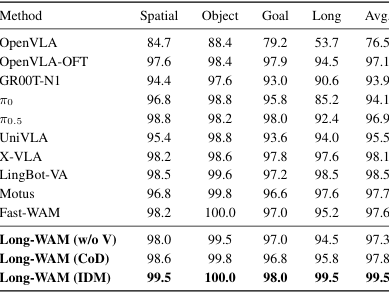
▲LIBERO评测
在RoboTwin 2.0上,该模型平均成功率高达94.4%,Clean测试中,成功率达到94.7%,同样排名第一。在Randomized测试中,其成功率为94.2%。Long-WAM的平均成功率分别比ABot-M0.5和LingBot-VA 2.0高出0.3和0.8个百分点。
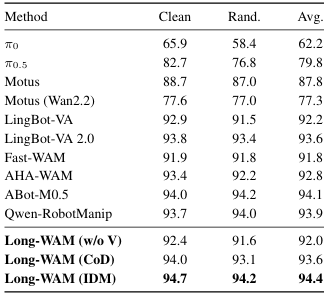
▲RoboTwin 2.0评测
DOMINO,在使用动态场景数据进行微调后,Long-WAM取得了34.9%的成功率和45.1的MS指标得分。在这两项指标上,它均超过了表现最好的对比方法,成功率比Fast-WAM高出15.0个百分点,MS得分比PUMA高出10.1分。
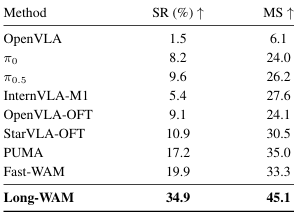
▲DOMINO评测结果
此外,团队还测试了Long-WAM与高层规划器协同执行复合任务的能力。在RoboCasa的任务中,单独使用GPT-6 Astra作为规划器时,整体任务成功率为25.2%;将其与π0.5结合后,成功率为30.5%;而与Long-WAM结合后,整体成功率达到54.4%。
在未见过的任务组合中,Long-WAM分层系统的成功率达到35.0%,高于单独使用GPT-6 Astra时的20.8%,也高于π0.5分层系统的19.0%。
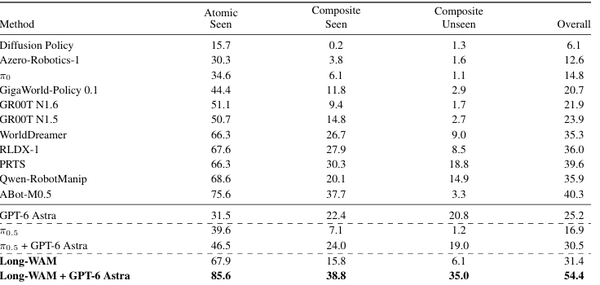
▲RoboCasa的成功率
从整体任务成功率来看,引入高层规划后,Long-WAM的成功率提高了23.0个百分点,而π0.5提高了13.6个百分点。这表明,执行能力越强,上层规划所带来的收益就可能越大。
三、让机器人完成抓取、堆叠动作,8种真实任务验证执行能力
除了在评测上验证模型性能外,团队还将模型搭载至宇树 G1人形机器人和YAM双臂操作机器人上,开展8种真实任务。
四、结语:上下文信息,成为世界动作模型提升能力的关键
Long-WAM能做的,是让机器人在实时控制中记住过去发生了什么、预测接下来会发生什么,再决定怎么动。在叠杯子、抓传送带、长时程操作等任务中,它验证了这套思路的可行性:上下文越长,模型可参考的历史信息越多,连续任务中的动作决策也更稳定。
对于产业而言,这意味着上下文逐渐成为生成式机器人控制的重要资源,它的价值不仅取决于模型能否通过预训练学会预测未来,也取决于系统能否在实时约束下及时执行动作。
但从实验室测试走向更广泛的真实应用,模型仍需在更多机器人本体、任务类型和复杂环境中接受检验。如何在动作精度与长期任务成功率之间取得平衡,仍是世界动作模型需要持续解决的问题。
