


9月21日,在智猩猩联合主办的2026全球AI芯片峰会上,沨呵智慧智算产品总监 丁阔分享了《基于精益智算的高质量Token生产实现》主题演讲。
丁阔在演讲中提到,围绕能耗、产能和售卖效率等维度,他们基于两大指标建立了Token工厂的运营指标体系。
其中 TEF(Token效率因子)用来衡量GPU集群生产Token的效率,由GPU可用率、算力占用率和有效计算效率共同决定;TFI(Token工厂指数)用于评估商用Token平台的售卖情况,将TEF与服务交付率、Token售出率、价格实现率进行结合。
通过TEF和TFI,Token工厂可以形成飞轮效应,企业能够凭借对两大指标中参数的诊断和调整,从而改善Token业务的利润,满足企业经营的目标。
沨呵智慧如今的产品交付形态已经从底层算力资源逐步走向标准化的Token产能。
以下是演讲整理:
丁阔:大家上午好,我是来自上海沨呵智慧的丁阔,非常感谢主办方的邀请。今天借这个机会,我想跟大家分享一下我们基于精益智算的高质量 Token 生产的一些思考。
一、AI云厂商处于价值链的“收租位置”

根据巴克莱银行最新统计,在 OpenAI、Anthropic 等厂商每 100 美元的大模型 AI 收入中,有 35 到 40 美元流向 AWS、微软、谷歌等 AI 云厂商,其中 10 到 20 美元直接变成这些厂商的利润,约占其营业利润的 35% 到 45%。
那么 AI 算力是什么样的盈利模式呢?
(1)商业模式。AI 算力集群通过扩容不断摊销边际成本。
(2)规模与先发。云厂商很早就提供云服务、金融云的服务,积累了大量存量用户,数据中心网络也遍布全球,从原来的云服务迁移到 AI 算力顺理成章。
(3)全栈整合。云厂商除了提供 AI Token,也提供全栈服务。在 Agent、OpenClaw 这类应用火起来之后,芯片、存储与网络资源的销量也大幅增长。
(4)需求刚性。大模型厂商除自建算力外,很大一部分依赖租算力,而租算力往往要签订非常长期的采购合同。
除去上面提到的云厂商,国际市场上还有另外一类玩家,我们称之为 Neocloud,可以理解为”专卖店”型的 GPU 云。Neocloud 只提供高质量、高性价比的 GPU 算力服务,实际上是 AI 云大厂在资源上的一种互补。
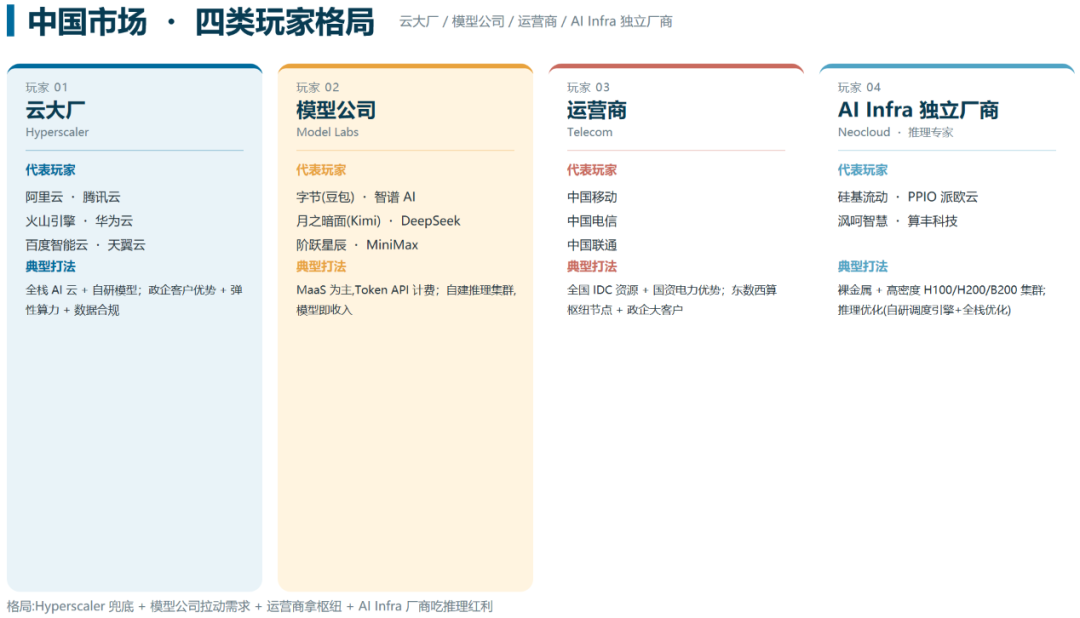
国内市场主要有四类玩家。第一类是云大厂,比如阿里、腾讯、火山等;第二类是模型公司,字节、智谱、Kimi、DeepSeek 等,对算力集群的需求量非常大;第三类是运营商,算力的”国家队”,由整个基础设施托底;第四类是 AI Infra 独立厂商。
AI Infra 独立厂商又可细分为两类:一类是以硅基流动和 PPIO 为代表,类似于 Neocloud,有自持的 GPU 集群和算力;另一类是以沨呵智慧为代表,没有自持算力,但提供全栈自研的推理优化引擎,并为客户提供全栈的优化服务与管理平台。
二、算力交付形态全面转向Token工厂
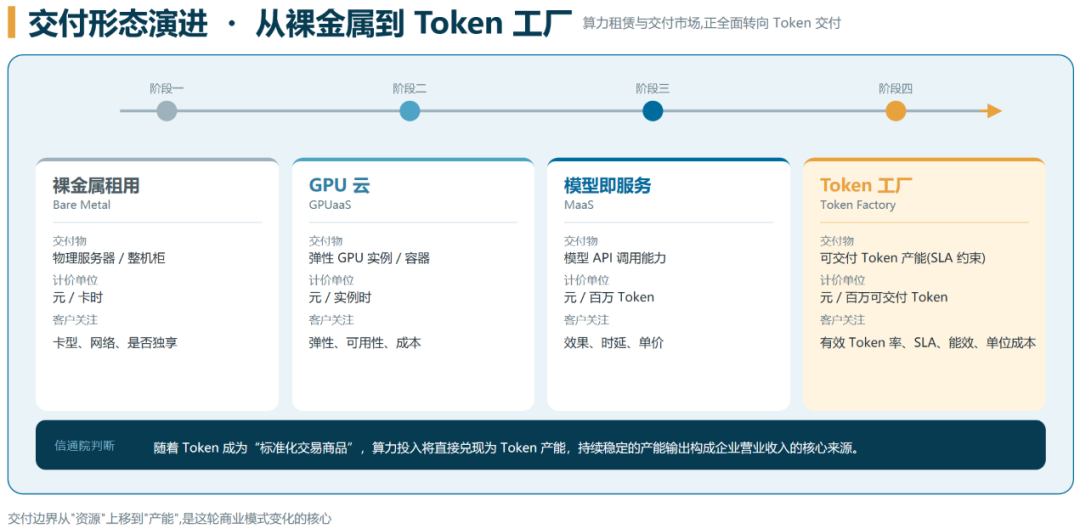
再看算力的交付形态,从最早的裸金属租赁;到 GPU 云的弹性 GPU 实例;再到 MaaS(模型即服务);最后到最新阶段——直接交付 Token 工厂(Token Factory)。Token 工厂可以理解为在 MaaS 的基础之上,加了一层 SLA 约束:针对某些模型,提供高质量的 Token。
从整个过程的变化趋势来看,我们从交付裸金属这样的原始设备,到最后交付 Token,实际上是从资源交付变成了产能交付。
三、Token输出如何才能满足当前智能体的使用需求?
随着算力交付形态的变化,Token 的衡量指标也发生了变化:最早关注 TTFT、时延、吞吐等参数;到了 Token 工厂交付阶段,则同时关注经济层面——Token 生产是否划算、能耗效率是否够高,此外Token 交付还非常关注交付质量与稳定性。
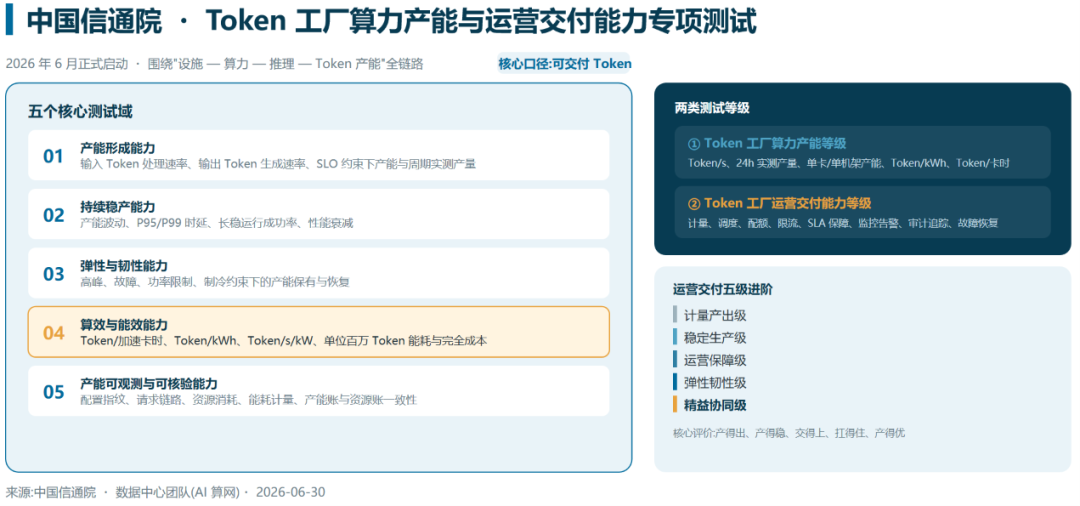
在国家层面,中国信通院今年 6 月已提出产能和运营交付能力的专项测试,包括五个测试域:
- 一是产能形成能力,即以什么样的速率和吞吐量形成 SLO 达标的产能;
- 二是持续提供产能的能力;
- 三是弹性和韧性,故障情况下能否持续保持并恢复;
- 四是算效与能效能力,平稳运行、平稳提供产能时的能耗水平;
- 五是产能可观测与可核验能力,即通过可观测性对产能进行运维维护。
信通院主要通过两类测试进行评级:产能等级测试和运营交付能力测试。
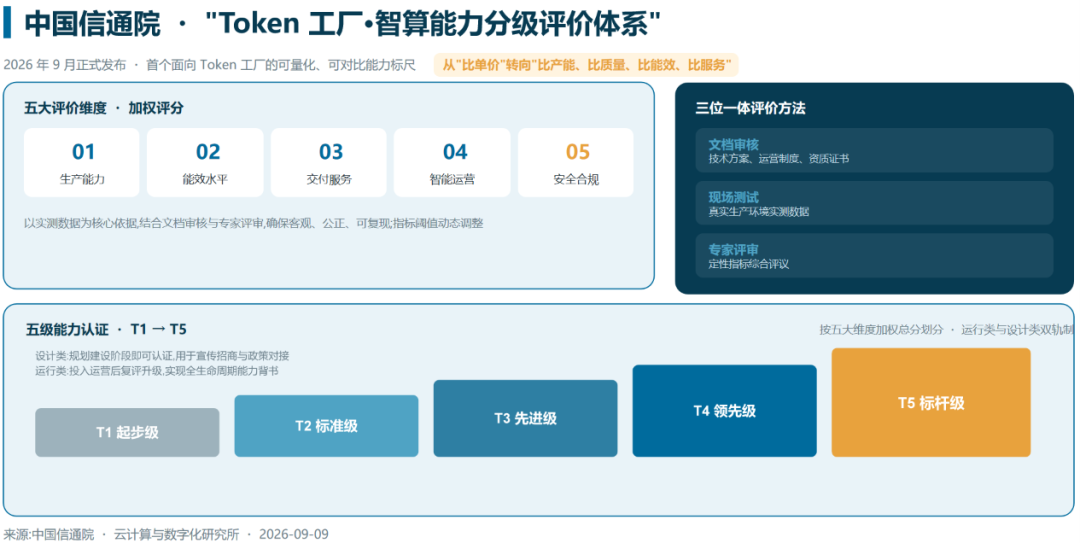
此外,信通院 9 月还发布了能力评分体系,它通过”三位一体”的测评方法(文档审核、现场测试、专家测评)在生产能力、能效水平、交付服务、智能运营、安全合规五大维度上,对所有 Token 工厂进行测评,评出不同等级。
什么样的 Token 输出,才能满足当前智能体的使用需求?在整个能力评分体系里,通过信通院的标准可以得到很好的度量。
四、Token效率因子衡量产能效率
沨呵智慧还对 Token 生产的产能与能耗、以及 Token 售卖的效率,提出了自己的一些思考。
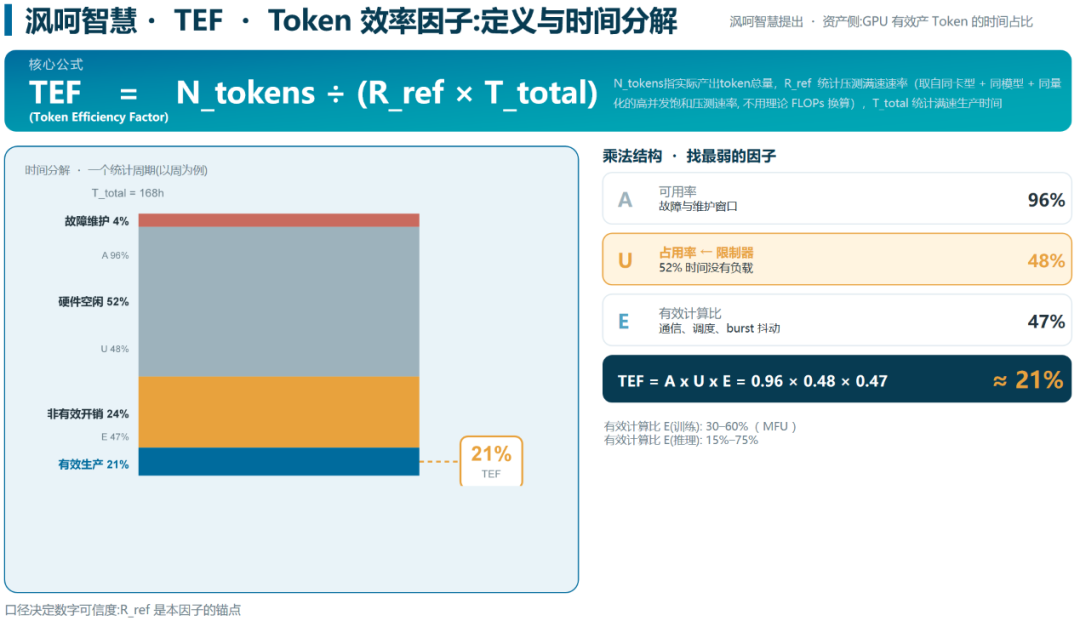
第一个是 TEF,即 Token 效率因子(Token Efficiency Factor)。直观理解:用当前生产的所有 Token 总量(N_tokens),除以 GPU 集群满载满速时的速率(R_ref)与满载生产时间(T_total)的乘积,从而得到用来衡量 GPU 集群在正常部署情况下的运行效率和产出效率。
从拆解角度看:以一周 168 小时的日历周期为例,假设集群有 96% 的时间可用;在可用时间中,由于集群可能没卖出去,假设未售出部分占 52%,那么真正处于生产的时间为 48%,即占用率 48%。分布式训练通常在 30% 到 60% 左右,分布式推理更高一些,在 15% 到 75% 的区间。假设有效计算比为 47%。则有算式:TEF = 可用率 × 占用率 × 效率,得到 21%。我们认为优秀的水平线,是 TEF 达到 40% 以上。
在平台开发和交付过程中,我们会采用很多技术手段:Continuous Batching、PagedAttention 等开源推理框架自带的加速技术,还有 Prefix Cache、投机解码,以及前面讲到的 PD 分离等。所有这些技术往往只能给出使用前后的效率提升,却很难衡量某一项技术对整个 GPU 集群的作用因子与整体提升比例。
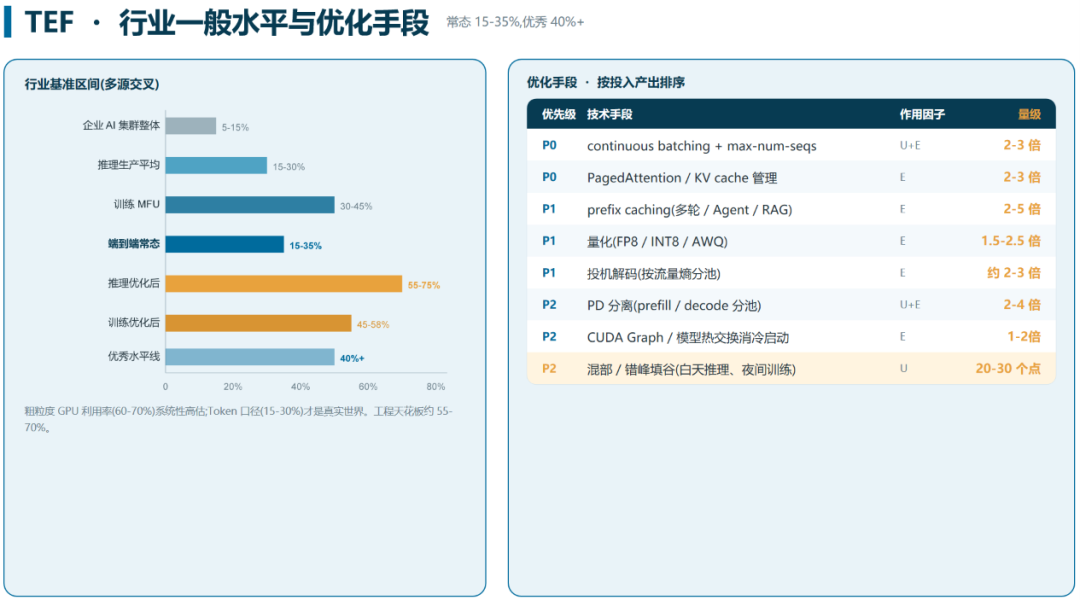
通过 TEF,我们可以看到最基础的推理框架对整个推理效率的提升非常大,作用点在占用率和有效计算比;而在推理框架之上做的投机解码、量化、PD 分离等第二层级的优化手段,也能看到各自的提升比例。我们希望通过这一指标,把所有优化技术与它的提升比例关联起来。这是一个产能层面的衡量指标。
五、Token工厂指数衡量售卖效率
第二个层面,我们提出了 TFI,即 Token 工厂指数(Token Factory Index)。
TEF 衡量的是产能效率,TFI 衡量的是售卖效率:生产了这么多 Token,卖出去的效率到底高不高?

这一点我们也认为非常重要。直观计算也很简单:用所有付费 Token 的生产时间,除以 GPU 日历时间,即可得到一个比例。
从拆解的角度,我们也希望得到一个算式。GPU 集群是按一定的效率在生产,那么售卖环节的效率是什么样的呢?第一是服务交付效率,可以理解为 SLA,即稳定性;第二是 Token 售卖率,我们生产的 Token 有时打折,有时为促销会免费送;最后,TFI = TEF × 交付率(SLA)× 售出率 × ρ,其中 ρ 是折扣系数,即计费系统挂牌价与实际售卖价格之间的比例。
TFI 的行业水平,我们从三个维度来看:
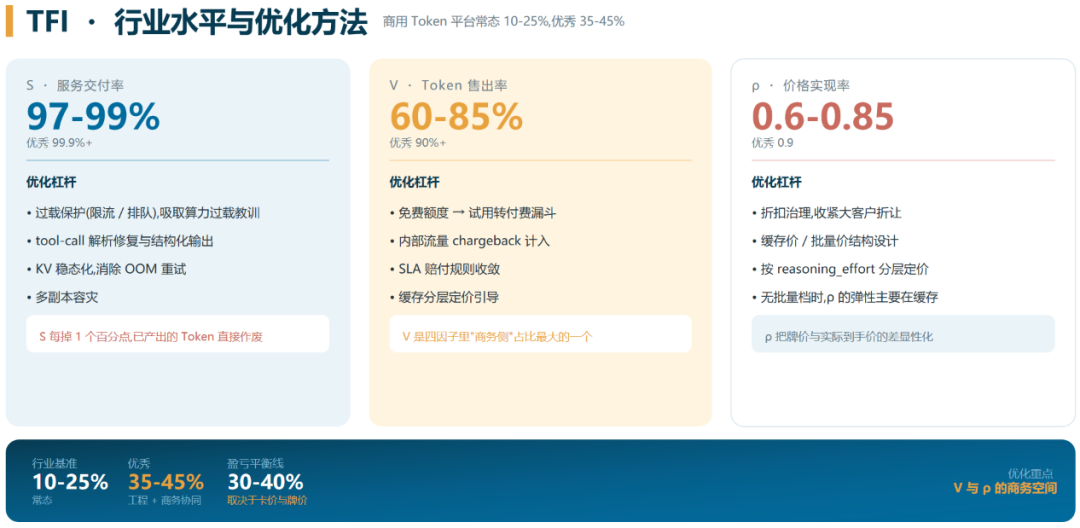
首先是服务交付率。我们希望达到 99.9% 以上才算优秀,这主要通过集群整体的稳定性,以及容灾备份、过载保护等技术手段来满足。
其次是售出率。这与 Token 工厂的运营手段相关:一开始可能只是免费提供,那么这些免费试用的 Token 如何通过付费漏斗转化为付费客户?
最后是价格实现率。很多时候会打折扣,这些折扣是不是都要收回来,批发等价格是不是要做定价调整。
通过这三个维度,我们不断优化整个售卖模型和运营模型。我们认为 TFI 达到 35% 到 45%,就是 Token 工厂在售卖维度上的优秀水平。
六、TEF与TFI驱动 Token工厂飞轮效应
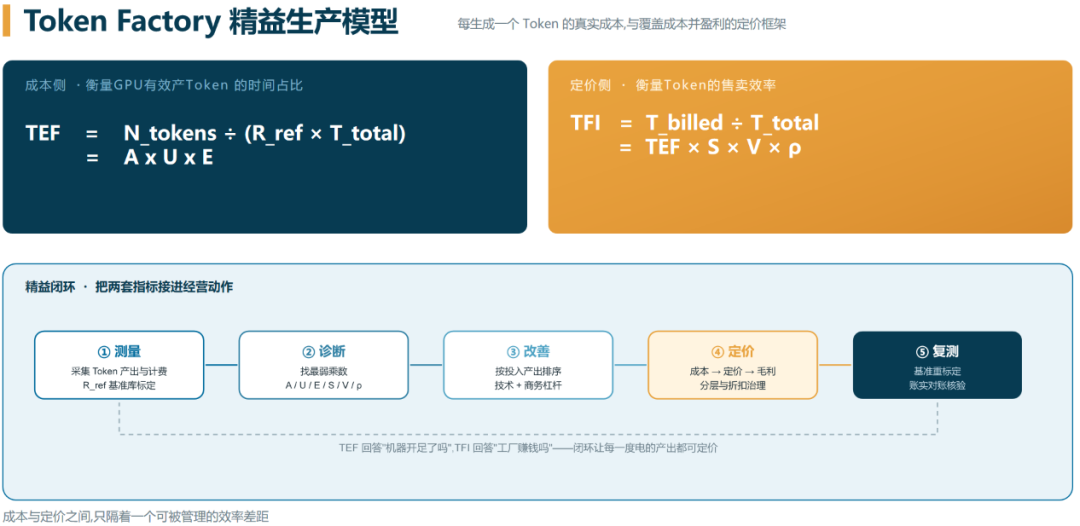
Token 工厂通过 TEF 和 TFI 两个指标,会形成一个运转的飞轮:
- 先测量当前的 TEF、TFI 值,再诊断两个指标中所有参数的当前状况;
- 调整每一个参数,就会得到一个改善的结果,最终带来相应的毛利和利润;
- 再看这些毛利利润能否满足企业经营的目标,或者 Token 工厂利润交付的目标;
- 如果不满足,就通过飞轮不断调整,形成飞轮效应,让整个 Token 工厂的经营生产模型运转起来。
这就是我们整体的经营生产理念。
七、精益智算产品矩阵与敏捷交付
沨呵智慧是一家专注于 AI Infra 以及 Agent Infra 的专业服务厂商。目前我们没有对外提供 Token 服务,但会通过产品和专业服务,去满足智算中心、Token 工厂这些客户提升运营效率的需求。

首先是训推平台,以及 Token 服务系统。通过训推平台,满足客户在智算场景下分布式训练与推理两大主要场景的需求;通过 Token 服务系统,实现 TEF、TFI 指标的观测和飞轮效应的提升。通过这一组合,我们帮助 Token 工厂以及使用 Token 的厂商获得比较优质的 Token。
同时,我们也不只是做平台,还提供全栈优化。存储层面,针对训练场景自研了训练侧以及推理侧的专用存储;我们与英伟达合作,结合 BlueField 芯片做整体的 KV Cache 卸载。网络层面,我们也提供千卡、万卡训练集群的网络优化。所以从产品层面,到智算中心、Token 工厂建设层面所有需要的环节,包括网络存储以及平台调度等,我们都提供全栈服务。

最后交付客户是以 Token 工厂敏捷交付方式。我们会与客户做一个准备清单,包括算力服务器、网络集群,以及机房和物理设备的准备情况,保证平台以及软硬一体系统接入时,客户侧的资源准备就绪。
同时,我们提供的 Token 工厂清单里会包括 Token 工厂运营门户,通过 TEF、TFI 等指标做飞轮效应,提升 Token 工厂的效率;以及训推管理平台,用于管理 GPU 集群,满足智算中心训练和推理场景的要求;最后,在存储和网络上,我们会根据客户业务场景的选择进行配合。
通过这两份清单,我们保证 Token 工厂的敏捷交付,为智算中心客户、Token 工厂客户实现最大的价值。
以上就是我的分享,谢谢。
