




智东西(公众号:zhidxcom)
编译 | 黄菲
编辑 | 江宇
智东西10月29日消息,今日,英伟达发布并开源语音模型Nemotron 3.5 Transcribe,该模型整合了语音转写、多人发言识别等能力,在英文语音识别的9个公开测试集上,其平均词错误率(WER)为4.71%,优于阿里巴巴的Qwen3-ASR-1.7B(4.94%)。该模型支持40种语言,最长可处理1小时录音,用户无需微调便可通过自然语言指令调整转写风格。
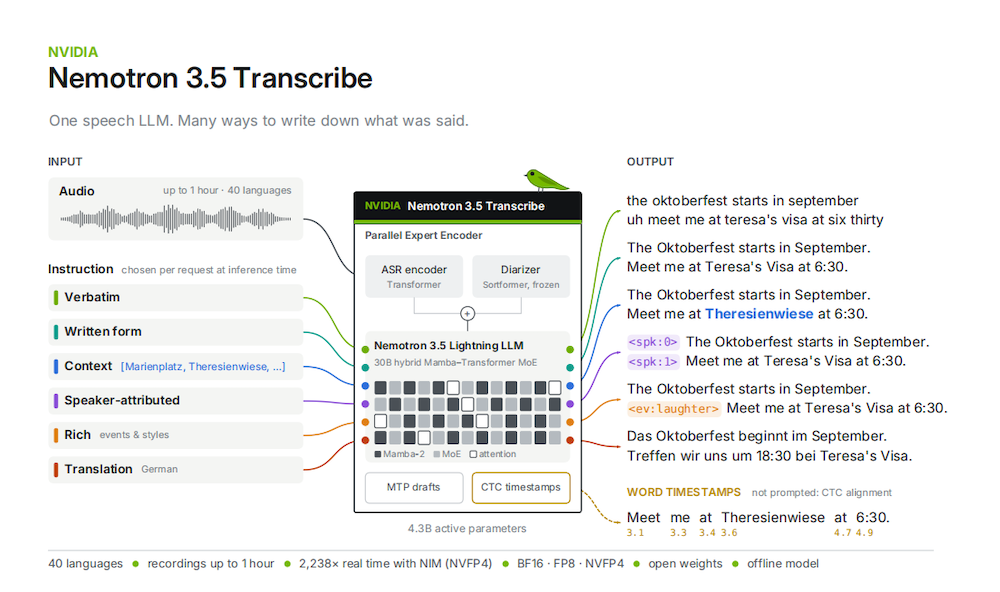 ▲英伟达发布开源语音模型Nemotron 3.5 Transcribe,来源:NVIDIA
从模型参数来看,Nemotron 3.5 Transcribe的总参数量约为340亿,每次推理时激活的参数量约为43亿。
在英文语音识别测试中,该模型在9个公开测试集上的平均词错误率(WER)为4.71%,低于表中其他语音模型。
在多语言语音识别测试中,该模型的平均WER为4.62%,排名第三,优于Qwen3-ASR-1.7B、Voxtral-Small-24B和Whisper-large-v3,但表现不及ElevenLabs Scribe v2和Azure Speech。
传统语音识别系统主要负责将语音转换为文字,而Nemotron 3.5 Transcribe还能根据任务需求调整转写文本的形式,结合上下文提高专有名词的识别准确率,并标注不同说话人的发言。
一、单模型支持六种转写,覆盖40种语言
Nemotron 3.5 Transcribe支持六种可通过指令切换的转写形态,分别是逐字转写、书面化转写、上下文辅助转写、标注说话人的转写、包含非言语信息的丰富转写,以及语音翻译。
其中,逐字转写侧重保留原始语音内容,书面化转写则会根据书面表达习惯调整文本。上下文辅助转写可以利用用户提供的专有名词等信息改善识别结果;标注说话人的转写会区分不同发言者;丰富转写还可记录笑声等非言语信息;语音翻译则将语音内容转换为目标语言。
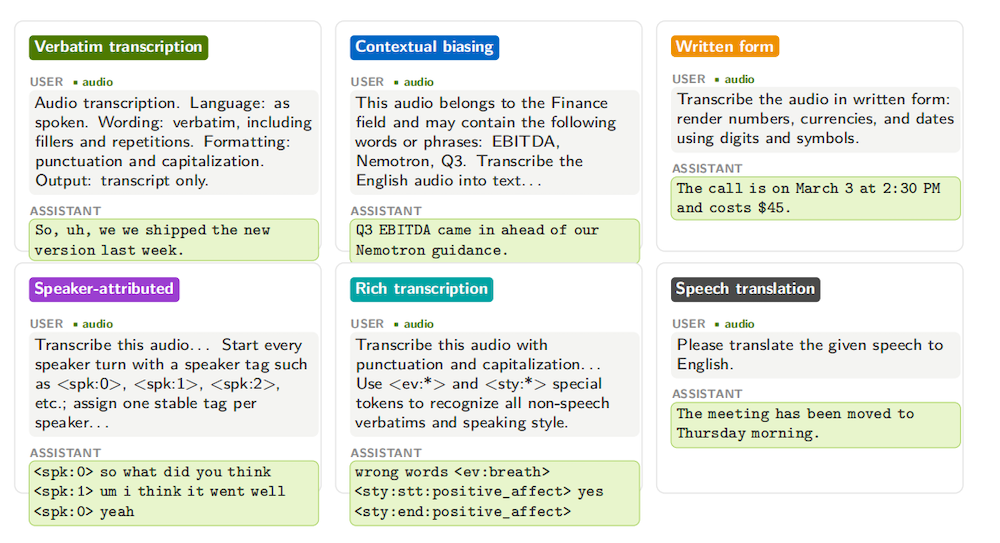 ▲Nemotron 3.5 Transcribe单模型支持六种指令可调的转写输出形态,来源:NVIDIA
在整体架构上,该模型通过并行编码器分别处理语音内容与说话人信息,再将两路信息融合,生成转写结果。语音识别编码器负责提取语言信息,说话人分离模块则判断不同时间段由谁发言,并将相关信息传递给后续模型。
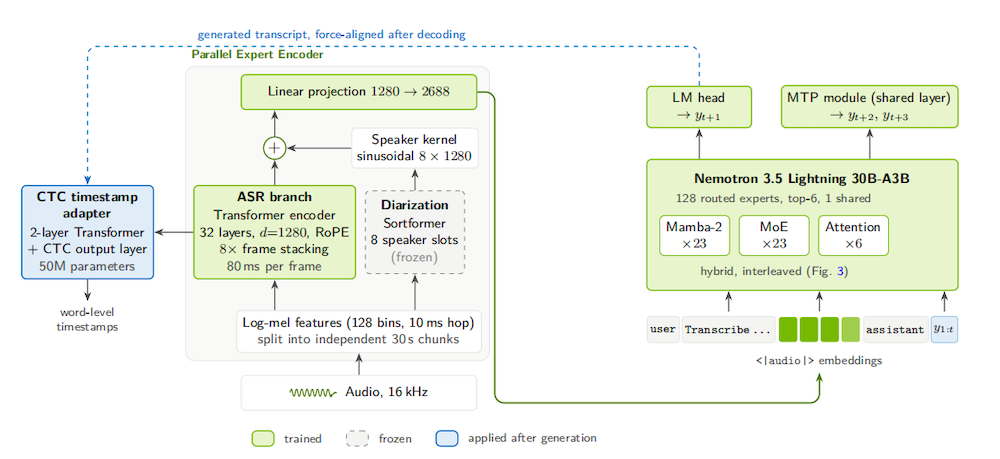 ▲Nemotron 3.5 Transcribe整体架构,来源:NVIDIA
该模型仍以录音转写为主要用途,并非面向实时语音交互的流式识别系统。这种设计将语音识别与说话人分离整合到同一套模型流程中,可用于处理会议记录、访谈和多人讨论等场景。
二、并行编码融合语音信息,上下文识别能力强
Nemotron 3.5 Transcribe采用Nemotron 3.5 Lightning 30B-A3B作为语言模型骨干网络。根据英伟达公布的技术报告,该骨干网络共包含52层,其中23层采用Mamba-2架构,23层采用混合专家(MoE)架构,另有6层采用Attention注意力机制。
Mamba-2侧重处理长序列信息,MoE架构则通过选择部分专家参与计算,在保留模型总参数规模的同时控制单次推理所需的计算量。Attention层负责相应的注意力计算,三类模块共同构成模型的语言处理部分。
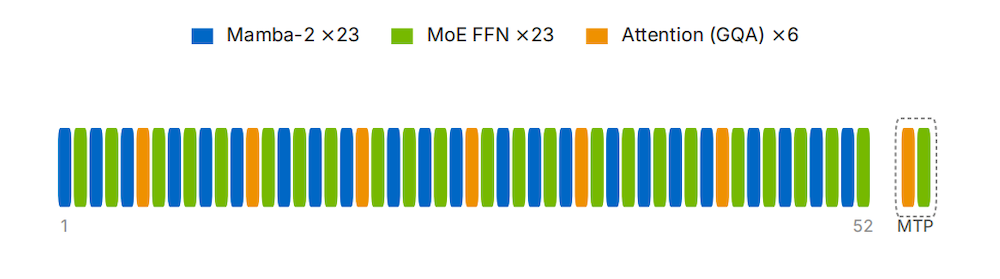 ▲Nemotron 3.5 Lightning 30B-A3B骨干网络层分布Mamba与MoE为主,仅6层Attention,来源:NVIDIA
针对录音中的时间信息,该模型还加入了专门的时间戳适配器,在生成文本后对齐词语与音频中的时间位置,从而输出词级时间戳。结合说话人信息后,该模型可以生成带有时间位置和发言者归属的转写结果。
在训练方面,英伟达采用分阶段流程,先进行模型初始化,再开展监督微调(SFT),并通过强化学习进一步优化模型表现。监督微调帮助模型学习不同任务的输入与输出方式,后续优化则着重改善语音识别表现。
从训练结果来看,强化学习阶段进一步改善了模型表现。该技术报告显示,英文开放语音识别测试中的WER从4.34%降至4.00%,多语言语音识别WER从5.05%降至4.78%;代码实体准确率从86.37%升至88.60%,幻觉插入片段占比则从46.04%降至41.21%。这些变化表明,训练优化不仅关注整体转写准确率,也试图减少专有名词识别错误和转写中不应出现的额外内容。
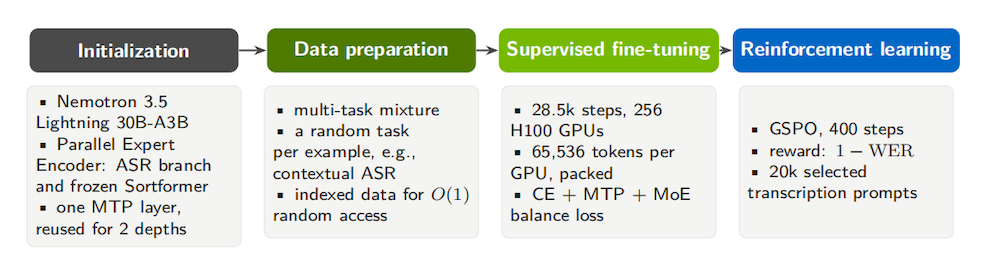 ▲Nemotron 3.5 Transcribe四阶段训练流程,初始化到SFT再到强化学习,来源:NVIDIA
训练数据方面,Granary-v2与英伟达内部语音数据是监督微调阶段的主要数据来源。该技术报告显示,Granary-v2的伪标注数据、人工改进数据和语音翻译数据,分别占数据源采样概率的31.2%、25.7%和13.7%,英伟达内部语音数据占25.1%。四类数据的采样概率合计为95.7%。
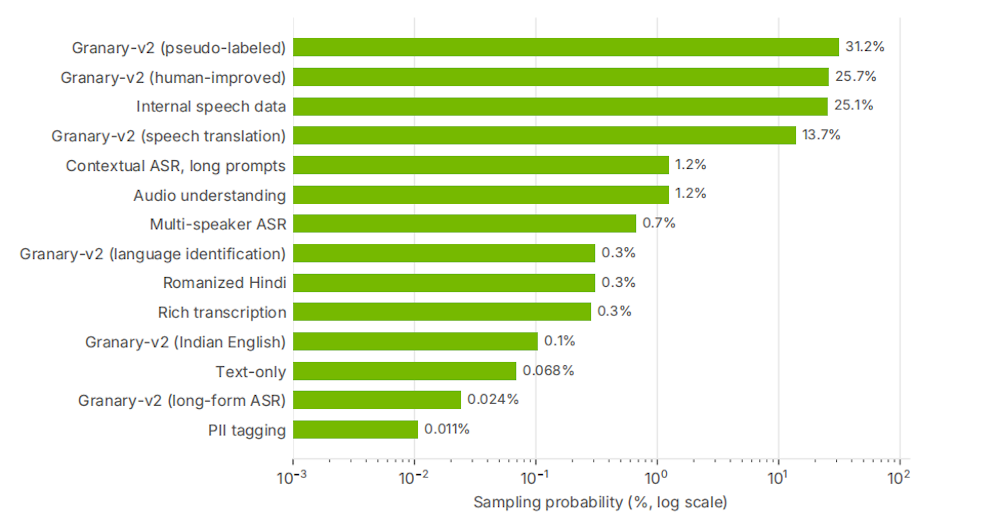 ▲SFT结束时各数据源采样概率Granary-v2与内部数据占95%以上,来源:NVIDIA
除了数据来源,该模型还会按照不同任务设置样本抽取概率。在Granary-v2与内部语音样本中,上下文辅助语音识别相关变体的任务抽取概率合计约占四成。这类任务要求模型结合给定的上下文信息识别语音中的专有名词等内容。
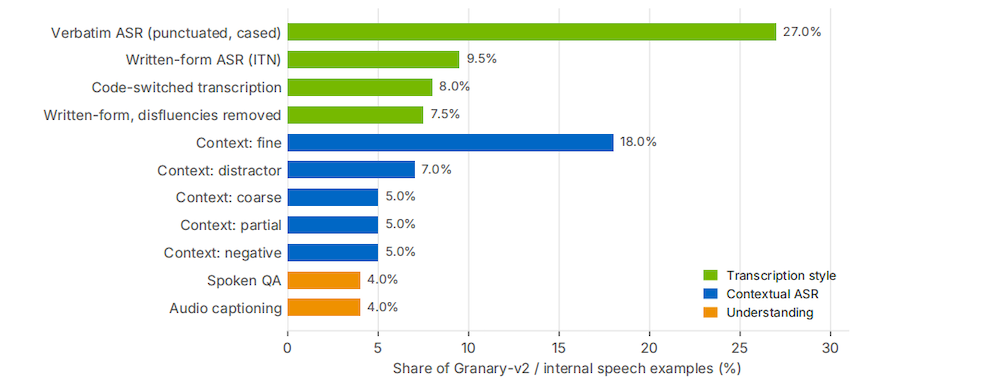 ▲Granary-v2与内部语音样本的任务抽取概率,上下文ASR变体合计占四成,来源:NVIDIA
三、英文识别表现最佳,30秒音频约0.13秒完成转写
在语音识别评测中,Nemotron 3.5 Transcribe在英文Open ASR Leaderboard的9个公开测试集上取得4.71%的平均WER,表现最佳,平均WER低于模型Qwen3-ASR-1.7B、Granite-Speech-5.0-2B等测评模型。WER用于衡量转写文本与标准答案之间的差异,数值越低,代表识别结果越准确。
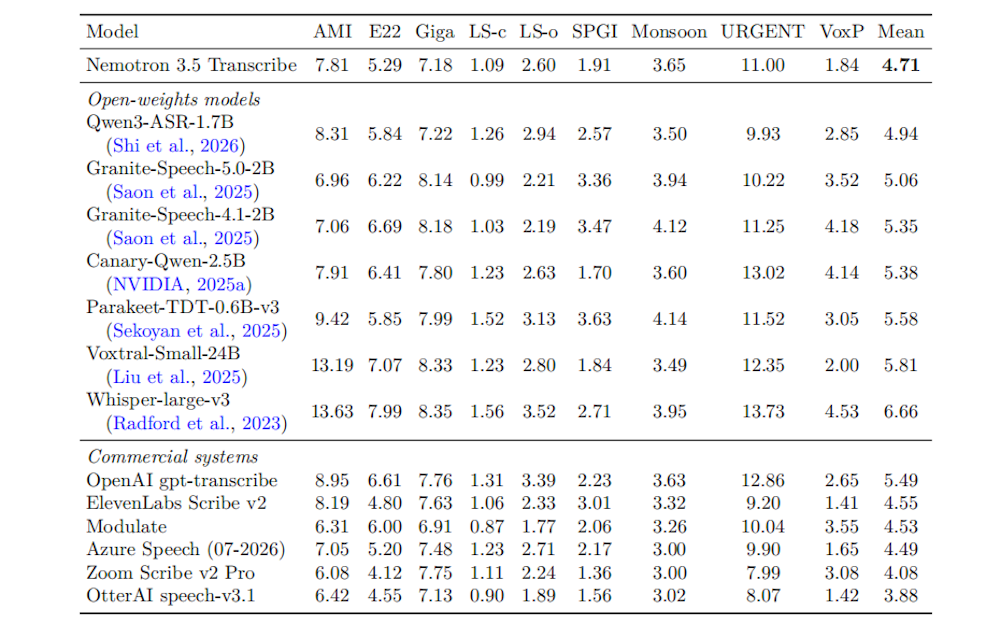 ▲英伟达发布该模型在英文语音识别排行榜的9个公开测试集成绩,来源:NVIDIA
该测评集的评测范围也不局限于单人语音识别。英伟达使用了10类任务评估模型能力,分别是语音识别、多语言语音识别、语码转换识别、上下文偏置识别、多人语音转写、语音翻译、语言识别、音频理解、语音指令跟随和文本推理。
其中,语码转换识别用于处理同一段语音中混用多种语言的情况;上下文偏置识别侧重结合给定的实体列表,改善人名、产品名等专有名词的识别;多人语音转写需要同时识别发言内容并区分说话人。其余任务还包括判断音频使用的语言、将语音转换为目标语言,以及理解音频内容、执行语音指令和完成相关文本推理。
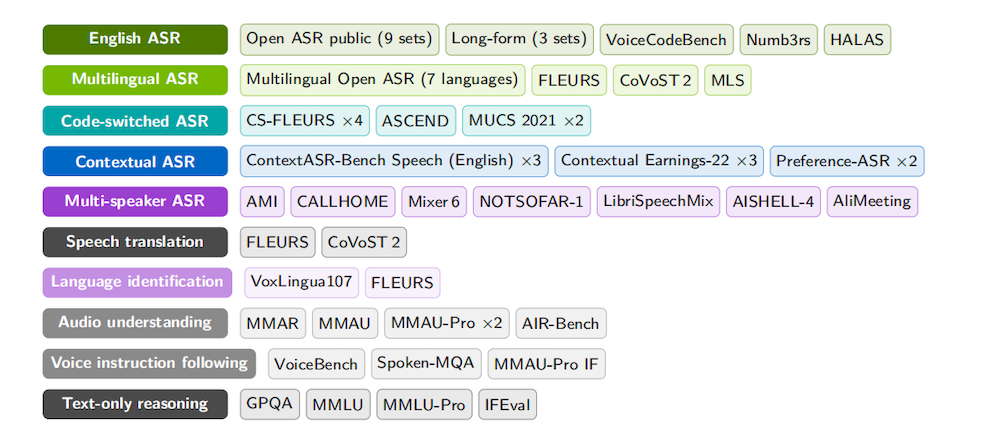 ▲评测基准按任务类别全景分布,覆盖ASR到音频理解共十大类,来源:NVIDIA
在多人发言识别方面,英伟达报告对6种语言测试条件下的表现进行了比较,在意大利语、西班牙语、葡萄牙语、荷兰语和印地语等测试中,Nemotron 3.5 Transcribe位于第三,低于Qwen3-ASR-1.7B的6.49%、Voxtral-Small-24B的6.52%和Whisper-large-v3的7.94%,高于ElevenLabs Scribe v2的3.56%与Azure Speech的3.72%。
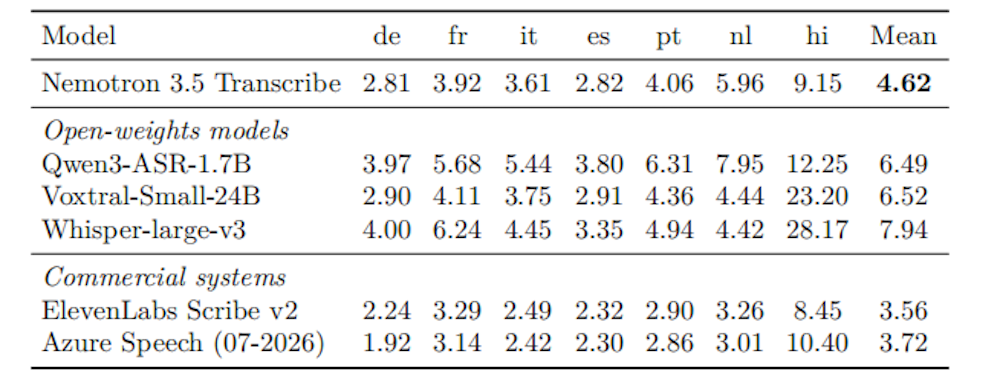 ▲英伟达发布该模型多语言语音识别排行榜公开测试集成绩,来源:NVIDIA
在多人发言转写测试中,Nemotron 3.5 Transcribe平均词错误率为15.80%,优于专用级联系统DiCoW v3.3与DiariZen组合的16.83%。

▲英伟达发布在多人发言转写测试成绩,来源:NVIDIA
推理效率方面,英伟达在单张RTX PRO 6000 Blackwell服务器版GPU上测试了不同数值精度和解码方案。该报告显示,采用NVFP4量化版本结合DFlash2解码时,模型处理音频的速度最高可达每秒2238秒音频;在单请求测试中,处理一段30秒音频约需0.13秒。
在模型适配方面,英伟达还提供了微调工具NeMo Speech。测试结果显示,在17项适配任务中,使用单张GB300 GPU完成每项任务的训练通常需要约0.5至2.3小时。
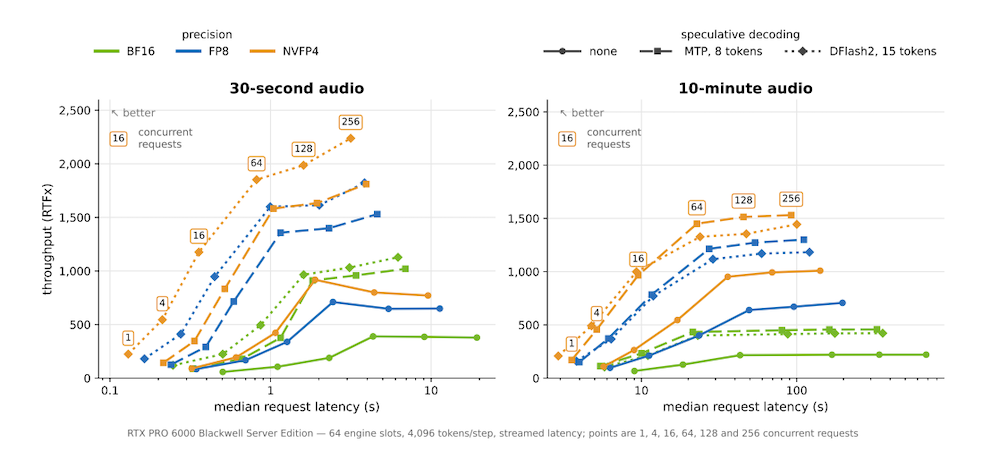
▲RTX PRO 6000 Blackwell上单GPU吞吐与延迟散点图,来源:NVIDIA
该模型还提供BF16、FP8和NVFP4等不同精度版本,以适配不同显存和推理需求。
结语:语音模型的竞争正在转向多任务整合
Nemotron 3.5 Transcribe将语音转写、多人发言区分和多语言处理等能力整合到同一开源模型中,降低了企业组合多种语音工具的复杂度。
与此同时,用户对语音模型的需求正从单纯的语音转写,延伸至更复杂的任务。语音模型能否准确识别语音、区分多人发言,并兼顾推理效率与部署灵活性,正成为用户是否采用该模型的重要因素。
值得关注的是,整合后的模型在真实业务和多语言场景中表现如何,以及开源能否真正降低工具链和部署成本。目前,这些仍有待开发者的使用反馈。
来源:英伟达
