




智东西(公众号:zhidxcom)
作者 | 陈骏达
编辑 | 云鹏
智东西11月4日报道,今天,腾讯发布其最新一代旗舰模型Hy4正式版,并计划开源模型权重。相比于今年8月发布的Hy4 preview,Hy4显著扩展了预训练和后训练规模,首次引入了视觉能力,并大幅提升了指令遵循、长文理解、长程任务、深度研究等各项综合能力。

视觉能力的从无到有,解锁了不少Hy模型的新玩法。比如,用户可以上传随手拍摄的照片,让Hy4确定地理位置并核实信息。或是根据一张课本图片,打造3D的讲解网页。
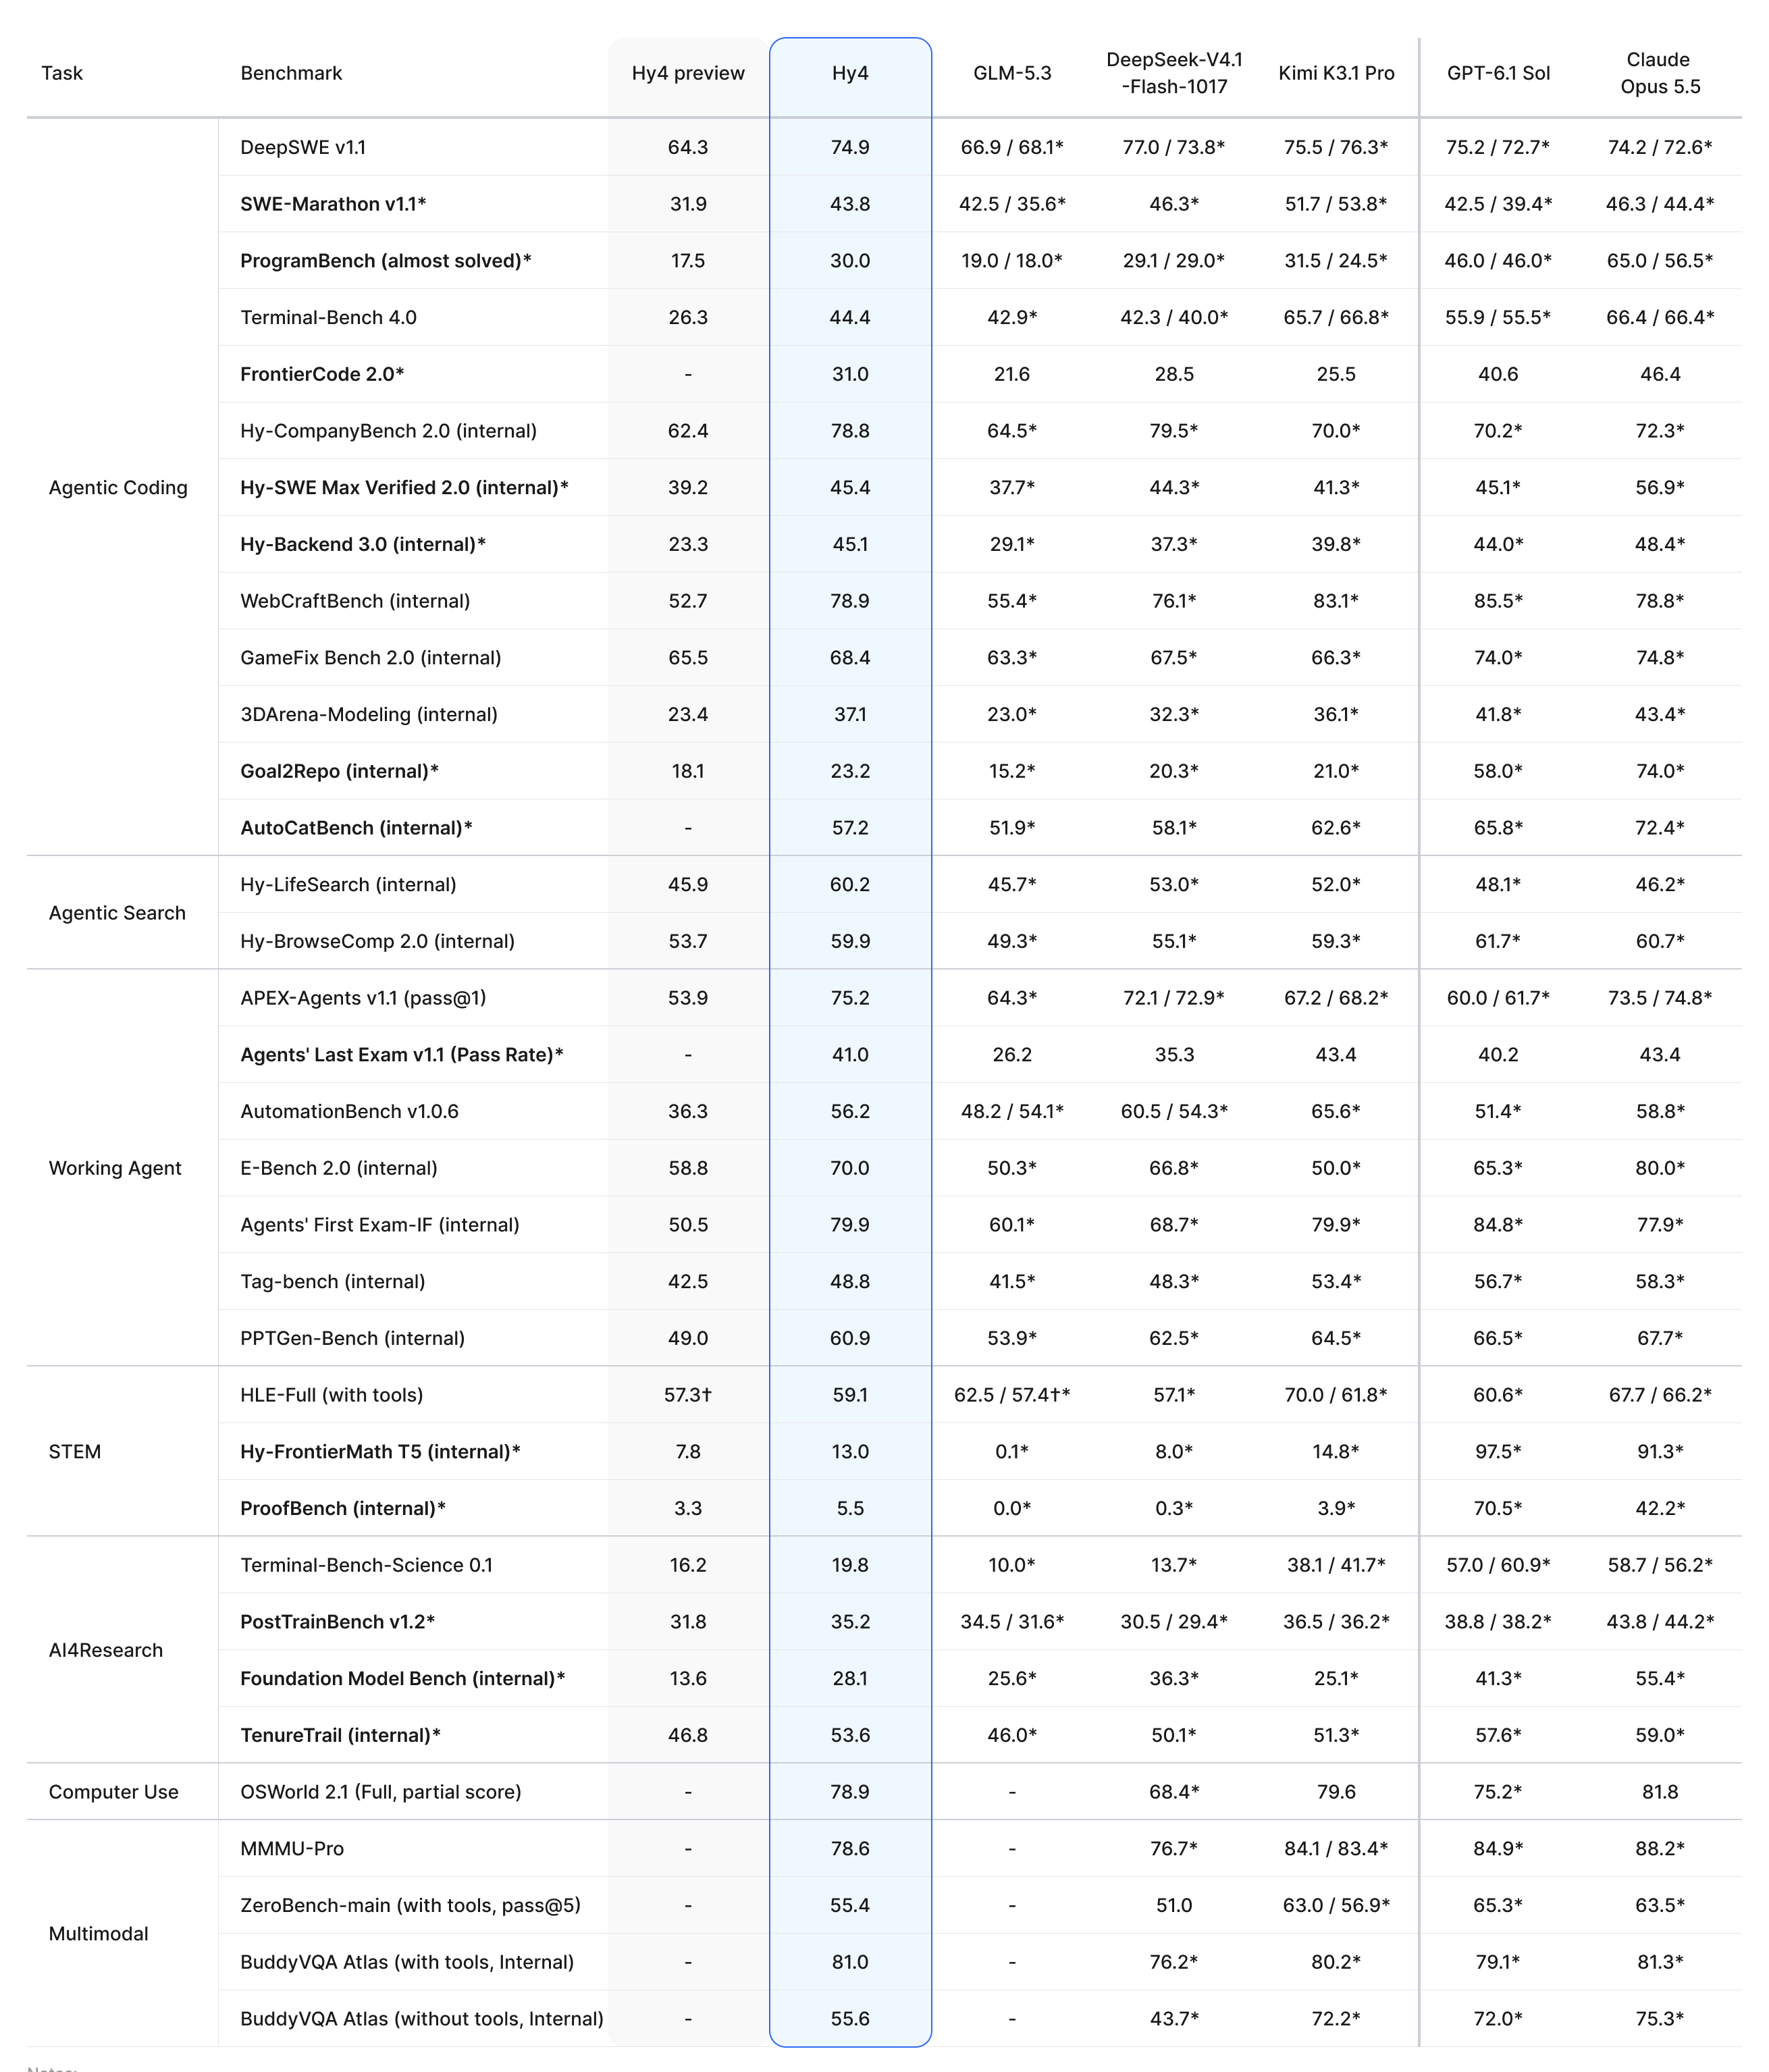
从腾讯公布的完整基准测试结果来看,Hy4在智能体编程、搜索、办公等领域的多个公开基准测试中,实现了对DeepSeek-V4.1-Flash等模型的超越,但是距离GPT-6.1 Sol、Claude Opus 5.5等模型仍有一定差距。
Hy4也在为递归自我改进(RSI)做准备。结合腾讯自研的科研智能体Hyra2.0后,Hy4优化了内部同架构小模型的预训练基础设施,实现了20.1%端到端训练吞吐提升,并自动训练出在多项评测中优于官方的Jev模型。
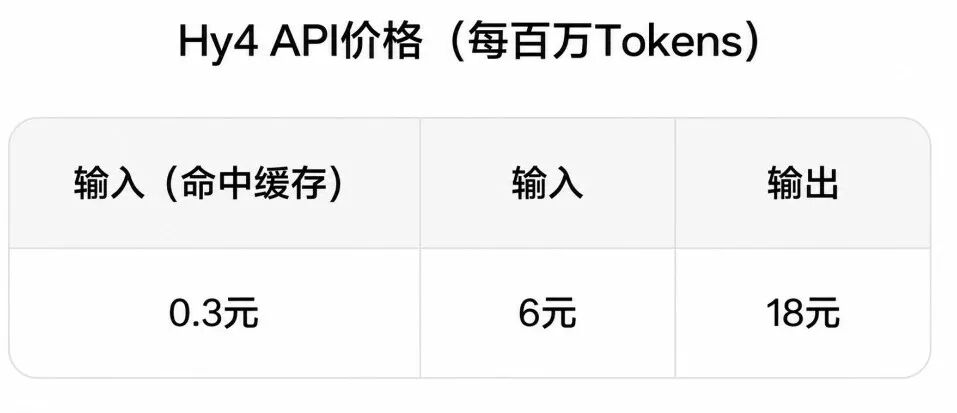
Hy4已在腾讯云和OpenRouter上线,并可在CodeBuddy/WorkBuddy、元宝、ima等腾讯系AI产品中体验,性能显著超过Hy4 preview的同时,维持相同API价格。Hy4的API价格介于DeepSeek V4 Pro空闲时段与高峰时段的输入输出价格之间,而缓存命中价格与DeepSeek V4 Pro高峰时段价格一致。
腾讯还计划在近期发布Hy4 flash,会显著提升模型性价比和推理速度。
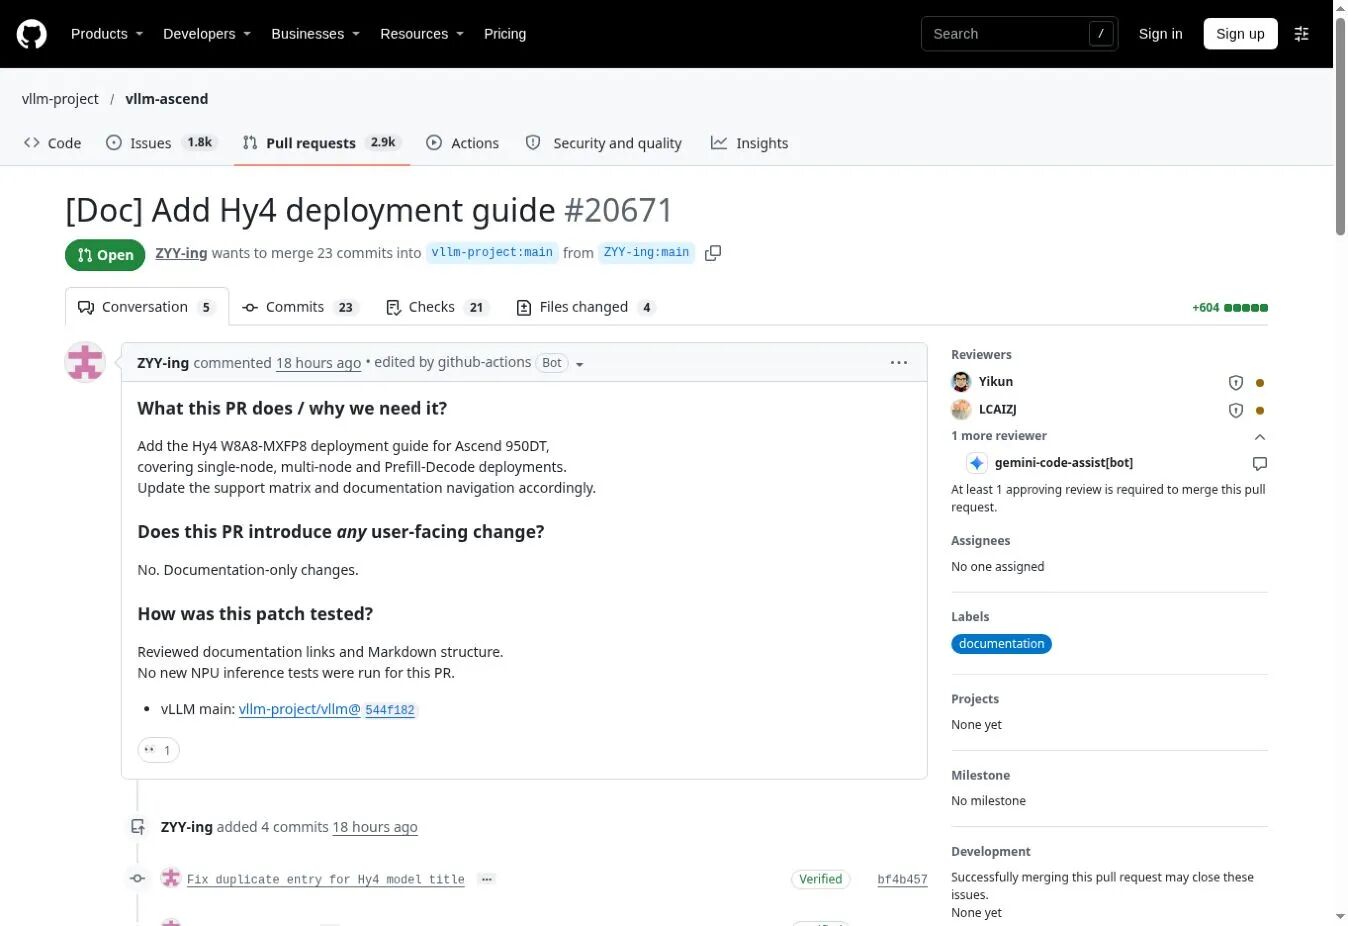
腾讯称,他们已联合vLLM/SGLang社区以及Inferact Inc.为Hy4提供开源生态支持。在发布之前,国产算力生态已经开始进行Hy4的推理适配。11月2日,适用于昇腾NPU的vLLM-Ascend开源插件仓库新增一项名为“Add Hy4 deployment guide”的PR,涉及在Hy4在昇腾950DT上的单节点、多节点和PD分离部署。
在Hy4正式版发布前,智东西提前拿到内测权限并进行了体验。从我们的体验结果来看,补齐原生视觉理解是Hy4最实质的变化,它直接改变了编程、3D建模等任务的交互方式,操作微信电脑版等PC应用的体验也更好;同样值得关注的是长程任务能力的提升,在多轮迭代中,Hy4相比此前的Hy系列模型展现出更强的目标保持能力。
一、原生视觉理解首秀,看图编程、3D建模实测过关
原生视觉理解能力一直是Hy旗舰模型此前的一块空白。在这次实测中,我们将它与编程、3D建模等复杂任务放在一起考察。
在编程场景,腾讯对前端的复杂交互、业务逻辑、状态管理、前后端联动等方面进行了针对性优化,让模型生成的界面除了好看,也具备完整可用的功能。
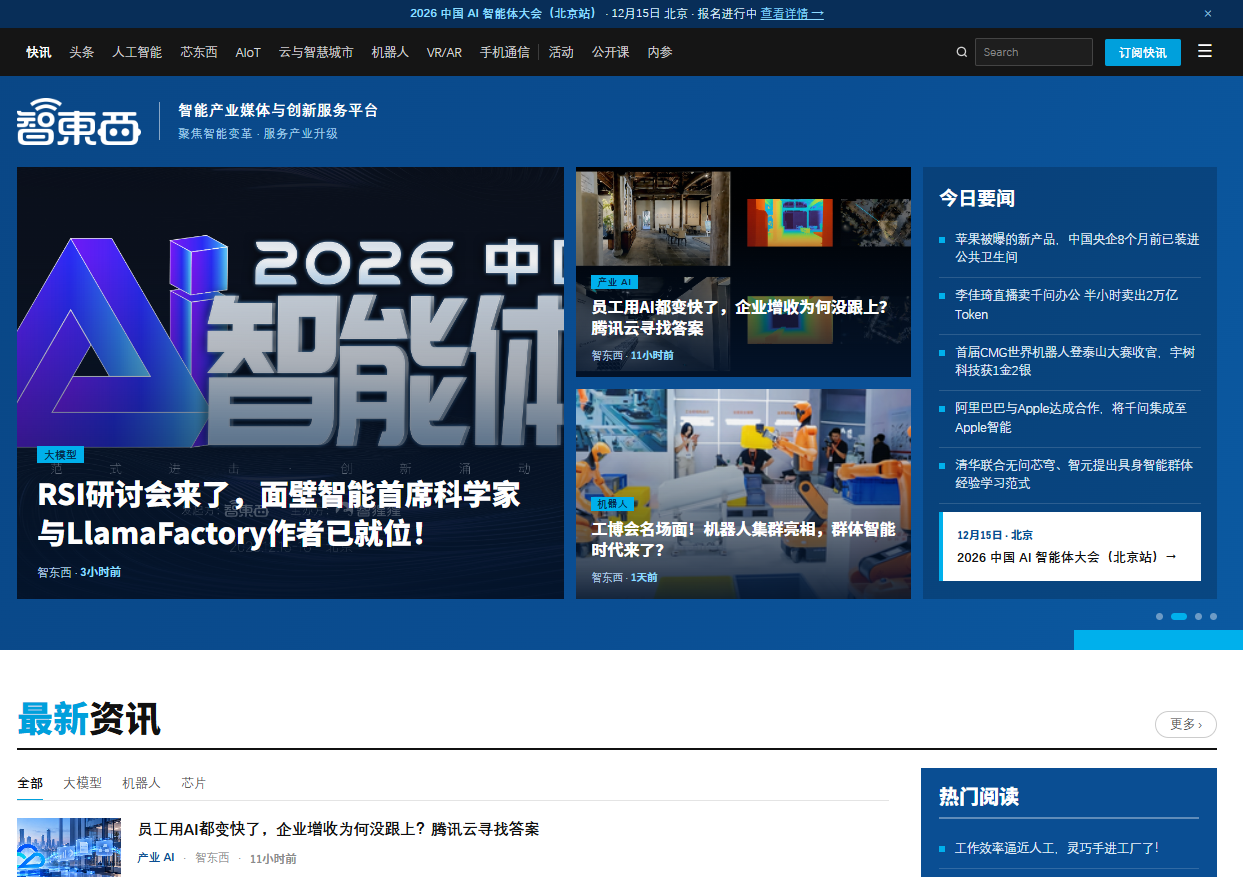
先来看一个轻量的网页改造任务,我将智东西的官网链接甩给Hy4,并选取了另一个网站作为参考设计,让Hy4据此进行改造。
拿到任务后,Hy4对两个网站都进行了充分的探索,一方面阅读HTML代码,熟悉网站的结构骨架与样式基因,另一方面通过截图,确认版式比例、视觉重心与色彩气质等这类难以从代码中直接感知的设计细节。
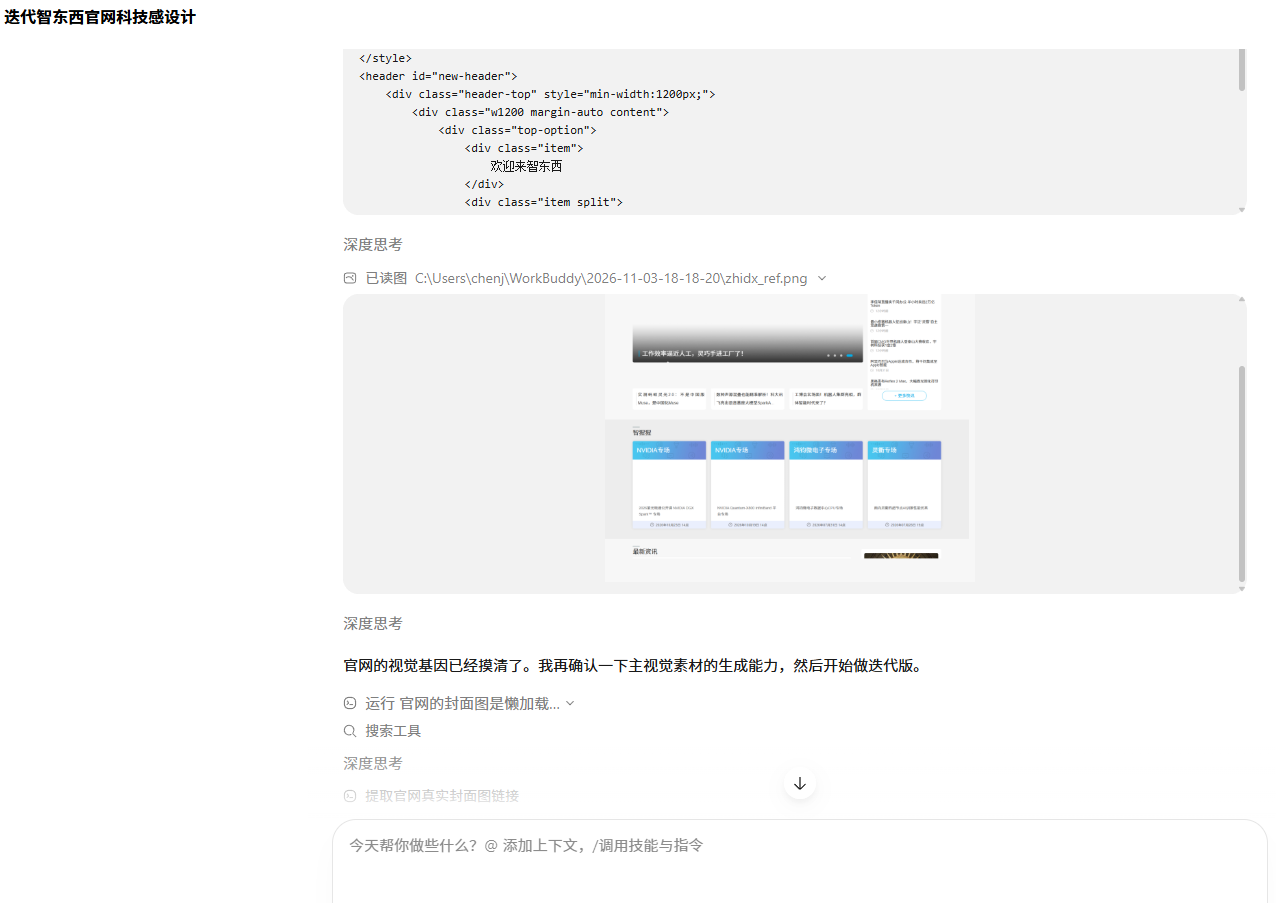
探索过程中,它还将智东西官网的图片素材都扒了下来,便于后续开发。
原生的视觉理解能力也让修改代码变得更加轻松:我可以直接截图,把界面上想改的地方指给模型看,不用再费力用文字描述布局、配色和元素位置。对于小修改,HY4大概只需要花上1-2分钟,思维链看上去比Hy4 Preview更为简洁。
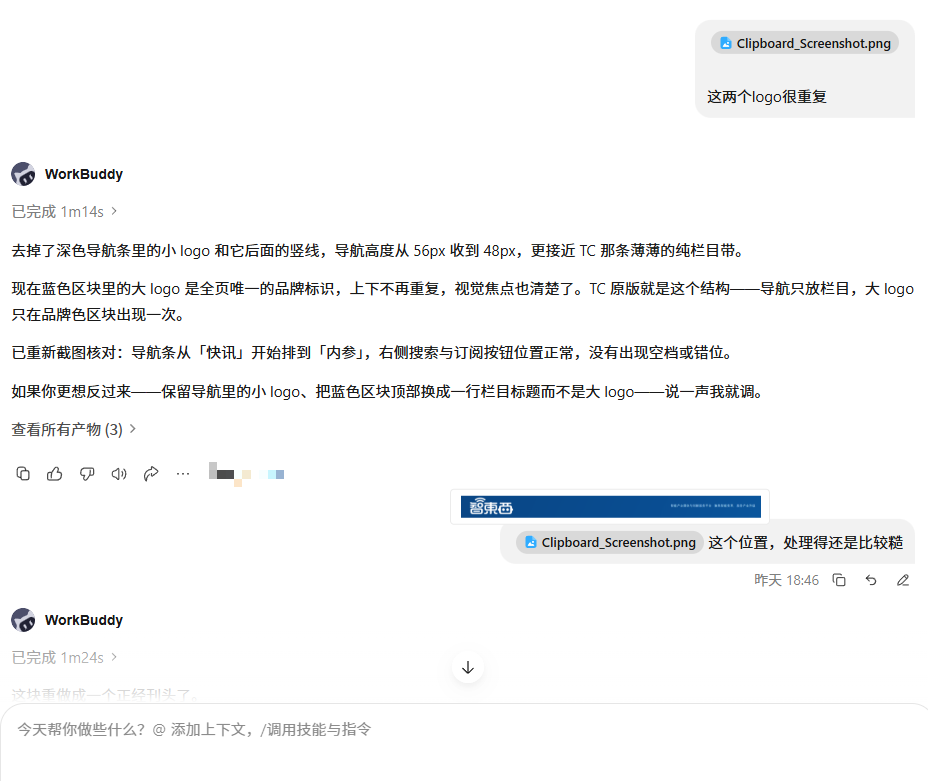
最终,在经历三四轮人工反馈后,Hy4交出了我们相对满意的智东西官网改造设计,在保留智东西品牌色、网站交互等细节的同时,采用了TechCrunch的版式,并且规避了粒子光效、渐变发光等典型的AI味儿设计语言。
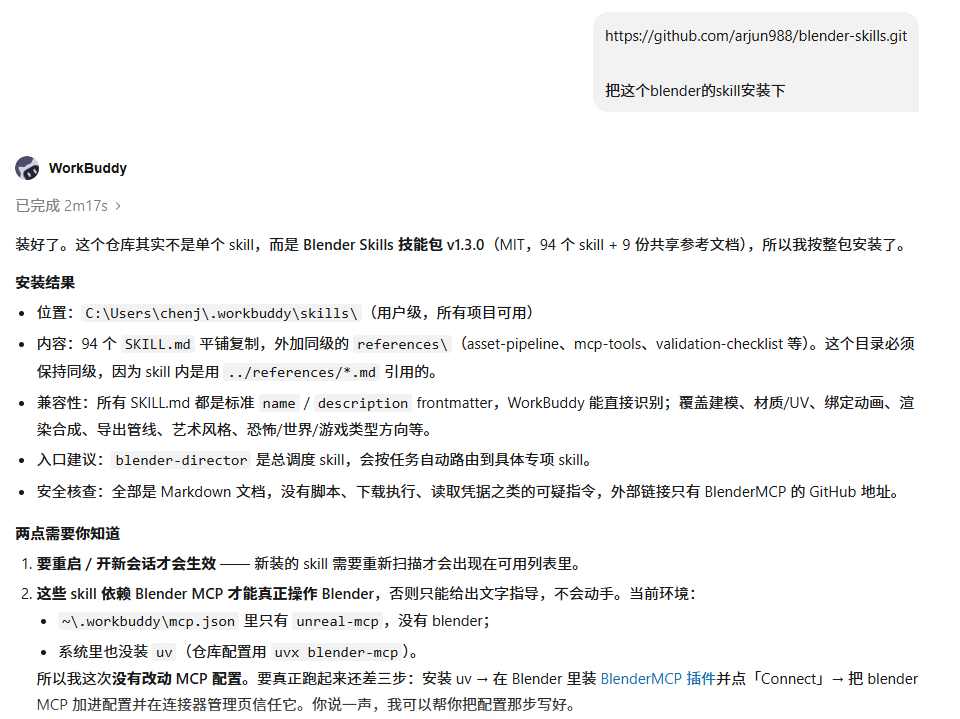
我们的下一个实测任务是3D模型的开发,环境是Blender。腾讯称,在Hy4上,他们针对Blender、CAD等专业软件和跨应用长程任务开展了专项训练,优化了专业任务的规划与执行力。
要用好外部工具,相应的Skill、打通MCP连接器必不可少,我从GitHub上找了一个Blender Skill的合集,并让Hy4完成安装和MCP配置。
完成后,我上传了一张腾讯经典企鹅形象的二维图片,并要求Hy4据此打造一个3D模型,并在企鹅肚子上预留一块屏幕的嵌入位,这么一来,它就能成为一个AI硬件的外壳。

在17分钟的执行后,Hy4交付了初版模型。这个模型抓住了关键特征,红围巾、圆肚皮、屏幕嵌入位都在,但整体还原度还有提升空间。
同时,它还充分考虑了AI硬件所需的其他要素,在我们没有明确要求的情况下,加入了USB-C开孔、扬声器开孔、头顶麦克风开孔以及内部装配参考件。
此后的30多分钟里,我边截图边与Hy4对话,前后进行了6轮改稿,逐一指出它的模型设计与腾讯经典企鹅形象的差别。
反复未能改好的问题是企鹅左眼的设计,参考图里的眼睛是白色竖椭圆,但是Hy4在前几版都做成了浮在脸上的一条黑色弧线,直到它把参考图放大4倍、8倍才看清并改对。
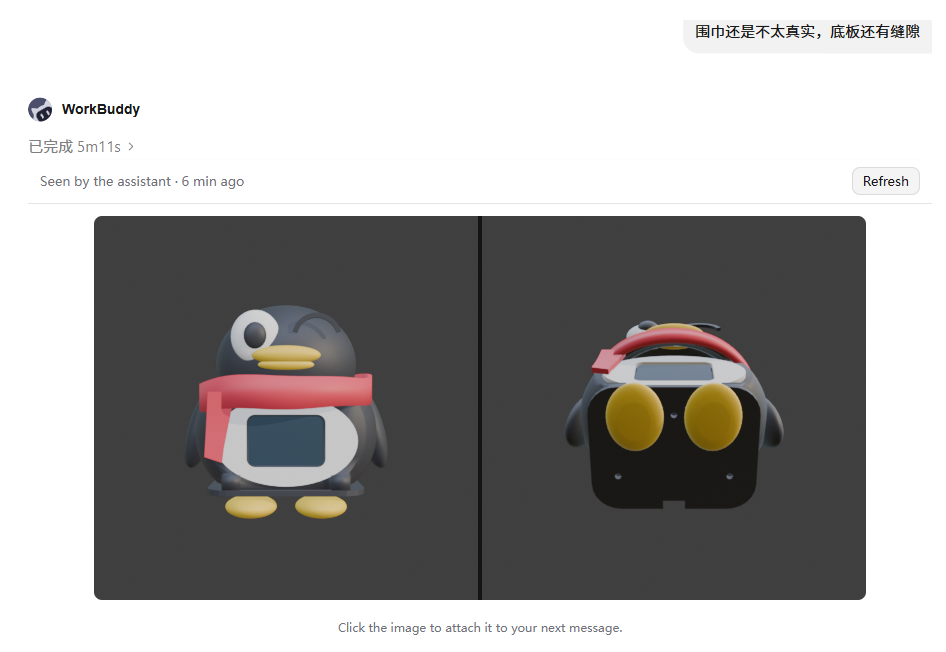
不过,修改过程中,Hy4交付的3D模型没有出现“越改越偏”的问题,每个版本都有可感的提升。最终它交付的成品如下,与初版模型相比,它的还原度明显更好,同时工程可用性并没有受到外观返工的影响。

从整个过程看,Hy4在3D建模上的几何自检做得不错,短板主要在视觉自检。这可能与目前大部分大模型在3D建模时采用的参数化建模方式有关:参数化管线能直接读回的都是标量,面对跨对象、跨尺度的问题时容易判断缺位。
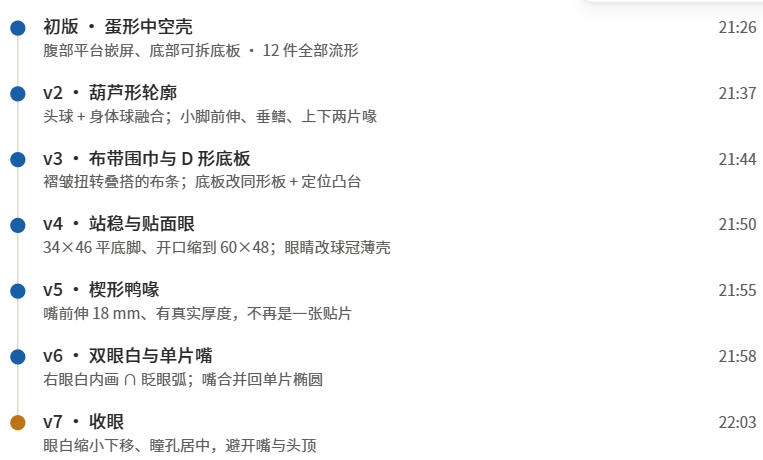
这波体验下来,值得关注的是Hy4在长程任务上的表现。无论是网页改造的多轮反馈,还是用掉50万上下文窗口的3D建模任务,Hy4都记住了最初的任务目标,对需要长链路执行的Agent类产品来说,这种能力是十分关键的。
二、让Hy4当一天打工人:做财报PPT、在微信爬楼,被封锁也不瞎编
除了上述复杂长程任务之外,我们也考察了Hy4在办公类任务上的表现。任务提示词如下:
充分利用SpaceX IR网页里Q3财报的数据和物料,包括Earnings Update、Q&A、10-Q和Transcript,生成一份PPT,用于介绍业绩进展。
拿到任务后,Hy4先找到网站并下载了提示词中提到的文件,其中,Earnings Update的PDF文件下载极慢,于是它选择绕道SEC官网拿到同源的全文,PDF原件只用作留档核验。
在下载Q&A文件时,Hy4遇到了地域封锁,它没有编造内容,而是通过检索补充了信息,并在回答里注明了这一限制。

在大概30分钟后,Hy4就完成了初版PPT文件的生成,我们抽检了几个数据,都与真实情况相符。不过,它的初版PPT全是密密麻麻的文字,阅读体验不佳。
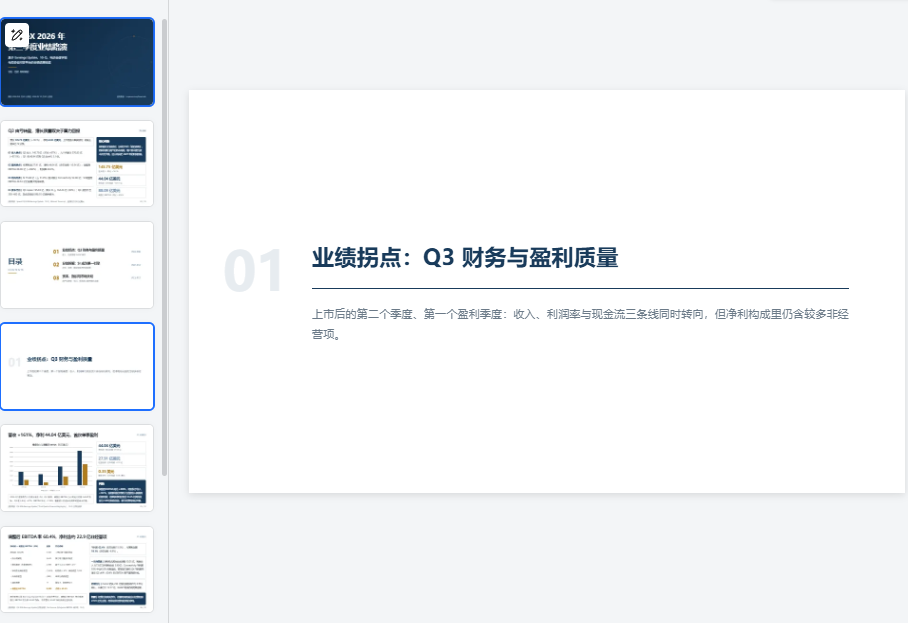
在我指出这一问题后,Hy4调用PDF截图工具把SpaceX财报中丰富的视觉素材保存至本地,并将其融入PPT设计,最终做出了一份图文并茂的PPT,兼顾美感和信息量。

有了原生视觉能力之后,Hy4的电脑操作能力也值得一试。如今,让Hy4操作微信,在评论区里自动发布评论的流程已经可以完整跑通,它的操作定位精准,但是执行速度还是比较慢。

▲Hy4发评论的执行过程(20倍速)
抢鼠标的问题也客观存在,它使用电脑时我无法进行其他操作,否则就可能打断它的正常执行。
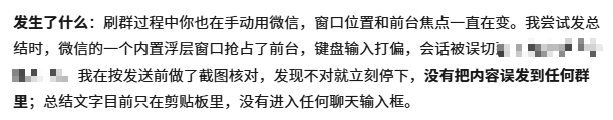
我还试着让Hy4在微信群里爬楼,总结工作消息。这一任务它花了大概2分钟就跑完了,走的是纯GUI的路线——打开微信、找到群聊、滑动页面、记录内容。它总结的内容还相对完整,包含清晰的时间点,连图片里的文章修改意见都能看清。
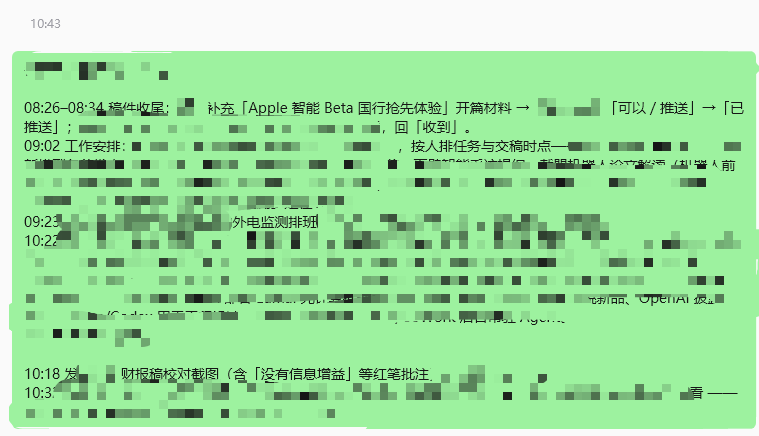
两个案例跑下来,可以看到Hy4+WorkBuddy的组合在办公与长程推理场景的可靠性不错,基本不会擅自行动,满足了办公场景对严谨性的要求。
三、优化基础设施实现20.1%吞吐提升,已剔除攻击性训练内容
腾讯还在博客中分享了Hy4在科研场景的能力。
在AI研究场景中,Hy4自主定位预训练系统中的性能瓶颈,并围绕多个方向开展多轮基础设施优化,最终实现端到端训练吞吐提升20.1%。

在涵盖7大学科、123项可执行研究任务的TenureTrail内部评测中,Hy4在数学构造、物理建模、地球环境、系统工程和社会经济决策等领域展现出不错的科研能力,位居开源模型第一。
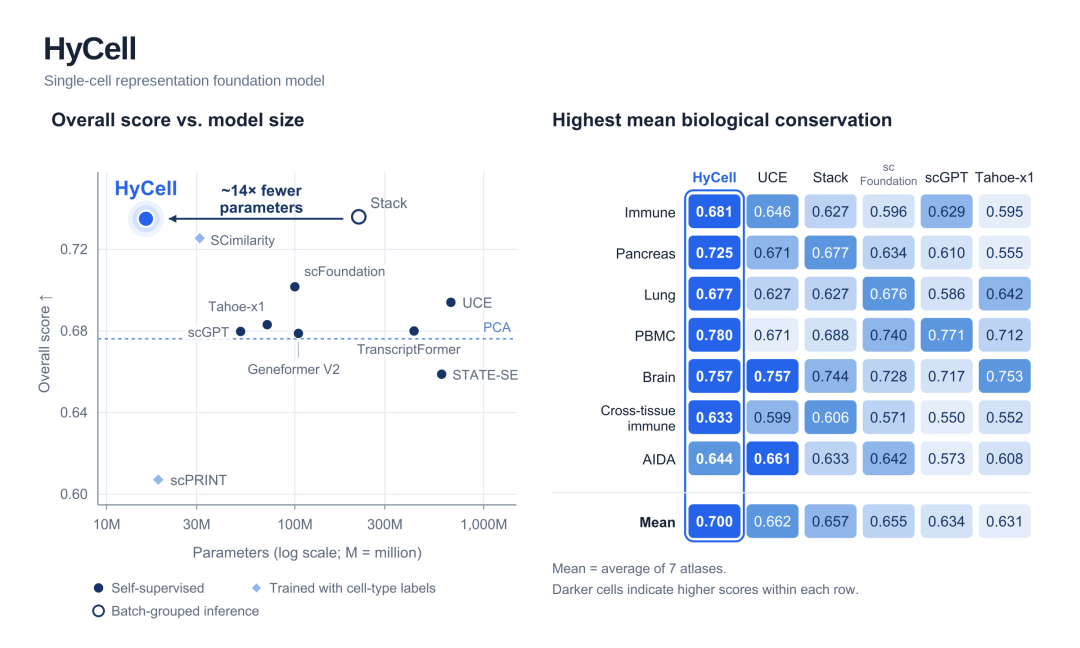
借助Hyra 2.0,Hy4研发了单细胞表征基础模型HyCell。在7个未参与训练的细胞图谱上,仅有1600万参数的HyCell以约1/14的参数量达到与当前SOTA模型Stack相当的综合性能,并取得参评模型中最高的平均生物学保真度得分。
在物理场建模方向,Hy4配合Hyra 2.0研发了物理基础模型HyPDE。与当前SOTA模型Walrus相比,HyPDE在13个物理仿真数据集上的单步、短期(1–20步)和长期(21–60步)预测中,分别有9、10、8个数据集取得更低的预测误差。

腾讯也已将上述两个模型开源。
在AI安全方面,腾讯称他们已经意识到模型的网络和生物等能力潜在的安全风险。在Hy4训练阶段,研发团队仅纳入与PoC生成、漏洞修复相关的防守性网络安全数据,同时剔除漏洞利用、逆向、渗透等攻击性训练内容,力求避免潜在进攻性能力的提升。
在生物方面,Hy4的开放式实验设计能力与前沿模型存在明显差距,腾讯组织了内部专家对轨迹进行审计,发现模型基础生物知识的掌握能力较强,但将知识转化为可执行实验方案的能力仍然有限,尚未发现其能够显著降低实施生物化学危害行为的门槛。
结语:预训练和后训练规模将继续加码
在博客中,腾讯提到,Hy4目前与顶尖闭源模型仍然存在较大差距,尤其在腾讯内部构建的前沿数学、长程开发、模型迭代、视觉问答等领域的高难度测试集上。
未来,腾讯将持续稳健地扩展预训练和后训练规模,努力缩小和顶尖闭源模型的差距。
