


机器人前瞻(公众号:robot_pro)
作者 | 钟宸
编辑 | 许丽思
机器人前瞻11月6日报道,近日,苹果正式发布了HALO(Humanoid Autonomy, Learned in simulation, running Onboard),这是由一套数据管线驱动的人形机器人全身运动控制系统。
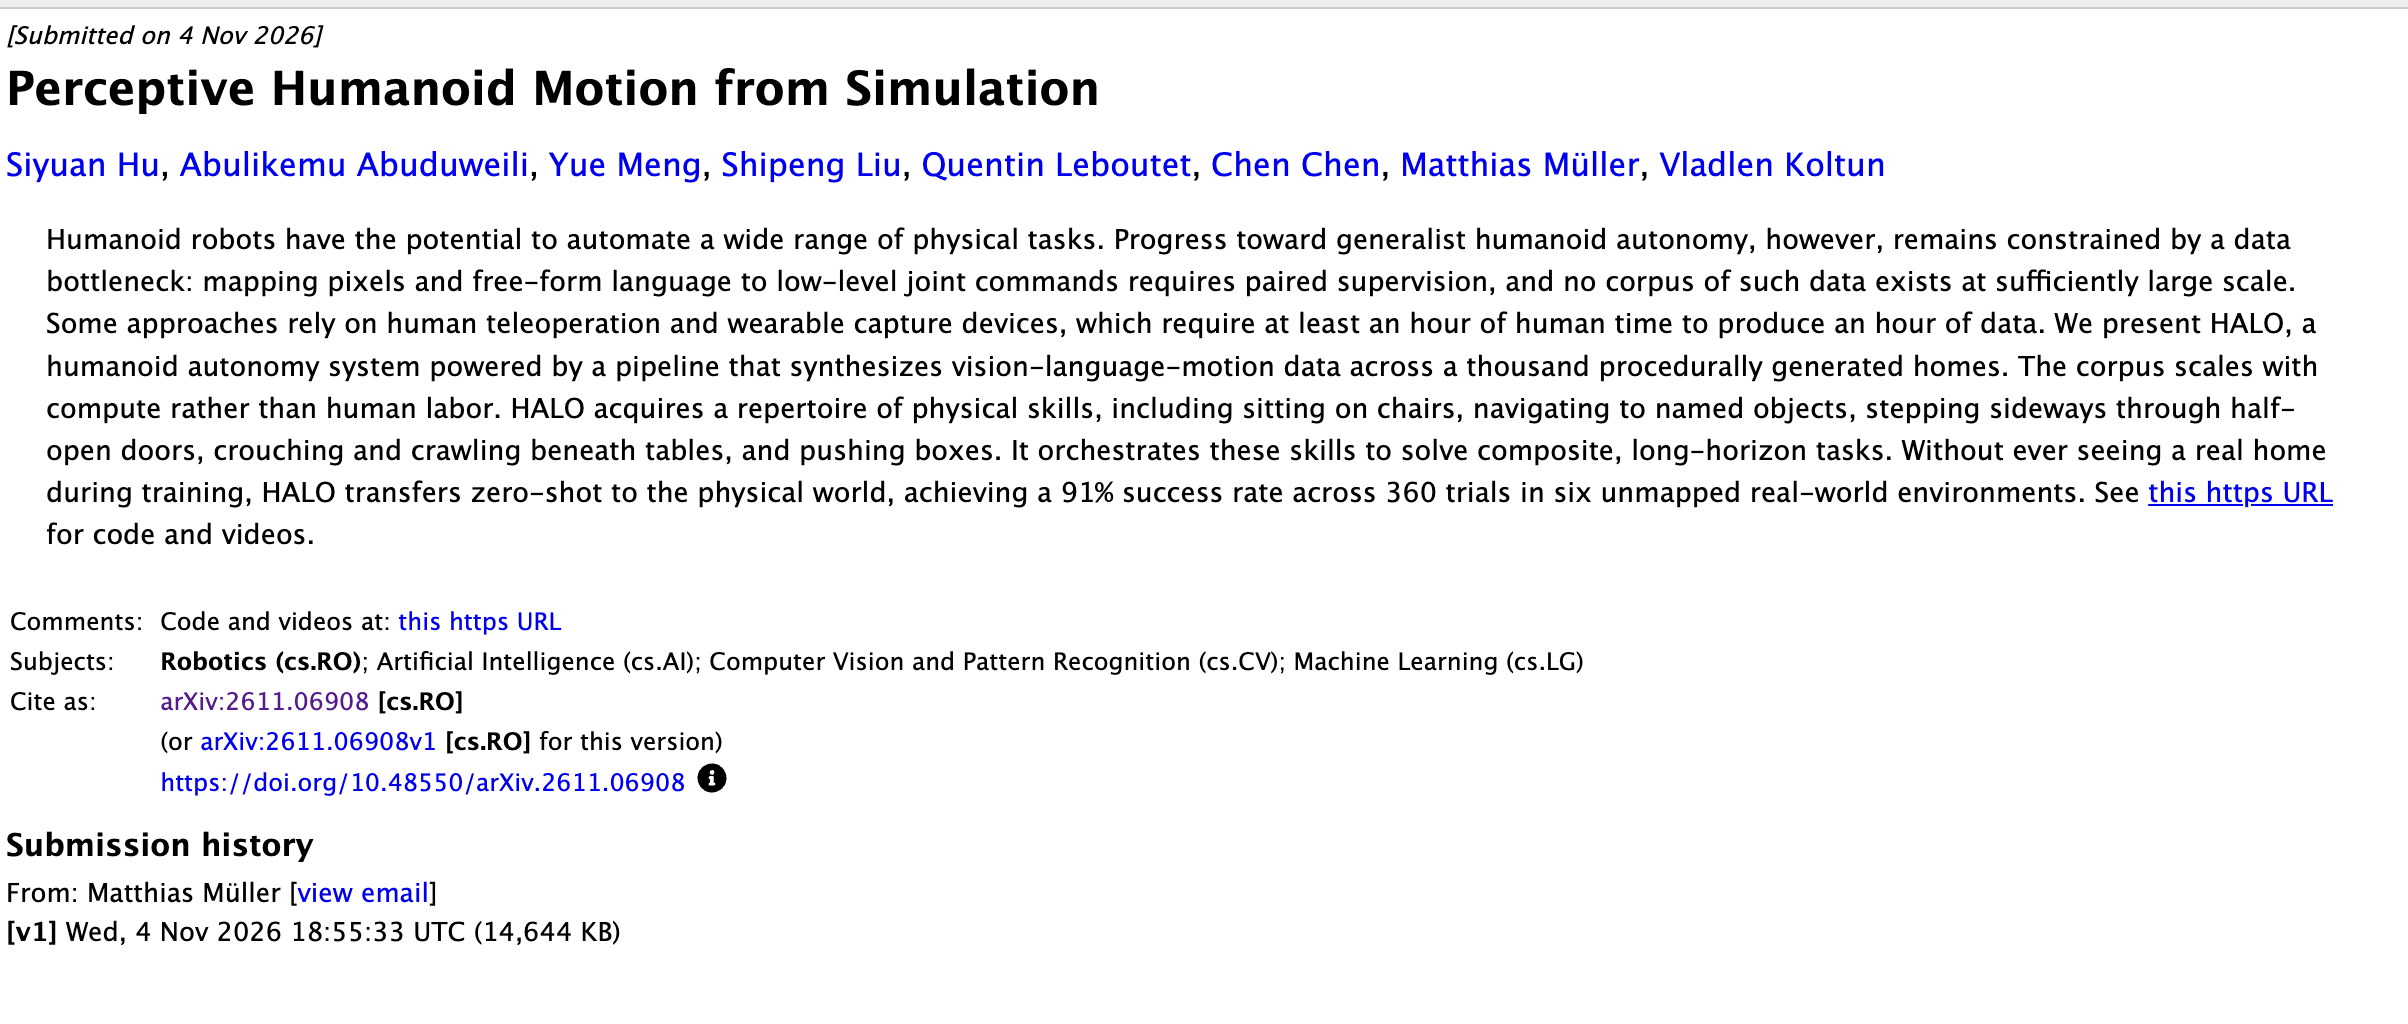 苹果通过程序化生成1000个虚拟住宅场景,在其中合成了近300小时的配对视频、语言及运动数据,共 162,698 个片段。
苹果称,HALO 能够让Unitree G1掌握一系列身体技能,包括坐在椅子上、导航到指定物体附近、从半开着的门侧身通过、在桌下蹲伏通过以及推动箱子。
HALO还可以将这些技能协调运用,以解决复合型、长程任务。
视频中,在完成诸如坐下、蹲伏通过、跟随等单个动作时,机器人没有停顿太多,总体动作流畅。
另外,HALO对于长程指令的理解也较快,在任务执行的过程中,也没有明显的迟滞和停顿。
该公司透露,在训练期间从未见过真实家居场景的情况下,HALO可实现零样本迁移,在六个未建图的真实场景中完成360次试验,成功率达到91%。
一、三层架构,让机器人听懂指令、自主完成全身动作
HALO⾃主系统栈包含三层结构。

第一层是编排器(orchestrator,是⼀个现成的视觉—语⾔模型,每两秒调⽤⼀次),它会将自然的语⾔请求分解为⼀系列的⼦任务,每个⼦任务指定⼀项技能及其作⽤对象。
在此之后,以3Hz运⾏的运动⽣成器(motion generator)会结合VLM编码器与DiT(Diffusion Transformer,扩散Transformer)解码器,将第⼀⼈称RGB观测和⼦任务映射为全⾝运动轨迹(kinematic motion plan),包含五秒的关节⾓度与⾻盆位姿。
最后,⼀个50Hz的运动跟踪器(motion tracker)结合运动规划、本体深度信息(onboard depth)与本体感知(proprioception),通过关节级的执⾏器指令来驱动机器⼈。
据相关成果的论文信息,这一运动跟踪器通过⼤规模的强化学习进行训练,在执行运动规划的同时,确保本体的平衡性、物理接触和执⾏器的限制得到遵守。
论文指出,这一架构的前两层解决语义理解那⼀半的问题(要坐在哪把椅⼦上?),跟踪器则解决物理接触与执行那⼀半的问题(在座椅实际所在的位置坐上它)。
借助这⼀系统栈,HALO能够让机器人⾃主执⾏具有感知能⼒的全⾝动作:坐到椅⼦上、导航到指定物体的附近、侧⾝穿过半开的门、在桌下蹲伏和爬⾏,以及推箱⼦等。

从视频来看,面对不同的场景,HALO表现了较好的泛化能力,能够执行同一指令。
苹果称,HALO还能响应⾃由形式的⾃然语⾔请求,将这些技能编排为更长的多步序列。
不过,从视频来看,HALO的长程任务能力还是几个动作的结合,有待该公司放出更多demo,才能确定HALO的能力边界。
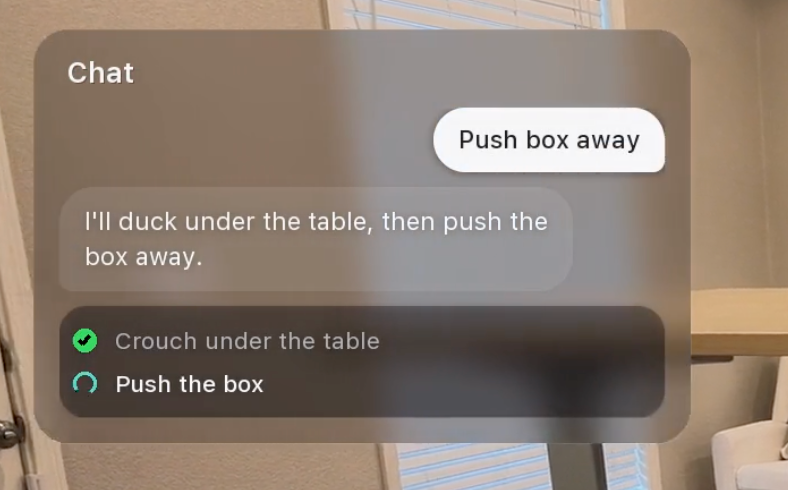
另外,在视频里,苹果虽然展示了HALO响应请求的能力,但每一次请求只有一个简单的任务要求。
也就是说,目前尚不清楚,HALO能否在同一时间内理解多个任务,并实现连续执行。
二、实现分层全身控制,集成第一人称深度信息
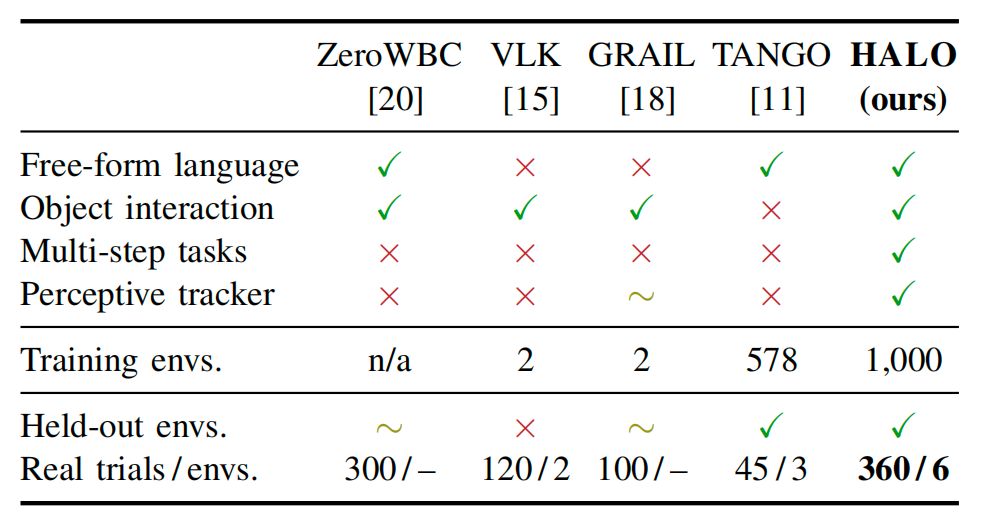
论文里,苹果把HALO和其他⽆遥操作⼈形机器⼈系统进行了⽐较。
该公司指出,HALO的独特之处在于能在线串联技能,并把本体的外部感知系统直接集成到运动跟踪器中。
苹果介绍了实现这一能力的方法。首先,HALO采用分层全身控制的架构(Hierarchical whole-body control)。
策略层面,苹果采⽤了滚动时域(receding-horizon),HALO会规划未来五秒的运动策略,同时以3Hz的频率对策略进行重新规划。而在获得新的感知反馈之前,HALO会只执⾏运动轨迹的前端部分。
此外,HALO⽤⾼层编排器(high-level orchestrator)扩展了这⼀层级结构,把⾃然的语⾔请求转译为⼀系列⼦任务,当子任务执行成功时,会继续往下推进,在失败时,HALO则会主动重试。
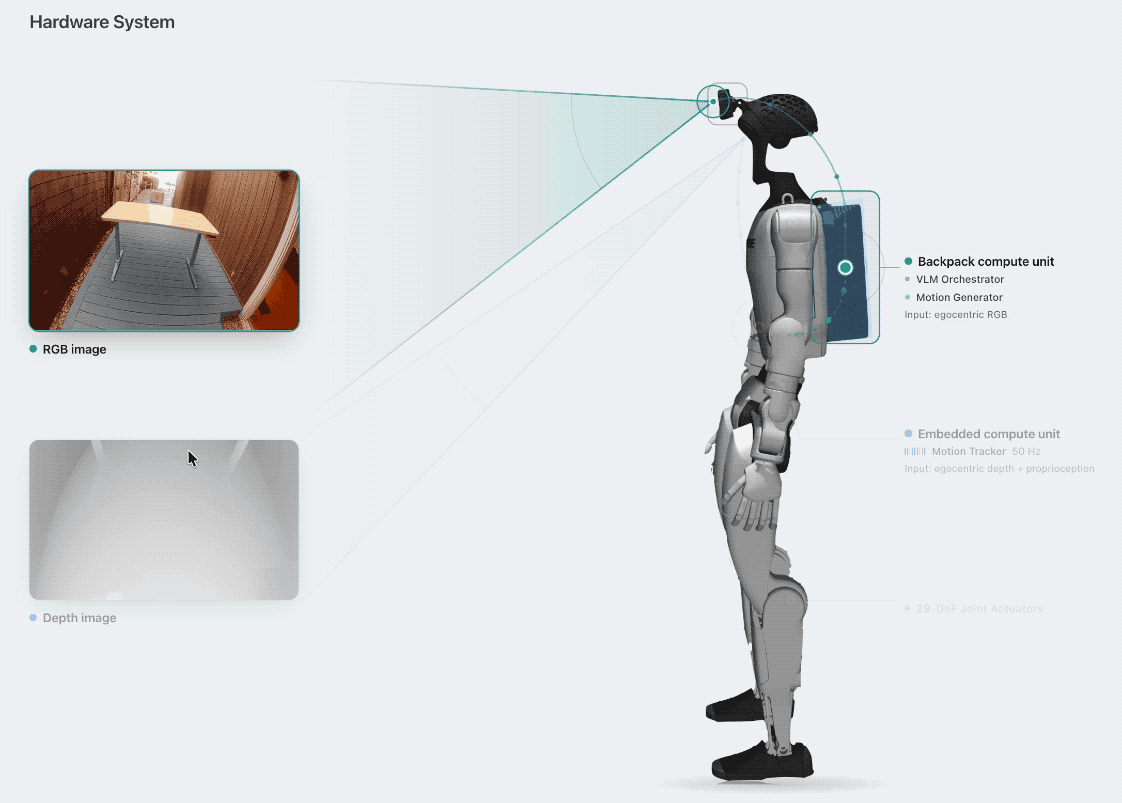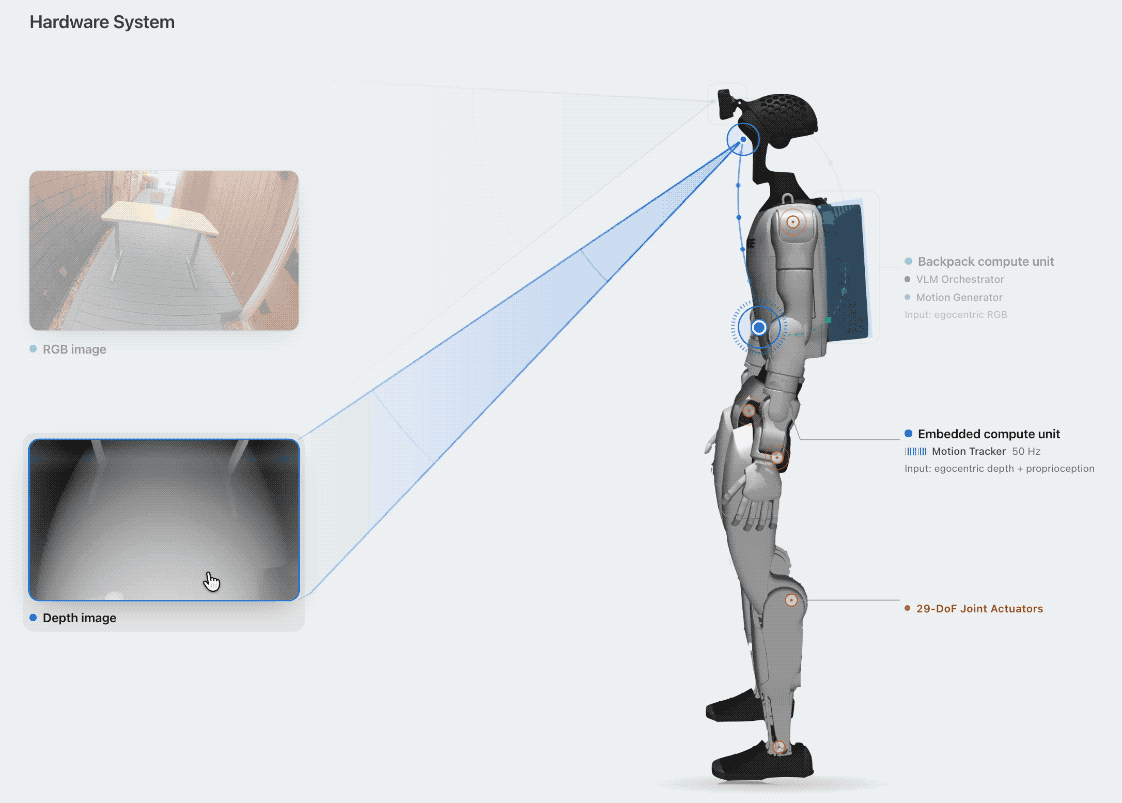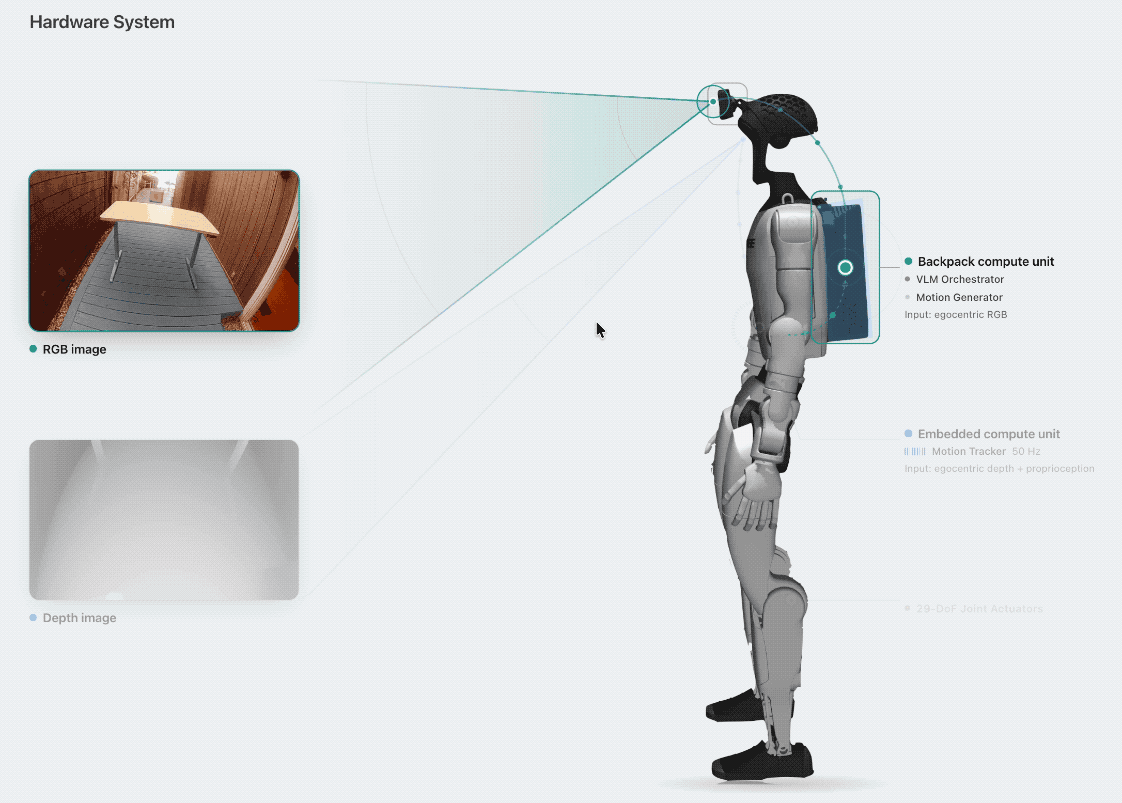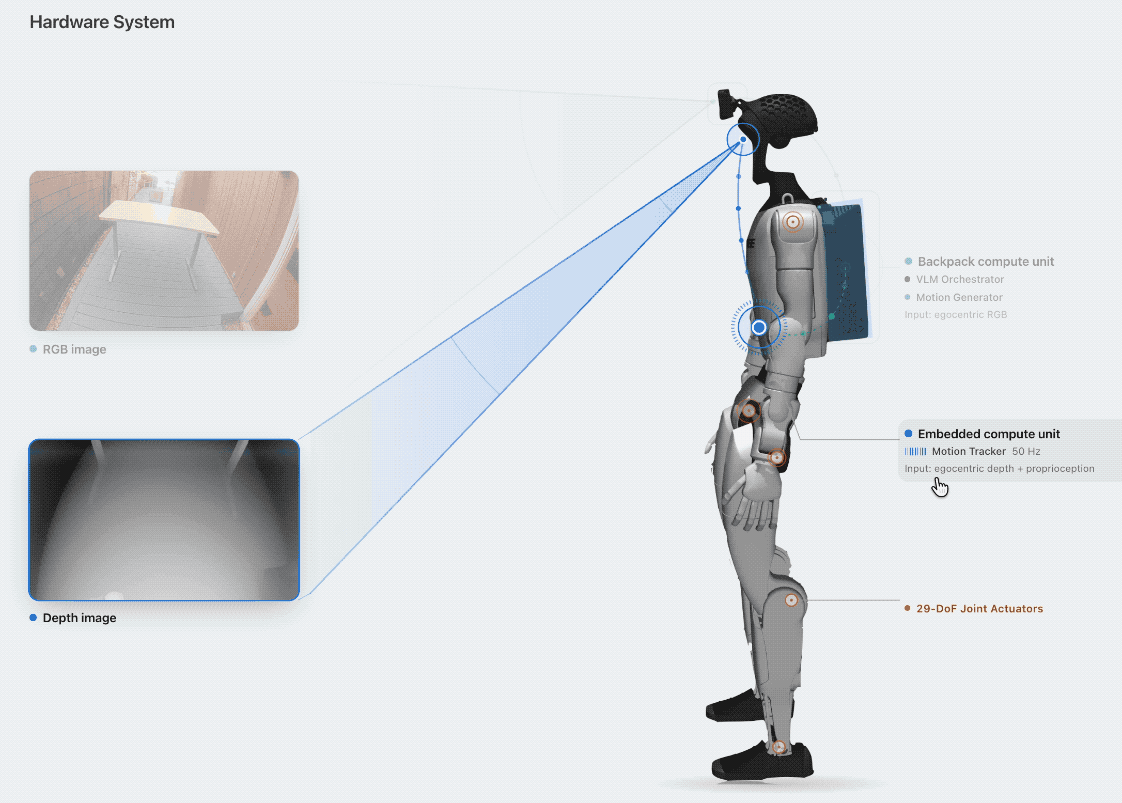
而在感知型低控制层(Perceptive low-level control),HALO引⼊了感知型的跟踪器(perceptive tracker),来弥合传统视觉传感器和跟踪器方案之间的能力差距。
苹果指出,该跟踪器集成了第⼀⼈称的深度信息,以跟踪⽣成的全⾝参考轨迹。
三、分解运动片段合成数据,任务成功率超90%
苹果同步介绍了自己生成训练用的数据的步骤。
在动作生成(Motion generation)阶段,该公司将每个任务分解为⼀系列的运动片段,每个片段将⽂本提⽰、可选的路径点(waypoint)引导,以及定义物体交互的终端关键帧姿态进行了参数化(parameterized)。
在任务“坐到扶⼿椅上”中,苹果使其分解为“向前⾛”“转⾝”和“坐到椅⼦上”三个片段。对于“向前⾛”这⼀段,该公司用路径点引导机器⼈⾛到座椅前⽅,在最终片段中,HALO确保本体以锚定在目标资产(target asset)上的坐姿关键帧完成这一动作指令。
苹果称,这种分解方案让每个任务只需要编写⼀次,就可以复⽤于其他仿真场景。

为了给运动片段构建⼀条完整的运动轨迹,苹果则为机器⼈和⽬标资产采样了有效的位置,通过⼀个⾮完整约束的单轮规划器(non-holonomic unicycle planner)来计算导航路径。
随后,该公司把⽂本与⼏何约束(路径点和关键帧)传给 KIMODO (⼀个符合运动学的动作扩散模型)。KIMODO再为每个独⽴片段⽣成稠密的全⾝运动轨迹,最终将其拼接为单⼀、连续的全局运动轨迹。
为提⾼动作的物理合理性,HALO会为每⼀段运动片段⽣成N条候选轨迹,⽤基于法正向运动学的⼏何校验器(forward-kinematics geometric)打分(检查脚部滑移、地板穿透、腾空阶段和关节限制),并保留得分最⾼的候选轨迹。
在场景搭建(Scenario staging)上,苹果利⽤INFINIGEN仿真⽣成了1000个三种不同类型、尺寸且布置不一的房间(客厅、办公室和卧室)。
然后,该公司通过采样⼆维特殊欧⼏⾥得群(Special Euclidean Group in 2D, SE(2))变换候选的方案,将合成轨迹及其⽬标资产联合嵌⼊场景,并选择接受第⼀个能避免运动轨迹、目标资产与周围家具之间碰撞的配置。
而由于每个⽚段都由随机种⼦和轻量级放置记录(a random seedand and a lightweight placement record)进行定义,因此动作⽣成与渲染实现了解耦的。
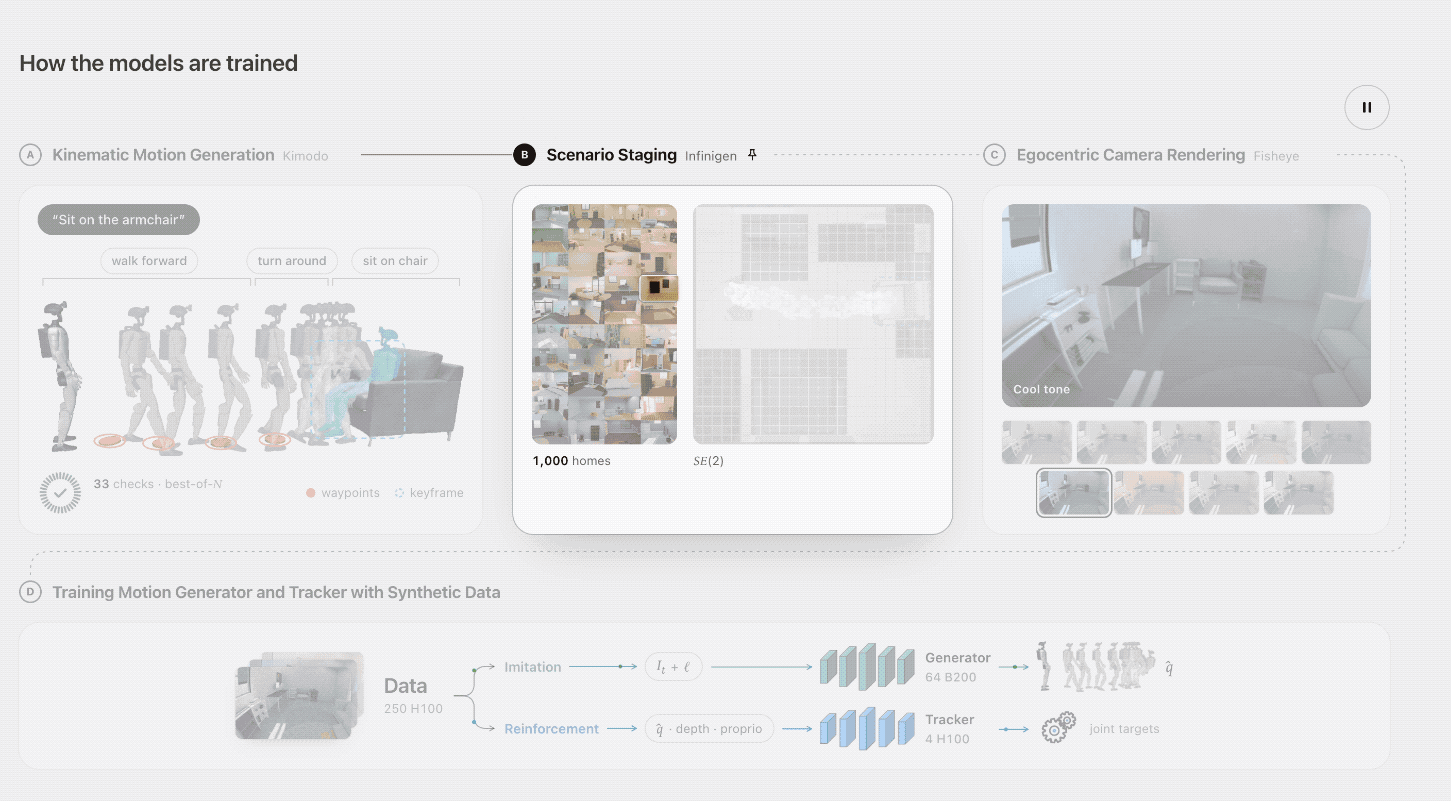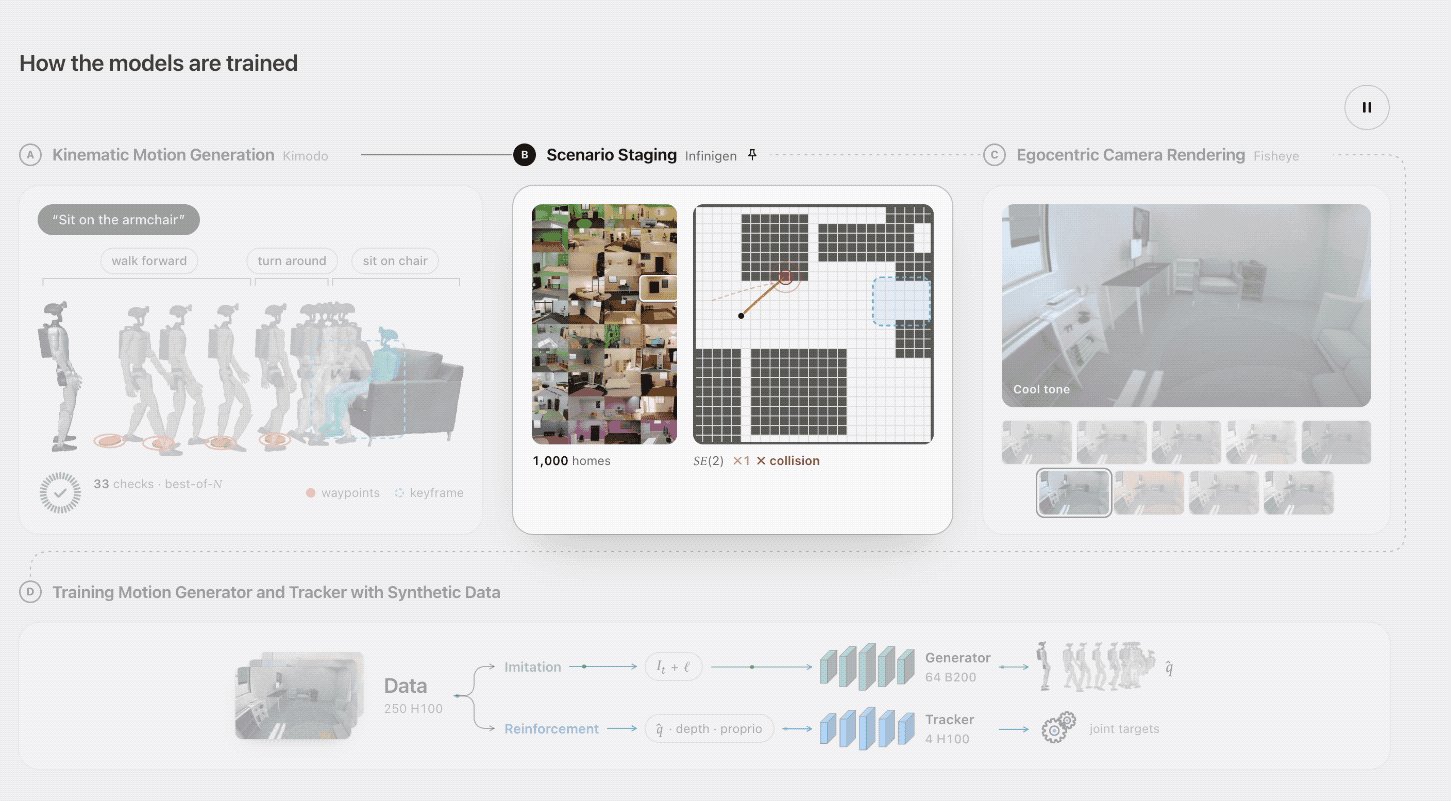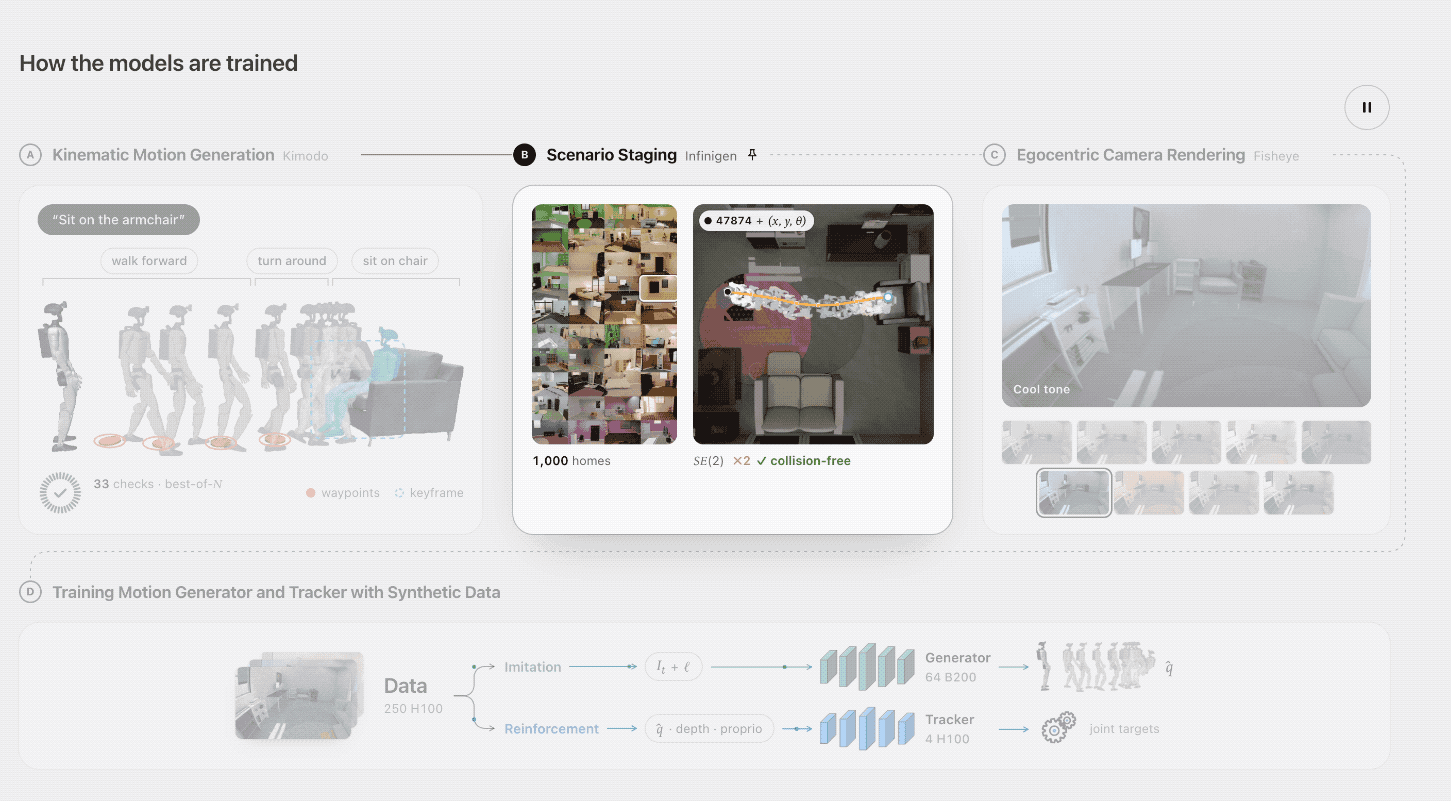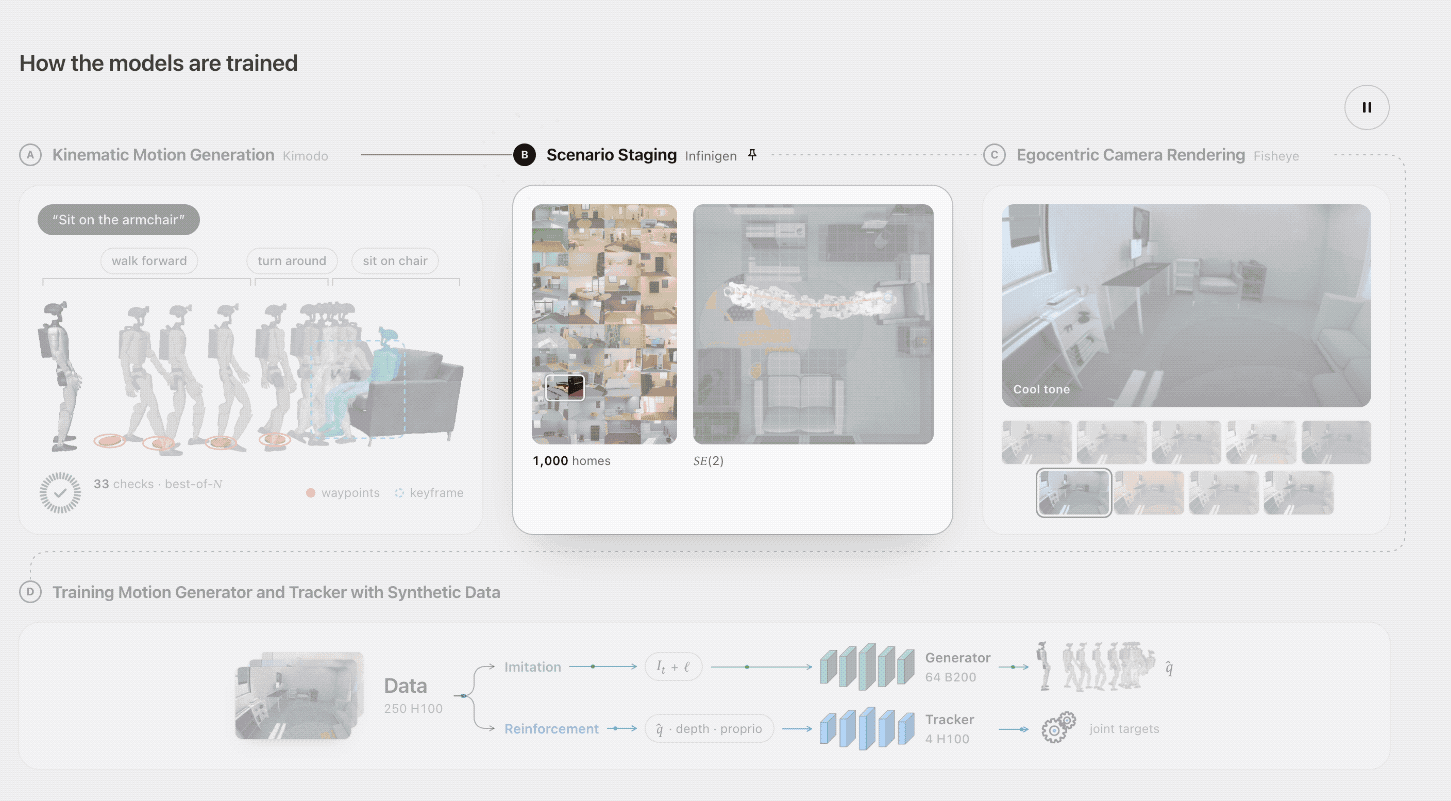
由此,苹果指出,数据库(corpus)可以在新的分辨率下、使⽤不同的相机内参,或在整个不同的物理仿真器中重新渲染,⽽⽆需重新⽣成底层的运动轨迹。

为缩⼩视觉上的仿真到现实差距,苹果采取了⼴泛的域随机化(domain randomization),让仿真场景涵盖了不同的⾊温、曝光、对⽐度、运动模糊和传感器噪声。
最后,苹果对得到的结果进行第一人称渲染(Egocentric rendering),其在INFINIGEN⽣成的场景中,以运动学⽅式重放预设的轨迹,借助与本体匹配的模拟鱼眼镜头,实现对第⼀⼈称视角视觉的渲染。
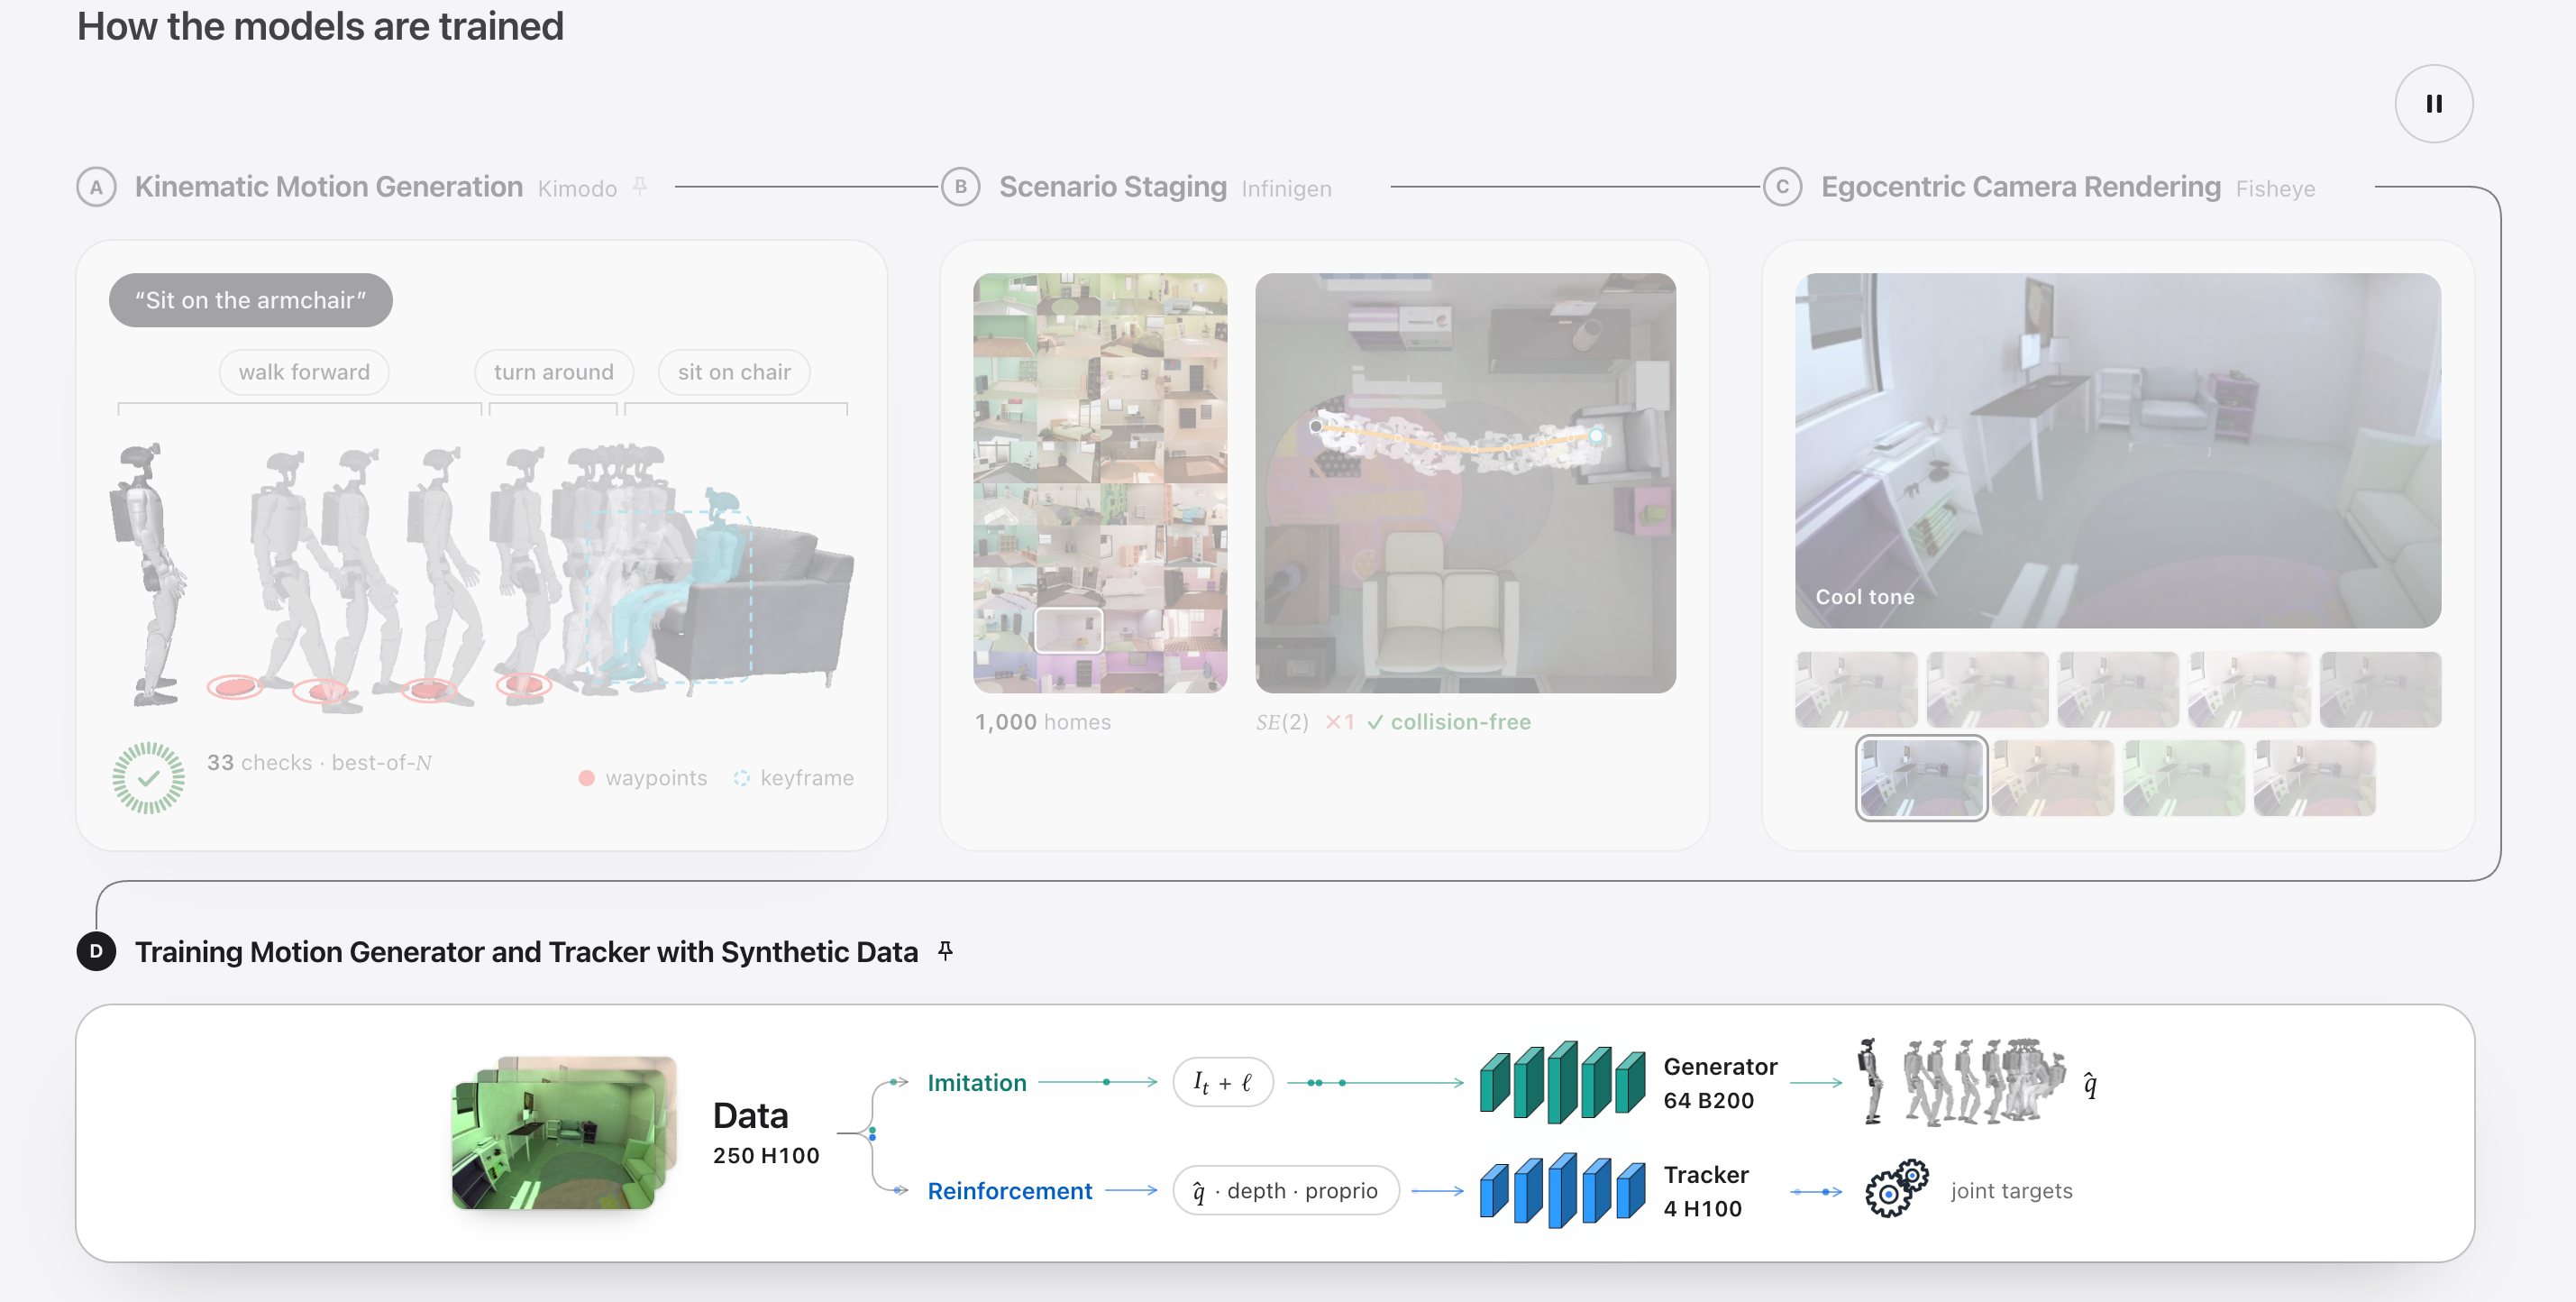
由此,苹果得到了包含近300⼩时的配对视频、语言及运动数据,覆盖了1000种不同场景。
为合成这批数据,该公司投入了250块H100GPU,并耗时48小时;运动生成器则在64块B200GPU上进行训练,运动跟踪器使用了4块H100GPU。
苹果最终展示了HALO在不同任务中的成功率:
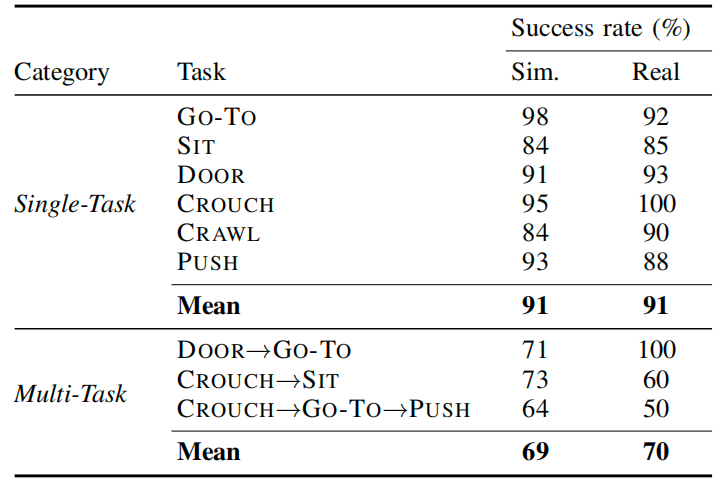
▲苹果透露,单任务评估在100个仿真场景和6个真实场景中进⾏,多任务评估使用50个仿真场景和1个真实场景。每个任务在场景中进行10次试验。单任务成功的要求是机器⼈完成任务且不摔倒、不卡住。多任务成功则要求机器人完成所有⼦任务。
苹果同时还进行了消融研究(Ablation study)。
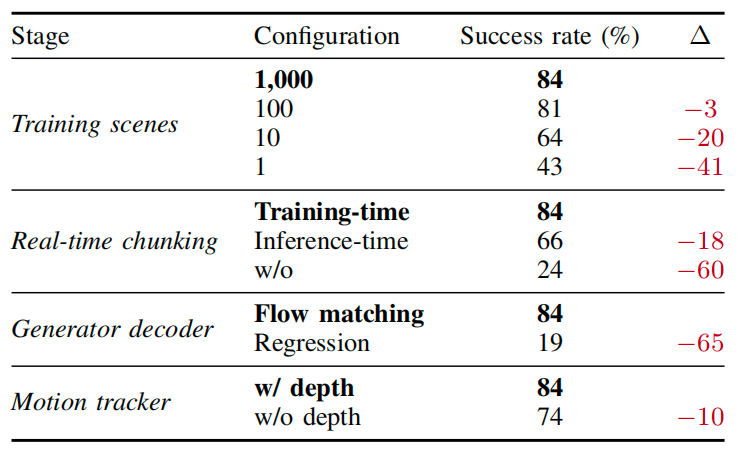
▲SIT在100个预留的仿真场景上的成功率,每个场景10次试验,粗体⾏是HALO系统,Δ是相对该设置的成功率变化。
⾸先,该公司把用于训练的仿真场景数量从1变化到100种,保持其他所有条件不变,并在全部六项任务上共同制定策略策略,发现成功率出现了急剧上升(从43%升至81%),但如果继续扩展仿真场景的数量到1000种,成功率则只会额外提升3个百分点。
其次,在没有实时分块(RTC,real-time chunking)的情况下,运动规划会在每次切换时发⽣跳变,导致成功率骤降⾄24%。
如果在推理阶段使用RTC引导梯度的平滑过渡,虽然能促进策略的连续性,但也引⼊了额外的推理延迟,仍⽐HALO采用的训练阶段条件化(training-time conditioning)方法的成功率低了18个百分点。
如果把流匹配DiT(flow-matching DiT)替换为使⽤相同Transformer⾻⼲的回归解码器,成功率又会从84%骤降⾄19%。
最后,如果保持其他条件不变,移除HALO对深度信息的感知能力,只剩下本体感知的信息后,其任务成功率将会降低10个百分点。
四、编码器用了千问模型,生成器采用异步生成方式运行
苹果还介绍了其运动生成器(Motion generator training)和运动跟踪器(Motion tracker training)是如何训练的。
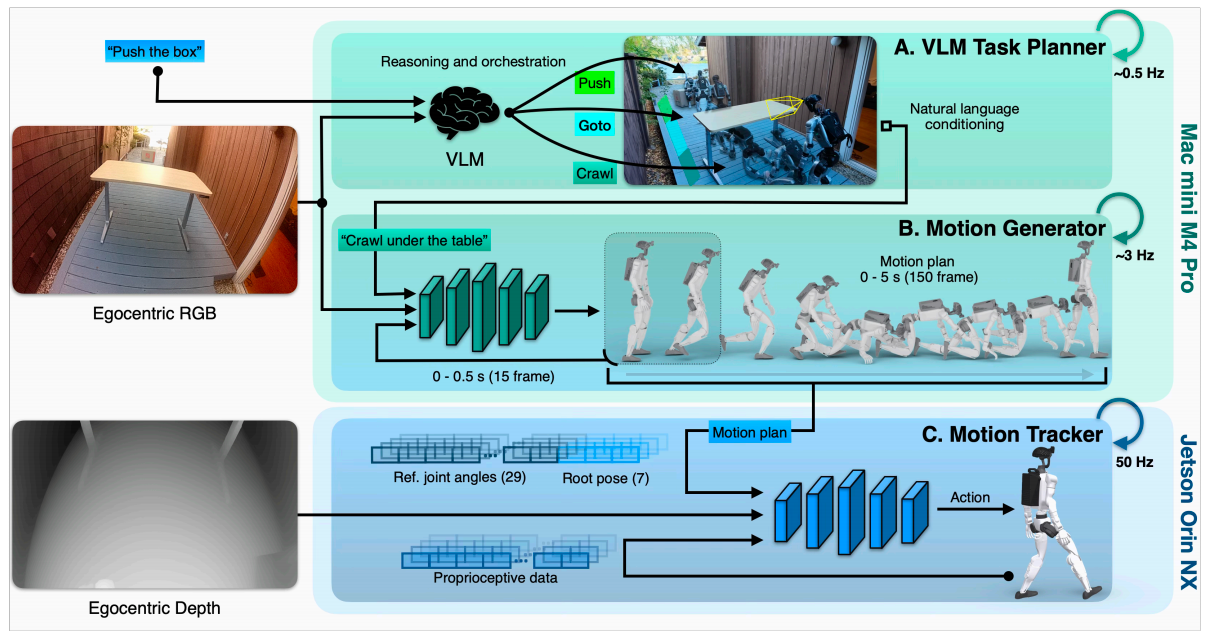
运动⽣成器以第⼀⼈称RGB图像和语⾔指令为输⼊,在H=150帧的时域上输出完整的运动轨迹。
HALO会在每⼀帧将29个关节⾓度,和一个3D⾻盆平移量以及4D⾻盆四元数堆叠在⼀起(3D pelvis translation and a 4D pelvis quaternion),⼆者都以时刻t的⾻盆坐标系为参照表⽰,因此其输出对全局的位置不会产生变化。
据苹果介绍,其运动⽣成器采用了⾮对称编码器—解码器结构(asymmetric encoder-decoder),其中编码器是Qwen3.5-2B VLM。
解码器则是⼀个扩散Transformer架构的模型(diffusion transformer,DiT),苹果对其进行了从头训练(8个区块、宽度为512,有8个注意⼒头,8 blocks,width 512,8 heads)。
该解码器以VLM特征嵌⼊为输⼊,⽣成稠密的全⾝运动轨迹。苹果表示,其通过流匹配(flow matching)进行训练,推理时则使⽤15步的欧拉(Euler)采样。
苹果还在生成器上采用了异步生成(Asynchronous generation)的运行方式,系统会在跟踪器执⾏当前轨迹的同时,计算下⼀条运动轨迹。
而为了防止切换轨迹时出现运动学抖动,苹果并没有采用实时分块的方法,改为采⽤训练时条件化的方式。
机器⼈会确认执⾏的前P=15帧(0.5秒)作为⼲净、⽆噪声的token直接传⼊⽣成器。这些token占据序列的前P帧,模型只对剩余的H−P=135帧(4.5秒)去噪。
苹果指出,由于训练⽬标是严格补全给定的前缀,模型因此在原⽣层⾯内化了策略的连续性。
由此,该公司认为,平滑的运动学过渡成为了⽹络的固有属性,⽽不是成本更大的推理时补丁(costly inference-time patch),新的运动轨迹能够持续流式传输给低层跟踪器。
在跟踪器的训练上,该公司分三个阶段进行训练:
- 训练具有优先权的单技能专家(training privileged single-skill experts);
- 将它们蒸馏为⼀个统⼀的、基于深度信息的学⽣模型(distilling them into a unified depth-based student);
- 通过强化学习进⾏微调,并加⼊执⾏器建模和域随机化,以实现具备鲁棒性的sim-to-real迁移。(fine-tuning via reinforcement learning with actuator modeling and domain randomization for robust sim-to-real transfer)
具体来讲,苹果首先为每项不同技能训练⼀个专⽤的近端策略优化(Proximal Policy Optimization, PPO)专家,这些专家在该公司合成的动作轨迹以及重定向到Unitree G1的LAFAN1⼈体运动⽚段上训练。
其次,该公司把专家蒸馏为⼀个单⼀学⽣策略,该学⽣只以本体的(onboard)输⼊为策略执行条件,包括运动规划、第⼀⼈称深度信息、本体感知信息和IMU。在蒸馏期间,每个仿真实例都由对应的专家模型进行监督。
最后,该公司直接在学⽣策略上应⽤强化学习,并在回路中保留深度信息。为了解决不同技能之间奖励尺度的差异,该公司采用了多评价器的近端策略优化(multi-critic PPO),即在共享同一个行动器(actor)的同时,每项技能都拥有一个独⽴的评价器(critic)。
在解决sim-to-real的迁移上,苹果显式建模了执⾏器的物理特性。为了实现长程任务的编排(Orchestration for long-horizon tasks),该公司则在系统栈顶部加⼊了⼀个基于VLM的任务编排器。
默认情况下,编排器在机器⼈本体的Mac mini上运⾏,使⽤Qwen3.6-35B-A3B(4 ⽐特量化,MLX),并与运动⽣成器共享同⼀个服务引擎,从⽽⽀持机器人在⽆网络的情况下运⾏。
苹果指出,也可以选择通过API将请求路由到前沿的闭源云端模型,以获得更强的推理与规划能⼒。
结语:数据之外,系统能力成为新考题
HALO在一定程度上证明了仿真数据引擎的可行性,展示了一条可扩展的训练路径。
但目前来看,91%的成功率仍建立在有限技能和较短任务链上,面对开放环境、复杂接触与更长程任务,HALO的能力边界仍待验证。
换句话说,随着仿真数据引擎与数据采集产业链不断成熟,数据在“量”上的短板有望逐步补齐。届时,如何让机器人更好地理解和规划任务、稳定地完成真机部署,并落地到具体场景,将成为更为关键的考验。
github:https://apple-aiml-research.github.io/ml-halo/#cite
论文:https://arxiv.org/abs/2611.06908
